


Polars怎么和pandas互相转换DataFrame?
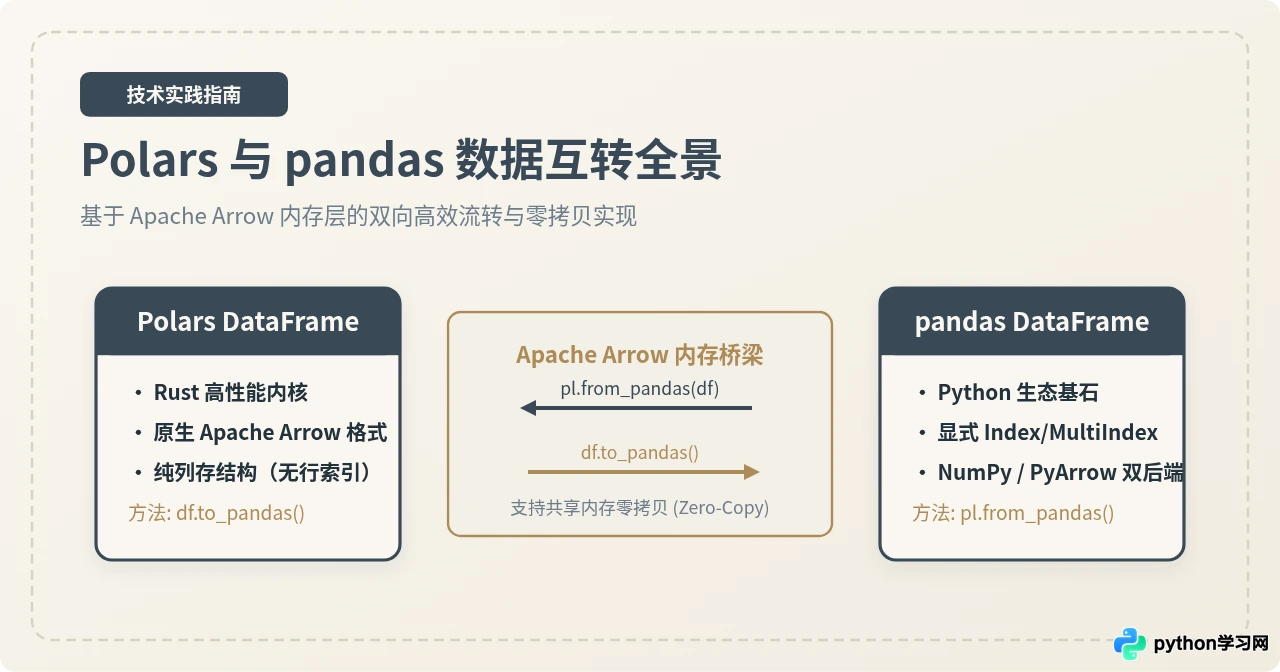
全面讲解Polars与pandas双向互转DataFrame的具体方法、底层Apache Arrow零拷贝机制、索引与空值处理避坑指南及最佳实践。
df_polars.to_pandas(),从 pandas 转到 Polars 调用 pl.from_pandas(df_pandas)。两者之间依托 Apache Arrow 作为标准列式内存协议。掌握这两个转换方法、合理选择 use_pyarrow_extension_array 与 include_index 参数,并处理好行索引、空值和数据类型的映射差异,就能在生产环境中高效打通两者的数据流转。
一、快速入门:双向互转核心方法与环境准备
在 Python 数据分析与工程中,Polars 凭借 Rust 内核的多线程并发和基于 Apache Arrow 的列式内存模型,具备极高的处理吞吐量;而 pandas 则拥有深厚的用户基础与庞大的机器学习生态(例如 scikit-learn、Statsmodels 以及各类专用可视化库)。在许多实际项目中,常见的架构模式是用 Polars 快速完成大规模数据的清洗、聚合与过滤,随后将其转换为 pandas DataFrame 交由下游模型库训练。
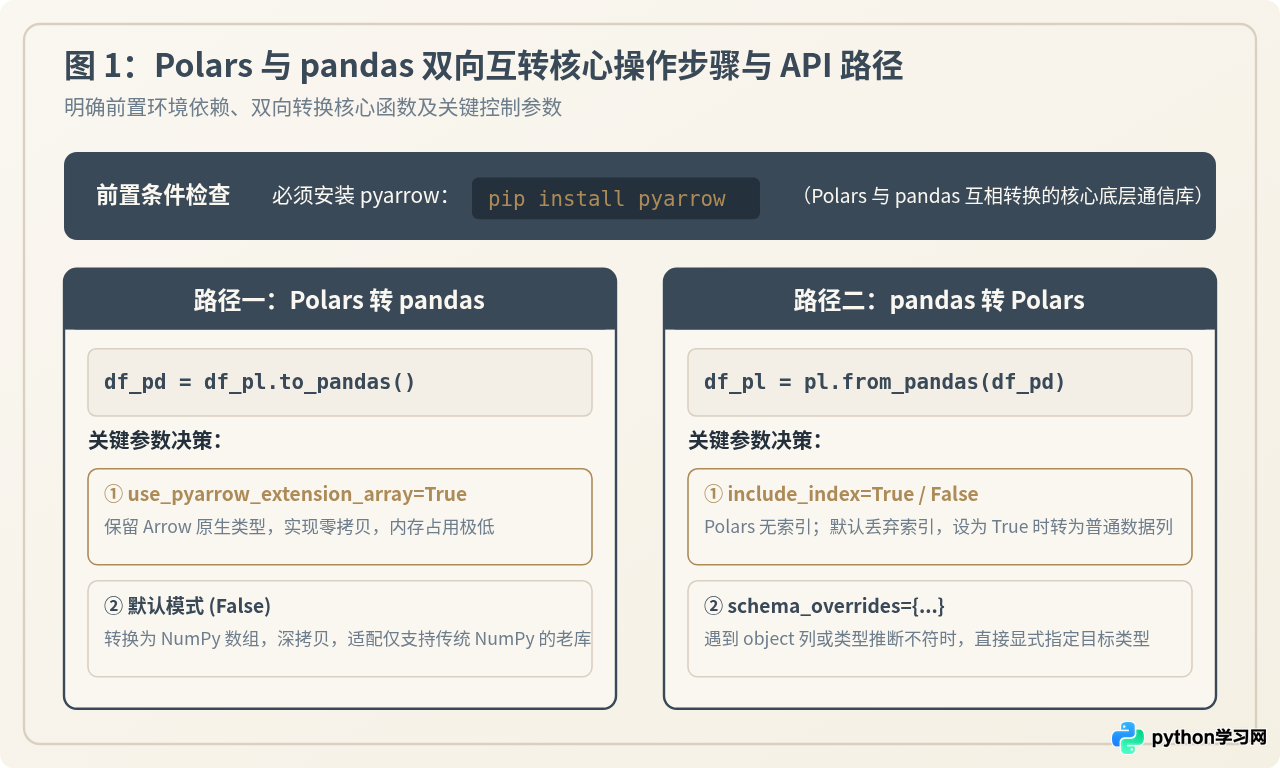
Polars 与 pandas 之间的桥梁是 Apache Arrow。在执行互转之前,Python 环境中必须安装 pyarrow 库。如果缺失该库,调用转换方法时将抛出 ModuleNotFoundError 或提示安装 Arrow 相关的可选依赖。可以通过以下命令安装:
pip install pyarrow polars pandas
1. Polars DataFrame 转换为 pandas DataFrame
当数据在 Polars 中处理完毕后,直接调用其实例方法 to_pandas() 即可返回一个标准的 pandas DataFrame。
import polars as pl

# 1. 创建示例 Polars DataFrame
df_pl = pl.DataFrame({
    "id": [1, 2, 3],
    "city": ["北京", "上海", "广州"],
    "score": [92.5, 88.0, 95.0]
})

# 2. 转换为 pandas DataFrame
df_pd = df_pl.to_pandas()

print("类型:", type(df_pd))
print(df_pd)
2. pandas DataFrame 转换为 Polars DataFrame
当从数据库或既有数据处理函数接收到 pandas DataFrame 时,推荐使用 pl.from_pandas() 函数将其转换为 Polars DataFrame。也可以直接使用 pl.DataFrame(df_pandas) 构造器,但在工程代码中,pl.from_pandas() 具有更明确的语义并提供了专属控制参数。
import pandas as pd
import polars as pl

# 1. 创建示例 pandas DataFrame
df_pd = pd.DataFrame({
    "product": ["A", "B", "C"],
    "price": [19.9, 29.9, 49.9],
    "stock": [100, 250, 80]
})

# 2. 转换为 Polars DataFrame
df_pl = pl.from_pandas(df_pd)

print("类型:", type(df_pl))
print(df_pl)
二、深入内存机制:零拷贝与内存复制
在处理数千万行甚至数 GB 的数据集时,数据转换的耗时与内存占用是决定系统稳定性的关键指标。许多开发者常有疑问:转换时是否会把整份数据重新拷贝一份? 答案取决于目标 pandas 使用的底层后端。
1. 零拷贝模式(Zero-Copy)
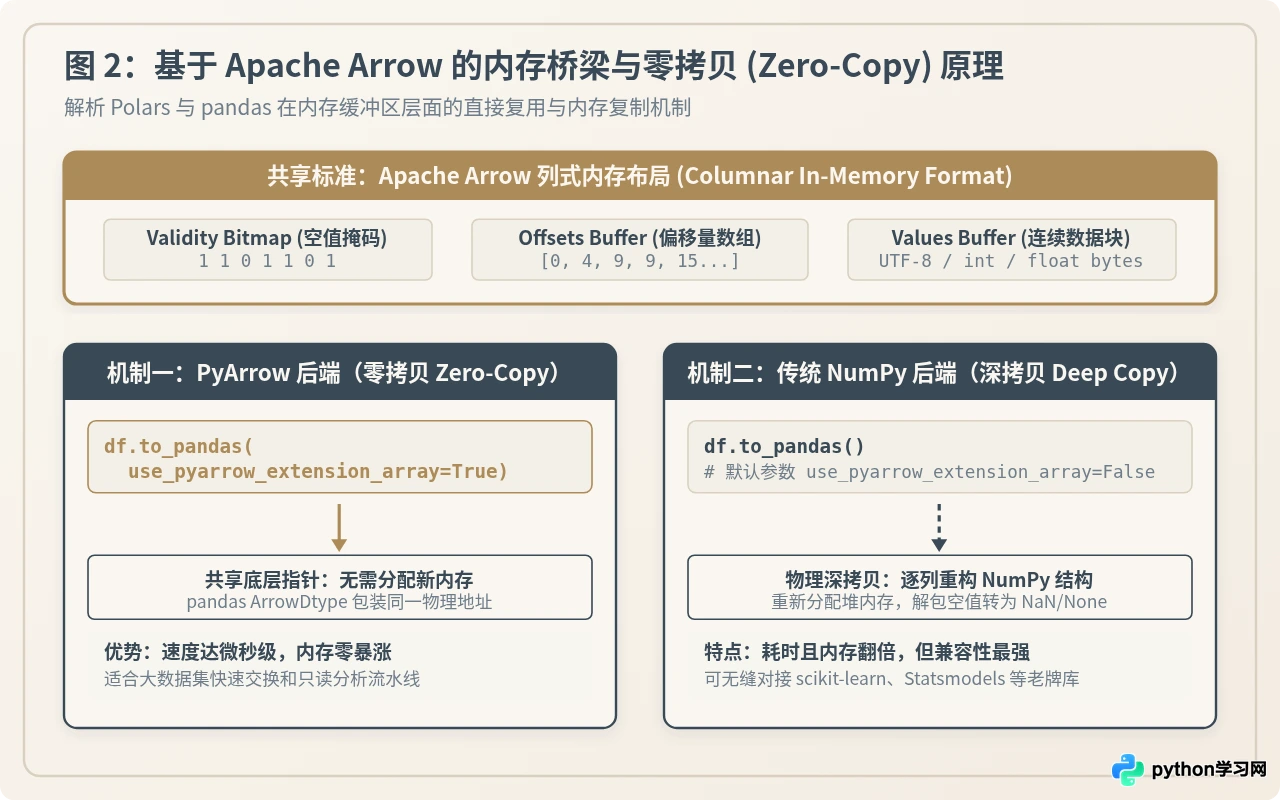
Polars 在底层完全遵循 Apache Arrow 内存规范。若下游接收方同样支持 Arrow 格式,两个库就可以直接共享底层的内存地址指针,而不需要重新分配内存、拷贝每一个字节。这被称为零拷贝(Zero-Copy)。
在 Polars 中,要开启零拷贝转换,只需在调用 to_pandas() 时传入参数 use_pyarrow_extension_array=True:
import polars as pl

df_pl = pl.DataFrame({
    "metric_a": [10, 20, 30],
    "metric_b": ["x", "y", "z"]
})

# 启用 PyArrow Extension Array 后端
df_pd_arrow = df_pl.to_pandas(use_pyarrow_extension_array=True)

print(df_pd_arrow.dtypes)
此时生成的 pandas DataFrame 各列类型为 int64[pyarrow] 和 string[pyarrow]。数据缓冲区(Buffers)直接由 Polars 和 pandas 共享引用计数。哪怕处理千万级规模的数据,转换耗时通常也在毫秒以内,且物理内存不会翻倍。
2. 传统深拷贝模式(Deep Copy)
如果在调用 df_pl.to_pandas() 时不添加参数(默认 use_pyarrow_extension_array=False),pandas 将使用传统的 NumPy 数组后端。由于 NumPy 与 Arrow 的内存布局存在本质差异(例如 NumPy 缺乏原生独立空值位掩码,字符串依赖 Python 对象指针数组),Polars 必须遍历所有列并将数据重新排列构造成 NumPy 数组。
这意味着会触发深拷贝(Deep Copy):转换过程中系统需要额外申请一份与原数据集等大的内存空间。如果物理内存已经接近极限,深拷贝很可能直接引发 OOM(Out Of Memory 内存溢出)崩溃。
三、关键差异与转换细节避坑
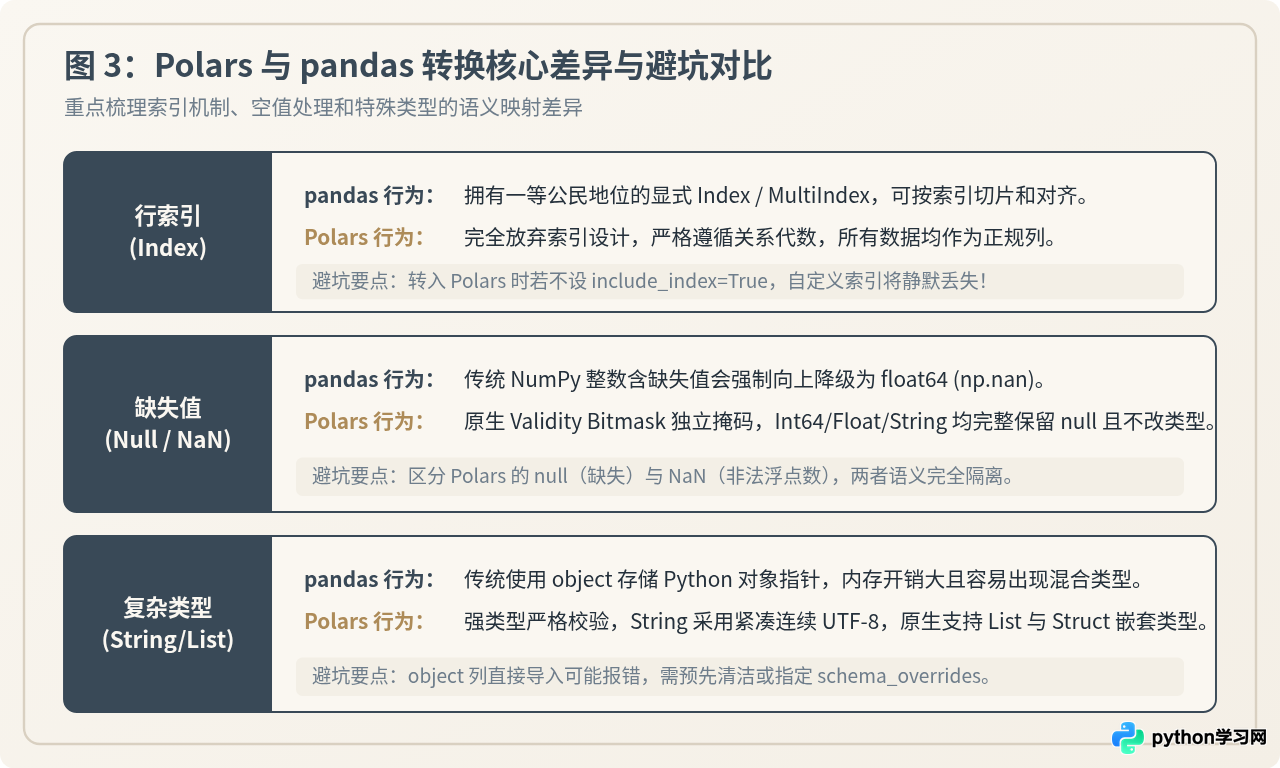
由于 Polars 与 pandas 在架构设计理念上的不同,直接互转时存在几个极为常见但隐蔽的“坑”。在编写数据流水线时必须提前预防。
1. 行索引机制(Index)的差异
核心差异: pandas 依赖显式的行索引(Index 和 MultiIndex),许多数据清洗逻辑(如 loc、按时间对齐、按分组索引切片)都强依赖索引;而 Polars 严格遵循现代关系代数体系,完全放弃了行索引设计,所有属性均必须是普通数据列。
在从 pandas 转换至 Polars 时,如果原 pandas DataFrame 带有具名的业务索引(如时间戳索引 DatetimeIndex),默认情况下 pl.from_pandas() 会直接丢弃该索引!
import pandas as pd
import polars as pl

df_pd = pd.DataFrame(
    {"sales": [120, 230, 310]},
    index=pd.date_range("2026-01-01", periods=3, name="date")
)

# 默认转换:date 索引被丢弃
df_lost = pl.from_pandas(df_pd)
print("默认转换(索引丢失):
", df_lost)

# 正确做法:设置 include_index=True
df_keep = pl.from_pandas(df_pd, include_index=True)
print("
保留索引转换:
", df_keep)
2. 缺失值与数值类型变动(Null 与 NaN)
在传统基于 NumPy 的 pandas 中,由于整数类型不支持 np.nan,当整数列包含缺失值时,pandas 会被迫将整列数据从 int64 强制提升为 float64。
而在 Polars 中,所有列类型(无论整数、浮点数还是字符串)都拥有原生的 Validity Bitmask(有效性位掩码)。整数列包含 null 时仍能保持纯粹的 Int64 类型,既节省一半内存,又杜绝了浮点转换带来的大整数精度损失。
如果将包含 null 的 Polars 整数列通过默认 df.to_pandas() 导出,为了兼容 NumPy,它会被强转为 pandas 的 float64(其中的 null 变为 NaN)。如果你需要保留整数类型和空值,请务必启用 use_pyarrow_extension_array=True,此时将映射为 pandas 的 int64[pyarrow],完美保留空值且不损失精度。
3. 复杂类型与 object 列的处理
pandas 中广泛存在的 object 列通常存储着混杂的 Python 字符串、数字或字典。而 Polars 属于严格强类型系统,要求每一列必须有明确且唯一的 Arrow 数据类型。
如果 pandas DataFrame 的某一列中混合了字符串与数字(例如既有 "123" 又有数字 456),在调用 pl.from_pandas() 时可能触发类型推断异常。遇到这种情况,推荐使用 schema_overrides 参数显式指定 Polars 应该将其视为什么类型:
import pandas as pd
import polars as pl

df_pd = pd.DataFrame({
    "code": ["001", "002", "003"],
    "notes": ["ok", "pending", None]
})

# 显式覆盖推断类型,强制将 code 和 notes 规范为 String 类型
df_pl = pl.from_pandas(
    df_pd,
    schema_overrides={"code": pl.String, "notes": pl.String}
)
print(df_pl.schema)
四、常见问题排查与工程实践建议
1. 常见报错及排查方案
| 报错表现 | 根本原因 | 具体解决方法 |
|---|---|---|
ModuleNotFoundError: No module named 'pyarrow' |
环境中未安装底层 Arrow 转换驱动库。 | 在当前 Python 环境执行 pip install pyarrow。 |
ArrowInvalid: Could not convert... |
pandas 列中包含不兼容的混合对象或不支持序列化的 Python 对象。 | 在转换前使用 df[col] = df[col].astype(str) 规范格式,或在 pl.from_pandas() 中传入 schema_overrides。 |
| 转换后原有时间戳索引消失,只剩数值 0, 1, 2... | 未开启 include_index=True,Polars 丢弃了 pandas 默认行索引。 |
改为调用 pl.from_pandas(df, include_index=True)。 |
| 大表转换时 Python 进程直接崩溃 (OOM Killed) | 默认 to_pandas() 触发了整表内存深拷贝,瞬时内存超出上限。 |
启用 use_pyarrow_extension_array=True 实现零拷贝;或在 Polars 中先做行过滤与列剪裁再转换。 |
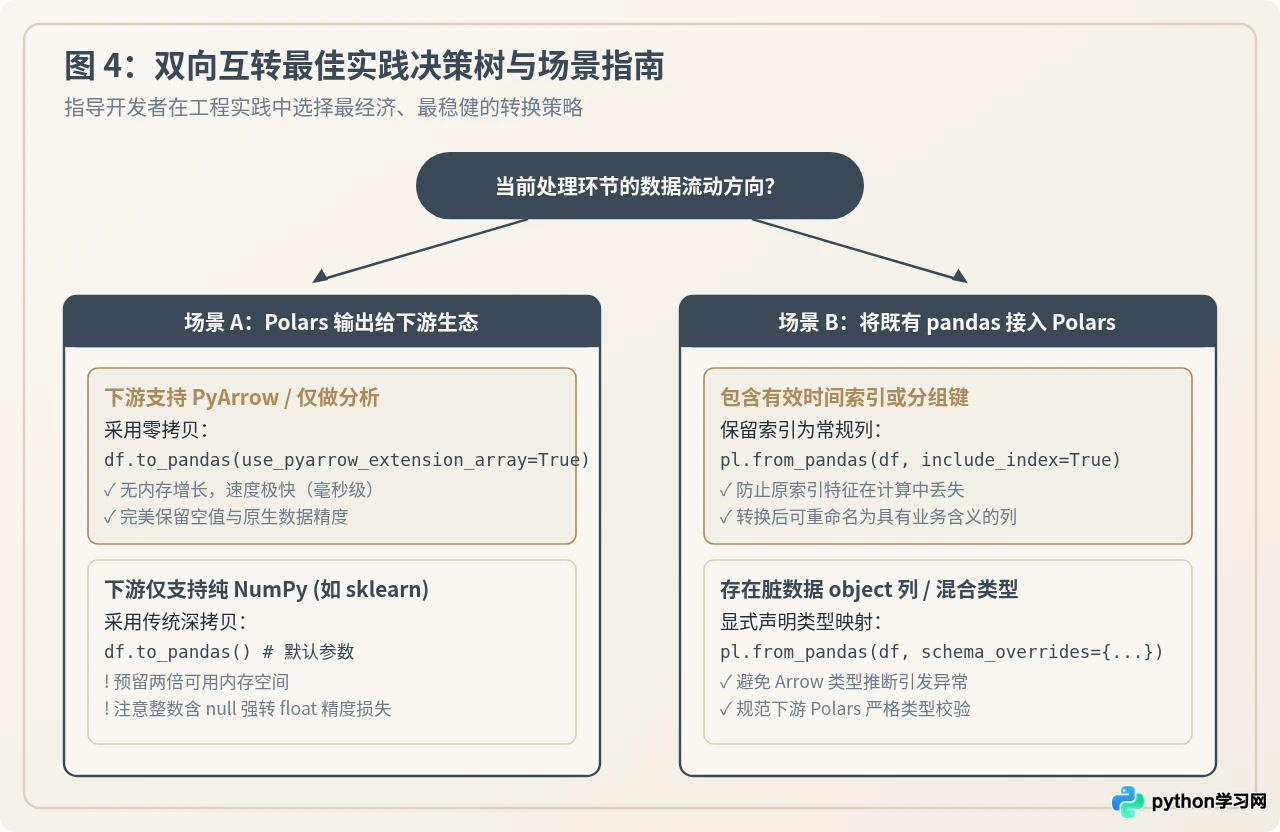
2. 生产环境最佳实践决策树
在实际工程开发中,推荐遵循以下准则来决定转换策略:
- 尽可能晚转换: 充分发挥 Polars 懒加载执行计划(LazyFrame)和多核并发计算的优势,将过滤、分组聚合、连接等耗费算力的步骤全部在 Polars 中完成后,仅在最后一步将精简后的数据转给下游。
- 优先选用零拷贝参数: 若下游仅需读取数据或直接接入支持 Arrow 的组件(如 Streamlit、DuckDB、Modern pandas),始终优先使用
to_pandas(use_pyarrow_extension_array=True)。 - 注意模型库兼容性: 若下游是较老版本的 scikit-learn、XGBoost 或特定绘图库,它们可能依赖原生 NumPy 矩阵,此时需要使用默认的
df.to_pandas(),并在转换前评估剩余可用物理内存。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















