


Python元组与列表的区别:何时该用元组?
深入解析Python元组(tuple)与列表(list)的核心区别,从可变性、底层内存分配、执行效率到可哈希性全面对比,提供清晰的工程选型决策流程与避坑指南。
一、核心机制对比:可变性与语法语义
初学 Python 时,很多人容易将元组和列表看作“只是括号不同”的同类容器:列表用方括号 [1, 2, 3],元组用圆括号 (1, 2, 3)。但这两者在设计哲学和语法机制上有着本质分工。
列表属于可变序列(Mutable Sequence)。在对象创建之后,你可以随时通过 append()、extend()、insert() 增加元素,通过 pop() 或 remove() 删除元素,或者直接通过索引进行就地修改 lst[0] = 99。列表的内存指针保持不变,但容器内容发生了变化。
元组属于不可变序列(Immutable Sequence)。一旦创建完成,元组的长度和内部存储的引用就严格固定下来。任何试图赋值 tup[0] = 99 的操作都会立即引发 TypeError: 'tuple' object does not support item assignment。虽然不能修改,但元组支持常规的序列操作,例如索引访问、切片读取、成员判断(in)以及遍历循环。
在设计语义上,Python 社区形成了清晰的惯例约定:
- 列表通常用于同构数据(Homogeneous Data):列表内的每个元素通常代表同类实体,例如用户列表
users = ["Alice", "Bob", "Charlie"]或温度传感器读数temperatures = [21.5, 22.0, 21.8]。元素之间的数量随时可变。 - 元组通常用于异构数据(Heterogeneous Data)或结构化记录:元组的每个位置往往承担特定的字段含义。例如二维平面坐标
point = (10, 20)、数据库查询结果record = (101, "admin", "active")。各个位置的数据类型可以不同,位置本身就代表了数据的结构。
二、底层原理:内存分配与执行效率
不可变性不仅带来了语义上的安全性,更为底层 CPython 解释器提供了深度的内存和性能优化空间。
对于列表,由于必须支持频繁的元素追加,CPython 采用了超额分配机制(Over-allocation)。当列表容量填满时,解释器会额外分配一块更大的连续内存空间,以保证均摊时间复杂度为 \(O(1)\)。这意味着列表对象内部维护着两个核心字段:实际元素个数(ob_size)和已分配槽位数(allocated),并且始终存在闲置槽位的内存开销。
相比之下,元组在创建时长度完全固定。CPython 为其分配恰好容纳所需元素数量的紧凑内存块,无需保留任何空闲槽位。此外,对于小元组(长度小于等于20),CPython 内部实现了一个空闲链表缓存池(free_list),销毁小元组时不会立即归还内存给操作系统,而是留在缓存链表中直接供下一次新建元组复用,极大降低了系统调用的开销。
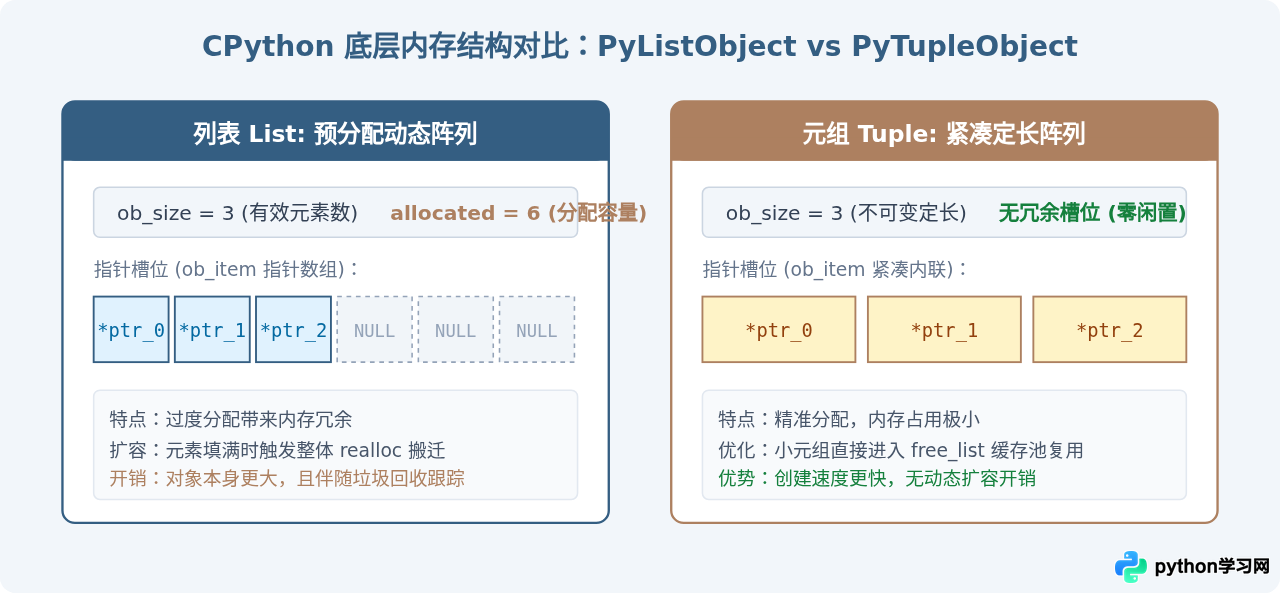
我们可以使用标准库模块 sys 直观验证两者的内存字节数差异:
import sys

# 长度相同的空容器对比
empty_list = []
empty_tuple = ()
print("空列表字节数:", sys.getsizeof(empty_list))   # 示例输出: 56 字节 (CPython 64位)
print("空元组字节数:", sys.getsizeof(empty_tuple))  # 示例输出: 40 字节

# 包含相同 5 个整数的容器对比
nums_list = [1, 2, 3, 4, 5]
nums_tuple = (1, 2, 3, 4, 5)
print("5元素列表字节数:", sys.getsizeof(nums_list))   # 示例输出: 120 字节 (含预留槽位)
print("5元素元组字节数:", sys.getsizeof(nums_tuple))  # 示例输出: 80 字节
除了静态存储开销,在循环中大量实例化短期存在的小数据包时,元组的构造速度明显快于列表,这对于高性能计算、高频网络请求解析等场景具有实在的优化意义。
三、映射应用:可哈希性与字典键的边界
在 Python 中,字典(dict)与集合(set)基于哈希表(Hash Table)实现。要成为字典的键或集合中的元素,该对象必须是可哈希的(Hashable)。
所谓可哈希,要求对象在整个生命周期内具有不可变的哈希值(通过 __hash__() 获取),并且可以与其他对象进行相等性比较(通过 __eq__())。
由于列表随时可能被修改,如果允许可变对象作为键,一旦修改其内容,计算得到的哈希值就会改变,哈希表将再也无法根据旧哈希值定位到原有的槽位,导致映射关系彻底崩塌。因此,Python 明确规定:列表是不可哈希的,尝试将列表传给 hash() 会触发异常。
# 尝试将列表作为字典键
user_coords = {[10, 20]: "BaseStation"}
# 抛出异常: TypeError: unhashable type: 'list'

# 使用元组作为字典键 (完全合法)
user_coords = {(10, 20): "BaseStation"}
print(user_coords[(10, 20)])  # 输出: BaseStation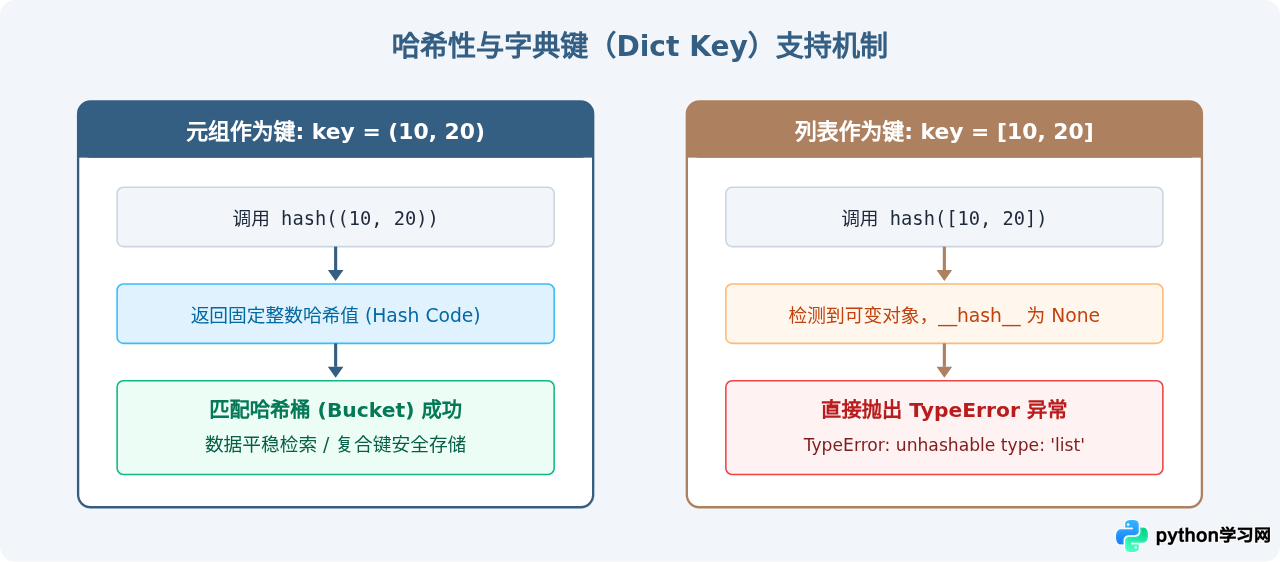
bad_tup = (1, [2, 3])),虽然不能替换该槽位的列表指针,但列表内部的元素仍可被修改(如 bad_tup[1].append(4))。此时该元组整体变为不可哈希,调用 hash(bad_tup) 同样会抛出 TypeError。
四、工程意图与防御性编程
在大型工程或团队协作中,选用元组还是列表不仅关乎能否运行,更是向代码阅读者传达设计意图的重要媒介。
1. 函数多项结果解包与参数传递
Python 中函数返回多个值时,语法表面上是用逗号隔开,底层默认打包为一个元组。这种设计的核心目的就是防止调用方在后续处理中意外篡改返回结果的原始关联结构:
def get_user_status(user_id: int):
    # 逻辑处理...
    return "active", 200, "OK"  # 隐式返回一个元组 ("active", 200, "OK")

status, code, msg = get_user_status(1)
2. 防止下游函数的副作用(Side Effects)
在 Python 中,对象是按引用传递的。如果一个模块将自己的内部列表直接作为参数传递给外部函数,外部函数如果不慎调用了 append() 或 sort(),原列表的数据就会被意外污染,产生难以排查的隐蔽 Bug。
如果业务数据在传递后不应被修改,将数据转换为元组传递出去,是一种成本极低、执行高效的防御性编程(Defensive Programming)手段。
五、何时该用元组?选型决策推导
在编写实际业务代码时,可以通过以下推导流程快速决断:
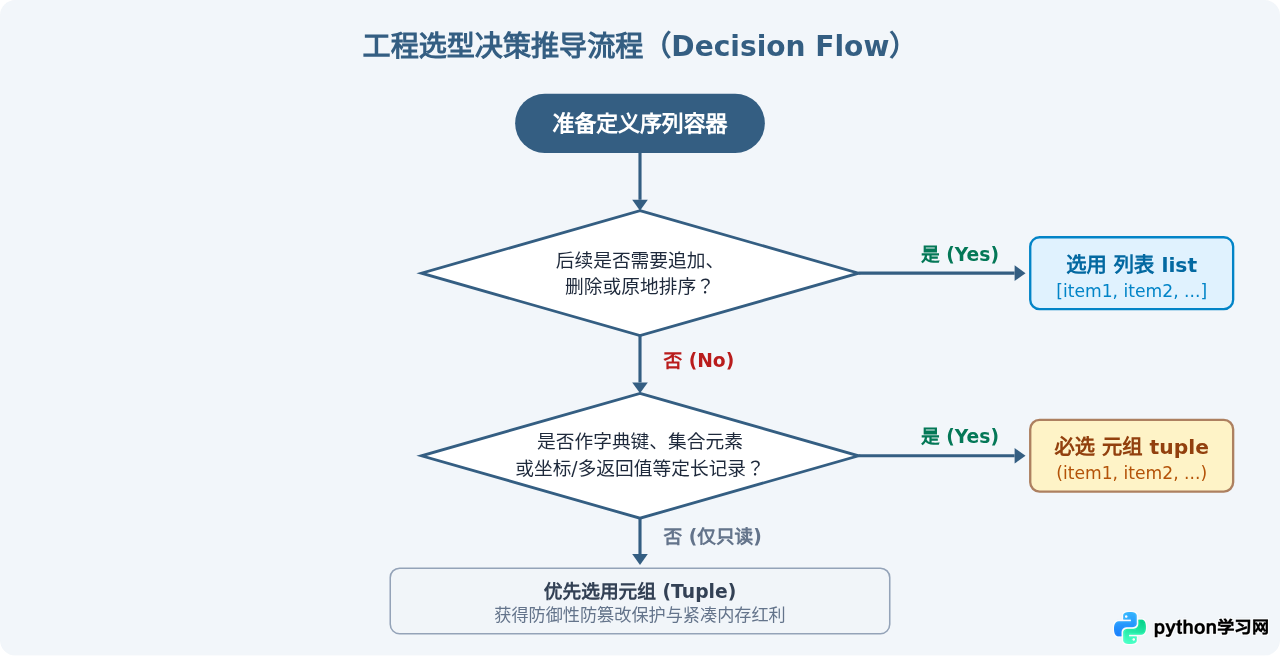
常见必须使用元组的场景清单:
- 组合键(Composite Key):例如网格游戏地图中的二维/三维离散坐标
grid[(x, y, z)] = terrain_type,或者多维度统计报表的复合索引cache[(year, quarter, department)]。 - 只读配置与常量序列:模块或全局配置中的固定允许选项,例如
ALLOWED_EXTENSIONS = ('.jpg', '.png', '.webp'),传入str.endswith()时可直接接收元组进行批量前缀/后缀匹配。 - 数据库游标返回结果行:在大多数 Python 数据库驱动(如
sqlite3,psycopg2)中,执行查询后每行记录默认以元组形式交付,确保查询出的原始快照不会被意外就地篡改。 - 高并发海量轻量级记录:当需要常驻内存数百万条定长数据对象时,采用元组替代列表可以节省数十兆乃至上百兆的 RAM 内存。
六、易错细节与避坑指南
虽然元组语义清晰,但在实际编码中仍有两处极其高频的语法陷阱需要注意:
1. 单元素元组的尾随逗号陷阱
在 Python 中,决定元组身份的本质是逗号,而不是圆括号。圆括号在语法中同时承担数学运算优先级的任务。如果定义单元素时不加逗号,解释器会将其视作单纯的括号表达式:
# 错误写法:此时 not_a_tuple 是一个普通的整数 42
not_a_tuple = (42)
print(type(not_a_tuple))  # 输出: <class 'int'>

# 正确写法:末尾必须保留英文逗号
is_a_tuple = (42,)
print(type(is_a_tuple))   # 输出: <class 'tuple'>
2. 元组与命名元组(namedtuple)
当元组字段较多时,纯粹依赖索引 record[0]、record[1] 会严重削弱代码的可读性和维护性。此时推荐使用标准库 collections.namedtuple,它兼具元组的不可变性、低内存占用,同时支持通过有意义的属性名访问字段:
from collections import namedtuple

# 定义具有明确属性命名的元组子类
Coordinate = namedtuple('Coordinate', ['latitude', 'longitude'])
loc = Coordinate(39.9042, 116.4074)

print(loc.latitude)   # 通过属性访问: 39.9042
print(loc[0])         # 仍然兼容索引解包: 39.9042
七、全维度特性总结
为了便于日常开发查阅,以下将元组与列表的核心技术维度总结为对照图表与矩阵:
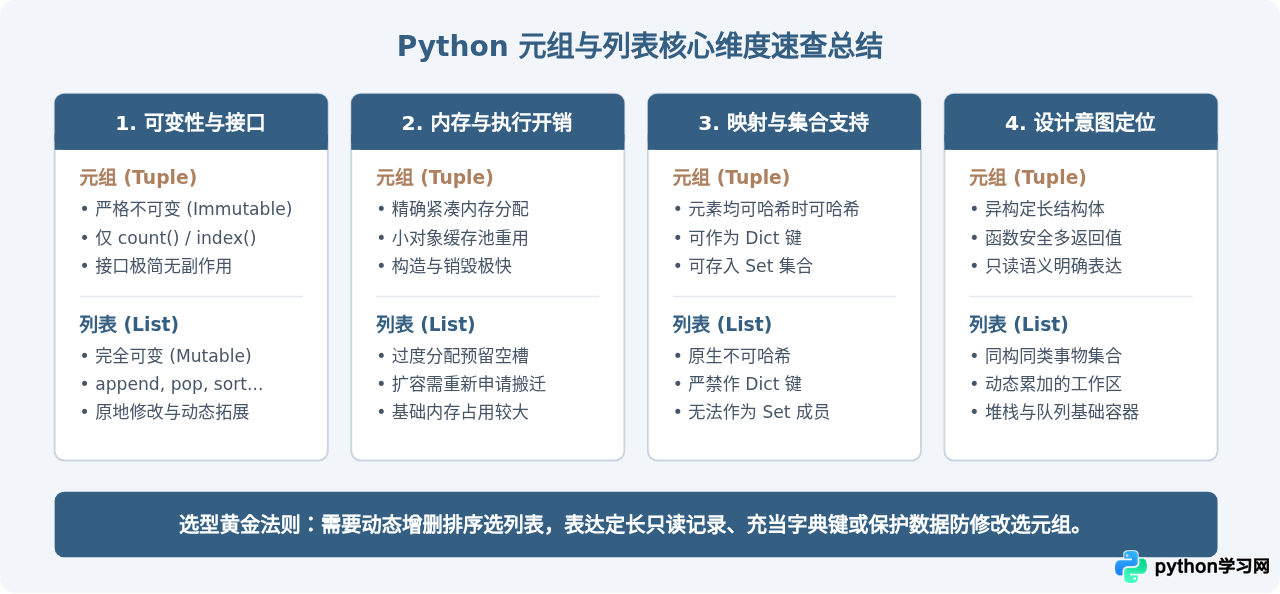
| 对比维度 | 元组 (tuple) | 列表 (list) |
|---|---|---|
| 字面量语法 | 逗号或圆括号 (1, 2),单元素 (1,) |
方括号 [1, 2],单元素 [1] |
| 可变性 | 严格不可变(Immutable) | 完全可变(Mutable) |
| 底层内存分配 | 紧凑分配,无冗余槽位,享小对象复用池 | 超额预分配(Over-allocation)带闲置槽位 |
| 可哈希性 | 只要内部元素均可哈希,则整体可哈希 | 不可哈希(TypeError) |
| 主要 API 方法 | 仅 count() 和 index() |
append(), extend(), pop(), sort() 等 |
| 典型应用场景 | 字典键、集合元素、坐标、函数返回多值、常量配置 | 动态数据处理、收集日志、排队队列、同类对象列表 |
总结来说,不要简单因为列表功能更“丰富”就默认滥用列表。在明确不需要原地修改数据的场景下,主动选用元组能让代码的约束关系更严谨、内存占用更节省、执行性能更稳定,也是写出更具 Pythonic 风格代码的良好实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















