


Python数据处理基础:使用Pandas读取与清洗简单数据
面向Python初学者的Pandas数据处理实用指南,详细讲解如何读取CSV与Excel表格、探查数据质量,并实战处理缺失值、重复项、格式异常与类型转换,完成规范化的数据清洗。
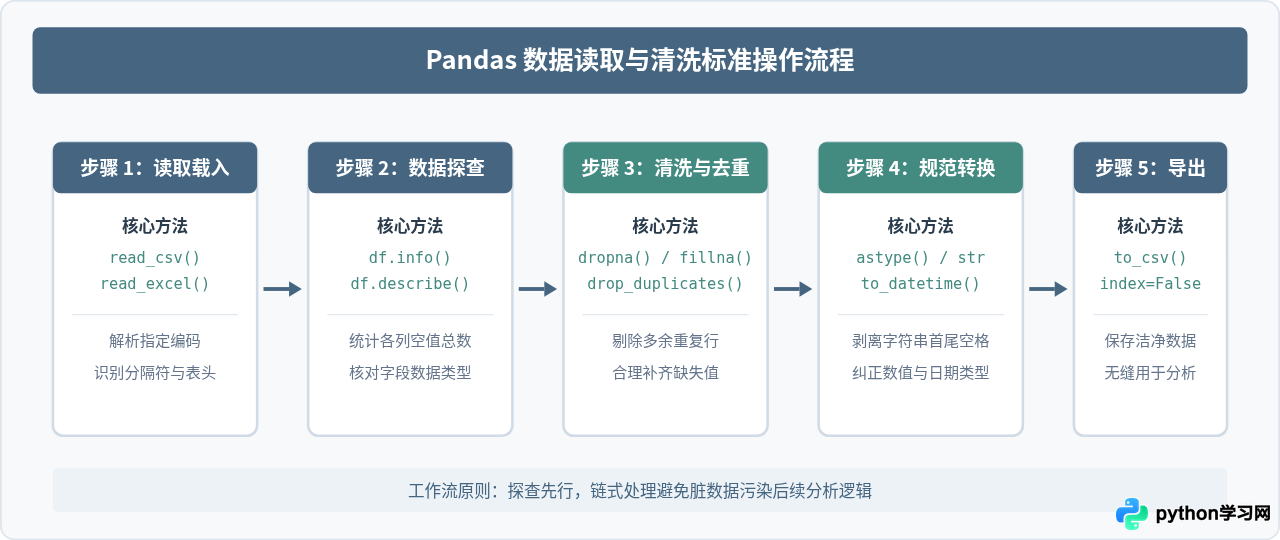
在数据分析与自动化处理工作中,原始数据往往充满空值、重复记录、格式混乱与类型错位。Pandas作为Python生态中最核心的结构化数据处理库,提供了极为高效的表格抽象(DataFrame)与系列清洗接口。本文通过一个包含典型质量缺陷的真实样例,依次讲解环境准备、文件读取、质量探查、缺失值与重复项清洗、类型转换及规范导出的完整操作闭环,帮助初学者建立标准的数据处理流程。
一、准备环境与构建样例数据
在开始编写代码前,需确保已安装Pandas库。若需要处理Excel文件(.xlsx),还需安装openpyxl解析引擎。在系统终端执行如下命令:
pip install pandas openpyxl为了直观展示清洗步骤,我们构建一份典型的原始订单表格文件 raw_orders.csv。该文件故意包含了实际场景中高频出现的几类脏数据:
- 缺失值:部分记录缺少金额(Amount)或用户ID(UserID)。
- 重复行:由于网络重试或数据合并导致的完全重复记录。
- 格式混乱:产品名称(ProductName)前后存在多余空格、大小写混用。
- 类型不符:下单日期(OrderDate)为纯文本字符串,金额字段包含美元符号无法直接进行数学计算。
# 创建本地演示数据 raw_orders.csv
csv_content = """OrderID,UserID,ProductName,Amount,OrderDate
1001,U01, iPhone 14 ,$799.00,2023-10-01
1002,U02,MacBook Air,$1199.50,2023/10/02
1003,, iPad Pro ,$899.00,2023-10-03
1004,U03,iphone 14,$799.00,2023-10-04
1001,U01, iPhone 14 ,$799.00,2023-10-01
1005,U04,AirPods Pro,,2023-10-05
1006,U05, WATCH Ultra ,$799.00,not_a_date
"""

with open("raw_orders.csv", "w", encoding="utf-8") as f:
    f.write(csv_content.strip())
二、使用 Pandas 读取数据并理解二维结构
Pandas读取外部表格最常用的函数是 pd.read_csv() 与 pd.read_excel()。读取后,数据在内存中被映射为 DataFrame 对象。DataFrame是具有行索引(Index)与列名称(Columns)的二维表格结构,其中的每一列均为一个 Series。
import pandas as pd

# 读取 CSV 文件
df = pd.read_csv("raw_orders.csv")

# 查看前 5 行数据
print(df.head())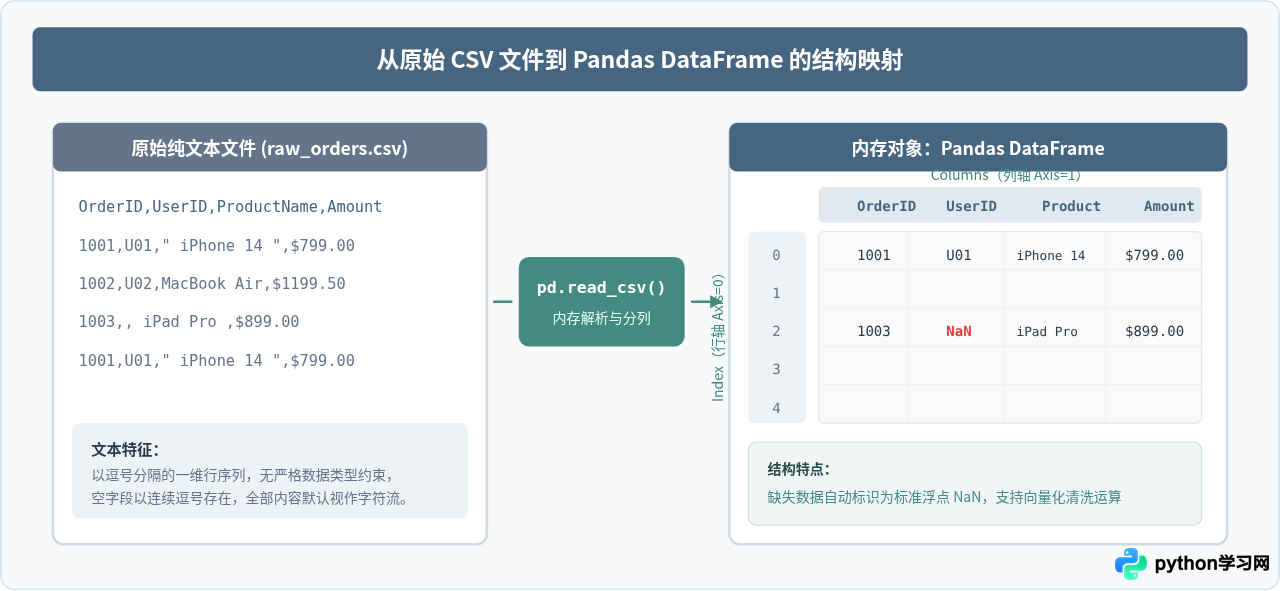
三、探查数据质量与结构缺陷
拿到数据后的首要任务是全面诊断,而不是盲目处理。Pandas提供了三组快速探查工具,分别用于核验维度、字段类型与缺失统计。
# 1. 检查数据行数与列数
print("数据维度 (行, 列):", df.shape)

# 2. 查看各列非空统计与推断的数据类型
print("\n--- 字段基础信息 ---")
df.info()

# 3. 统计各列的缺失值 (NaN) 数量
print("\n--- 缺失值统计 ---")
print(df.isnull().sum())通过探查可以发现三个问题:
UserID与Amount均存在 1 处空值(显示为 NaN)。Amount本应为数值,但因为带有美元符号$,被判定为object(即字符串)。OrderDate同样是object,尚未解析为标准日期类型。
四、关键数据清洗实战
1. 重复值的检测与剔除
真实业务中,相同订单被重复录入会导致统计指标失真。Pandas使用 duplicated() 标记重复行,使用 drop_duplicates() 予以剔除。
# 检查是否存在全行完全相同的重复记录
print("完全重复行数量:", df.duplicated().sum())

# 剔除重复行,保留第一次出现的记录
df_cleaned = df.drop_duplicates(keep='first').copy()
print("剔除重复后行数:", len(df_cleaned))2. 缺失值(NaN)的识别与处理
处理缺失值通常有两种策略:直接删除含有空值的行,或用合理默认值/统计值予以填充。这取决于字段对于业务的重要程度。
- 必须保留核心主键:若关键识别字段(如 UserID)缺失且无法反查,可使用
dropna(subset=['UserID'])剔除。 - 金额与数值字段:若不能删除记录,可使用固定默认值(如 0.0)或均值进行填充
fillna()。
# 策略 A:剔除 UserID 缺失的无效订单
df_cleaned = df_cleaned.dropna(subset=['UserID']).copy()

# 策略 B:若 Amount 缺失,填充默认占位值 '$0.00',避免后续解析报错
df_cleaned['Amount'] = df_cleaned['Amount'].fillna('$0.00')

print("处理缺失值后剩余行数:", len(df_cleaned))
3. 字符串规范化清洗
由于手工录入或系统拼接,文本经常带有不可见的制表符或前后空格。同时,大小写混用会导致同一款产品被视作不同类别(如 "iPhone 14" 与 "iphone 14")。通过 .str 访问器可以对文本列进行批量清洗:
# 去除产品名称首尾空格,并统一转换为大写标题格式
df_cleaned['ProductName'] = df_cleaned['ProductName'].str.strip().str.title()

print(df_cleaned[['OrderID', 'ProductName']])4. 数据类型规范化转换
将 Amount 列中的货币符号 $ 剔除,并转换为浮点数 float;将日期列转换为规范的 datetime64 类型,对于无法识别的非法日期标记为缺失。
# 1. 清洗 Amount:剔除 $ 符号并转换为 float
df_cleaned['Amount'] = df_cleaned['Amount'].str.replace('$', '', regex=False).astype(float)

# 2. 清洗 OrderDate:转换为标准日期格式,非法字符串转换为 NaT
df_cleaned['OrderDate'] = pd.to_datetime(df_cleaned['OrderDate'], errors='coerce')

# 3. 剔除无法解析日期的脏数据行
df_cleaned = df_cleaned.dropna(subset=['OrderDate']).copy()

print(df_cleaned.dtypes)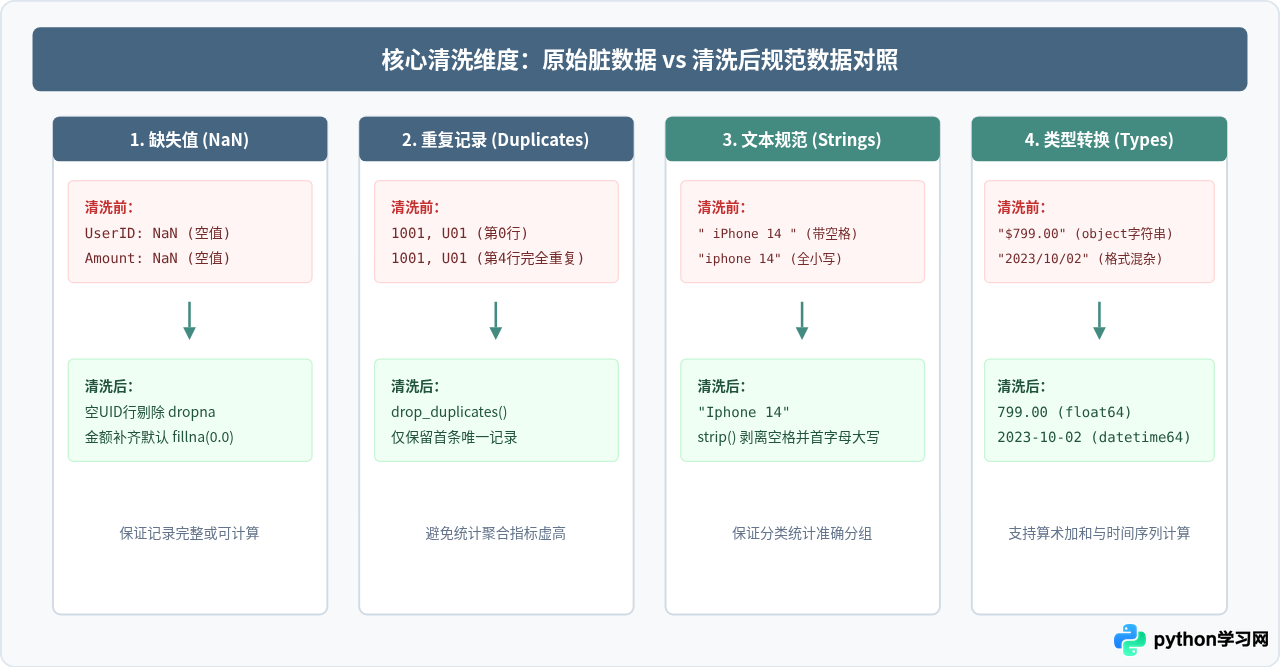
五、校验清洗成果与导出存储
完成所有清洗动作后,需对数据进行最终验收,并重置自增索引(Index),随后写入干净的文件中。
# 1. 重置行索引,drop=True 表示不将旧索引保留为独立列
df_final = df_cleaned.reset_index(drop=True)

# 2. 打印最终干净数据
print("--- 最终清洗数据集 ---")
print(df_final)

# 3. 导出为新 CSV 文件,注意必须指定 index=False
df_final.to_csv("cleaned_orders.csv", index=False, encoding="utf-8")
print("\n清洗数据已成功导出为 cleaned_orders.csv")index=False 参数Pandas默认会在导出时将DataFrame的行号索引写入第一列(无列名)。如果再次读取该文件,会导致多出一列未命名索引(如
Unnamed: 0)。因此在导出CSV时,通常应显式声明 index=False。
六、高频操作决策路径与方法总结
在面对未知质量的表格数据时,可以依据下述决策路径快速选用对应的Pandas API方法,形成系统化的清洗策略:
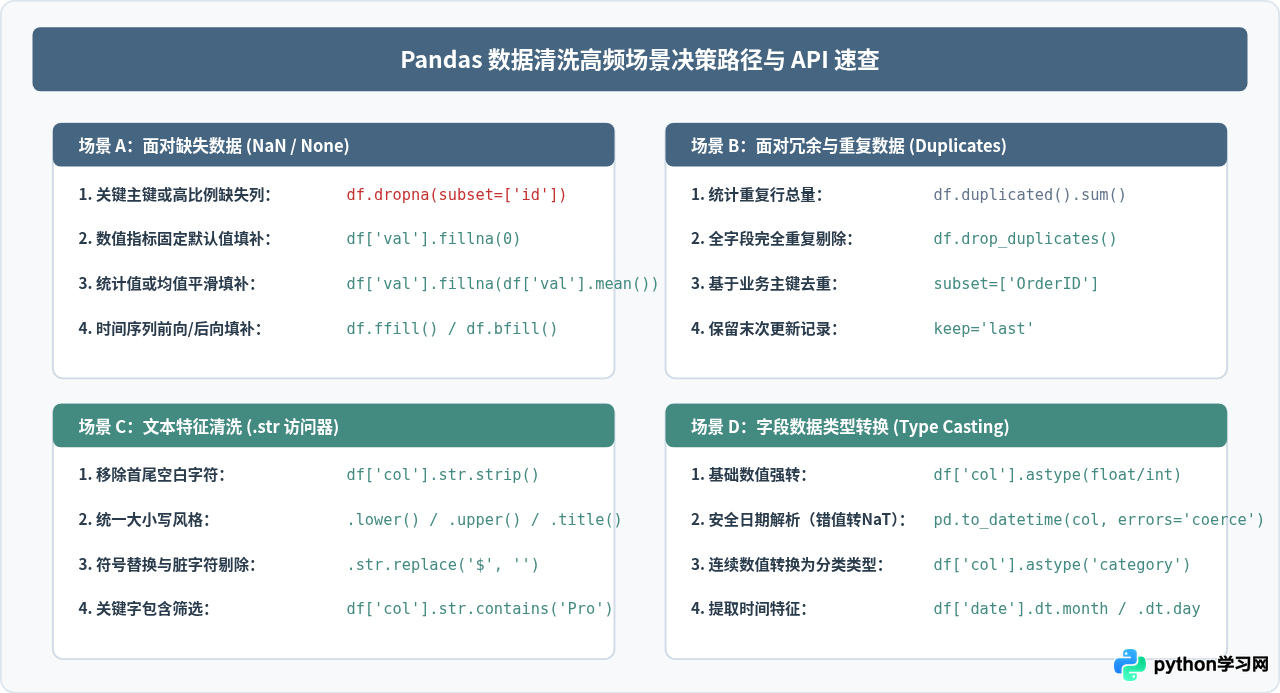
掌握了读取、探查、去重、补缺、格式转换与导出这套核心链条后,便具备了处理绝大多数中小型表格数据的能力。在后续深入学习中,可以进一步探索基于条件的布尔索引筛选、分组聚合计算(groupby)与多表关联(merge),逐步构建出更强大的自动化数据处理管道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















