


python必背源代码解包赋值星号*用法代码
全面讲解Python必背源代码中解包赋值星号(*)的核心用法与代码实现,涵盖首尾提取、中间收纳、强制转表、嵌套解包、底层执行机制与SyntaxError/ValueError避坑全景指南。
一、5 种必背经典解包源码形态与示例
在日常数据处理与工程开发中,根据目标提取位置的不同,带星号的解包赋值可归纳为以下 5 种必背源代码形态。每一段代码均可在标准 Python 3 解释器中直接运行。
形态 1:提取首项与后续剩余项(head, *tail)
这种模式常见于处理具有固定头部信息、后跟不定长记录流的场景(如命令行指令与后续参数、表头与数据行)。
# 源码形态 1:提取首个元素,剩余元素归入 tail
raw_data = ["GET", "/api/v1/users", "HTTP/1.1", "Host: example.com"]
action, *details = raw_data

print(f"请求动作: {action}")
print(f"详情列表: {details}")
print(f"类型确认: {type(details)}")详情列表: ['/api/v1/users', 'HTTP/1.1', 'Host: example.com']
类型确认: <class 'list'>
形态 2:提取历史前缀与最终末项(*init, last)
常用于时间序列追踪、状态机记录或版本控制流,在不需要中间复杂循环的前提下直接捕获最新的收敛结果。
# 源码形态 2:前缀多项归入 init,抓取最终状态 last
status_timeline = ["PENDING", "RUNNING", "RETRY", "SUCCESS"]
*history_stages, current_status = status_timeline

print(f"历史过渡阶段: {history_stages}")
print(f"当前终态: {current_status}")当前终态: SUCCESS
形态 3:首尾定界夹取,收纳中间段(first, *middle, last)
首尾两端为确定字段、中间为任意数量可变数据的通用解析模式(例如带边界校验码的网络报文,或包含首尾极值的统计样本)。
# 源码形态 3:首尾锚定,中间弹性收容
scores = [98, 85, 76, 90, 88, 62]
highest, *middle_scores, lowest = sorted(scores, reverse=True)

print(f"最高分: {highest}")
print(f"中间分数段: {middle_scores}")
print(f"最低分: {lowest}")中间分数段: [90, 88, 85, 76]
最低分: 62
形态 4:任意可迭代对象强制展开为列表(*items, = iterable)
利用解包语法快速将生成器表达式、range 对象或集合一次性转换为新列表。注意左侧必须保留逗号,使之在语法上构成单元素元组目标。
# 源码形态 4:生成器或惰性对象一键解包转换为 list
gen = (x * 2 for x in range(5))
*doubled_list, = gen

print(f"转换后的列表: {doubled_list}")
print(f"类型: {type(doubled_list)}")类型: <class 'list'>
形态 5:多变量前缀 + 尾部收尾(var1, var2, *rest)
# 源码形态 5:前两个显式分配,后续归并
record = ("1001", "Alice", 95.5, "Beijing", "Active")
user_id, user_name, *attributes = record

print(f"用户ID: {user_id}, 姓名: {user_name}")
print(f"附加属性列表: {attributes}")附加属性列表: [95.5, 'Beijing', 'Active']
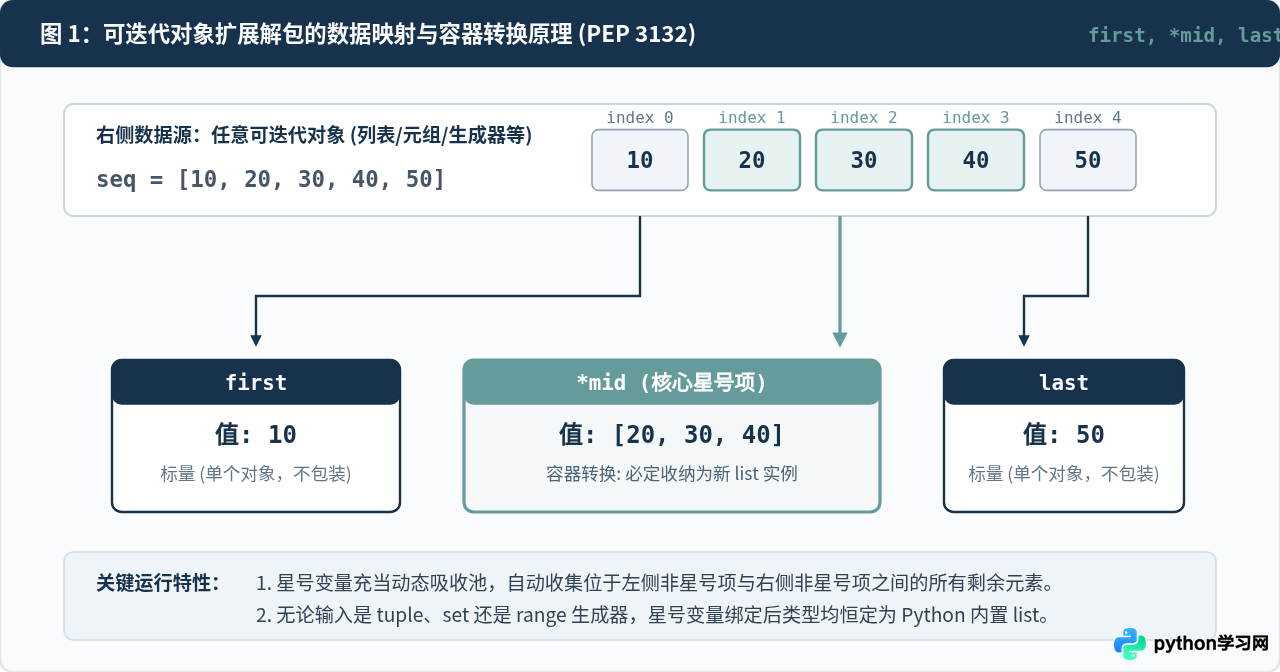
图 1:可迭代对象扩展解包的数据映射与容器转换原理
二、执行步骤:Python 解释器内部如何处理带星号解包
在 Python CPython 底层实现中,包含星号的解包赋值由字节码指令 UNPACK_EX 驱动。理解解释器的 4 步执行管线,有助于我们在写出代码的同时准确预判各种临界状态:
- 编译期语法校验:解释器在将源码抽象语法树(AST)编译为字节码时,会检查同一解包表达式层次中是否至多存在一个带星号项。若出现两个及以上的星号变量(如
*a, *b = seq),编译器立即抛出SyntaxError并终止编译。 - 确定基础配额下限:计算左侧必须精确匹配的非星号标量变量个数(设左侧有
L个标量,右侧有R个标量,合计基础需求为L + R)。运行时检查被解包序列的长度len(seq):- 若
len(seq) < L + R:元素总数甚至无法填满固定变量位,立即抛出ValueError: not enough values to unpack。 - 若
len(seq) >= L + R:判定合法,继续向下切分。
- 若
- 切片切分与 List 实例化:解释器先顺序提取头部
L个元素,再逆序提取尾部R个元素。介于两者之间的所有盈余元素,不论原始容器是tuple、set还是惰性generator,解释器均会统一调用内置构造逻辑生成全新的list对象并赋给带星号变量。若恰好没有盈余元素,星号变量被赋予一个空列表[]。 - 命名空间写入:将标量对象与新生成的列表对象按目标变量名原子化存入局部或全局命名空间字典。
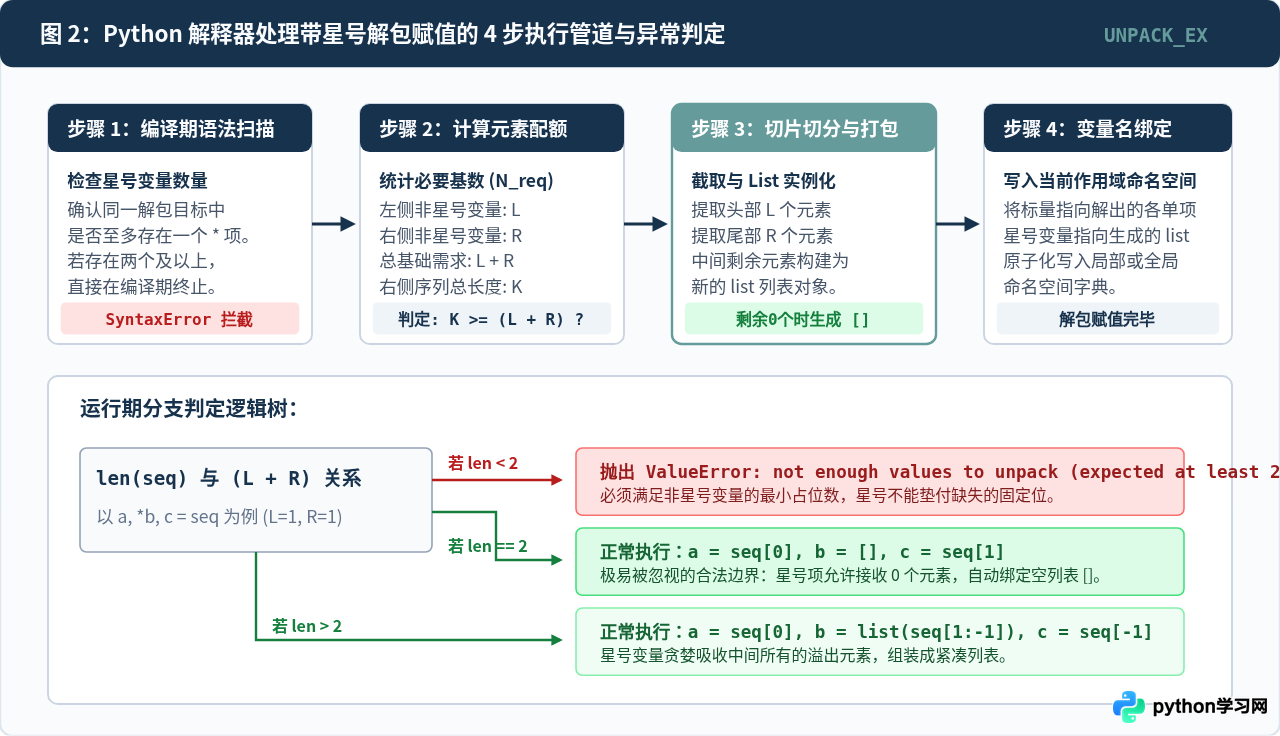
图 2:Python 解释器处理带星号解包赋值的 4 步执行管道与异常判定
三、必背进阶实战:嵌套解包、循环迭代与占位清洗
星号解包不仅能处理扁平结构,还能无缝嵌入到复杂元组、for 循环迭代和数据清洗管线中。
1. 结合下划线 *_ 忽略不关心的数据段
当解包序列中存在大量中间无用数据(如日志时间戳与最终返回码之间的冗余负载)时,Python 官方推荐使用 *_ 表达“通配丢弃”,既保持赋值语义清晰,又向代码阅读者传达明确的意图:
# 提取首项和尾项,直接丢弃中间所有项目
log_entry = ("2026-11-18 15:30:00", "192.168.1.10", "POST", "payload_dump...", 200)
timestamp, *_, response_code = log_entry

print(f"时间: {timestamp}, 响应状态: {response_code}")2. 嵌套数据结构的深层星号解包
只要使用圆括号 (...) 或方括号 [...] 圈定子层级,每个独立的解包层次都可以包含属于该层次的星号变量:
# 嵌套元组解包:外层提取 id,内层提取首项分数与后续所有分数
student_record = ("STU_9981", (98, 88, 79, 92), "Class_A")
stu_id, (first_exam, *remaining_exams), class_name = student_record

print(f"学号: {stu_id}")
print(f"首考成绩: {first_exam}")
print(f"后续平时期末成绩: {remaining_exams}")首考成绩: 98
后续平时期末成绩: [88, 79, 92]
3. 在 for 循环迭代器中直接解包
在遍历包含不定长序列的数据集时,直接在 for 语句的迭代变量处应用星号解包,可以免去在循环体内部编写索引下标:
# 循环中批量解包变长数据
dataset = [
    ["Alice", 90, 85, 95],
    ["Bob", 70, 75],
    ["Charlie", 100, 98, 95, 99],
]

for name, *scores in dataset:
    avg_score = sum(scores) / len(scores) if scores else 0
print(f"姓名: {name:8} | 考试科次数: {len(scores)} | 平均分: {avg_score:.2f}")姓名: Bob | 考试科次数: 2 | 平均分: 72.50
姓名: Charlie | 考试科次数: 4 | 平均分: 98.00
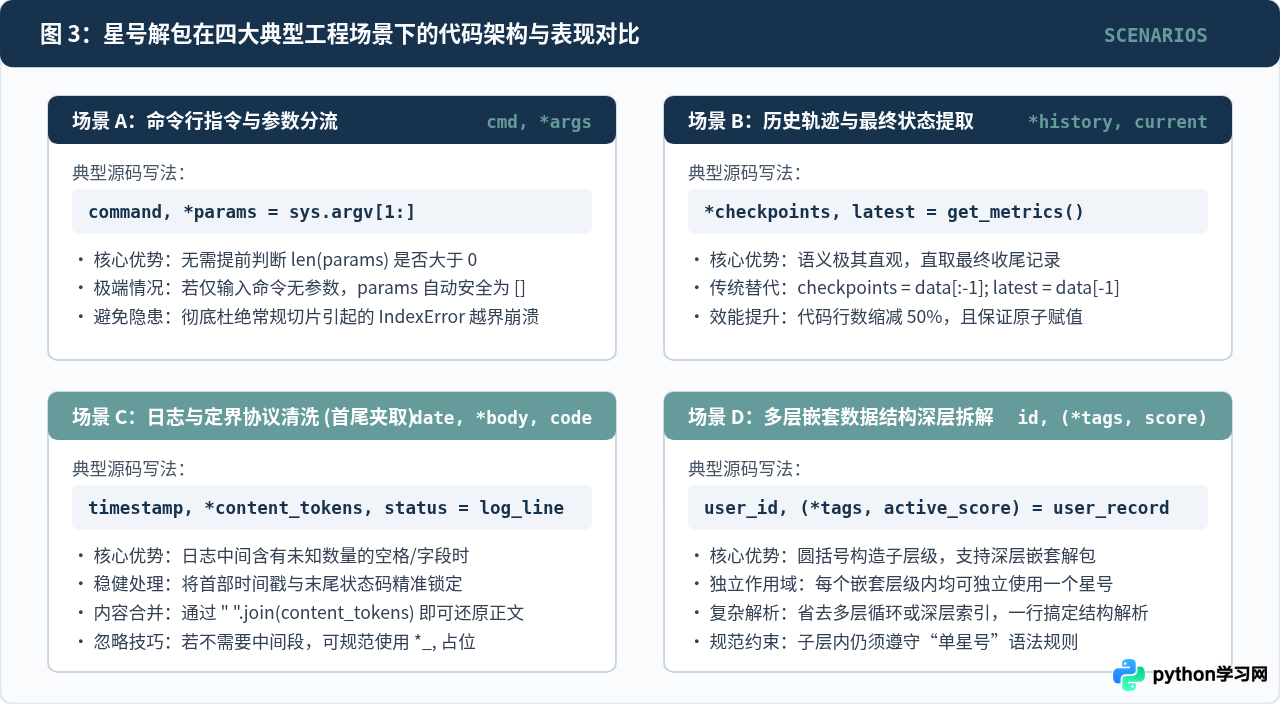
图 3:星号解包在四大典型工程场景下的代码架构与表现对比
四、语法边界与 4 大常见报错避坑排查
虽然星号解包语法灵活直观,但有几条严格的语言级约束。在编写或审查代码时,务必注意规避以下容易混淆的错误写法:
错误代码:*left, *right = [1, 2, 3, 4]
报错原因:SyntaxError: two starred expressions in assignment。两个贪婪吸收池无法确定各自切分的边界(即解释器无法推断 left 应该拿 1 个还是 3 个),因而语法直接禁止。
错误代码:*result = range(5)
报错原因:SyntaxError: starred assignment target must be in a list or tuple。根据 PEP 3132 规定,解包赋值的左值必须显式呈现为元组或列表结构。修正方案是在变量后追加逗号 *result, = range(5),或者使用方括号括起 [*result] = range(5)。
错误代码:a, b, *c = [10]
报错原因:ValueError: not enough values to unpack (expected at least 2, got 1)。左侧存在 a 和 b 两个固定标量,因此右侧序列至少需要 2 个元素。星号项 *c 只负责吸纳 2 个之后的多余元素,不能用来抵扣固定位的缺失。
若右侧解包的是字符串 head, *tail = "hello",tail 得到的是字符列表 ['e', 'l', 'l', 'o'] 而非子字符串 "ello";同理解包元组得到的也是列表。若后续业务逻辑强依赖特定容器类型,需显式执行 "".join(tail) 或 tuple(tail) 进行还原。
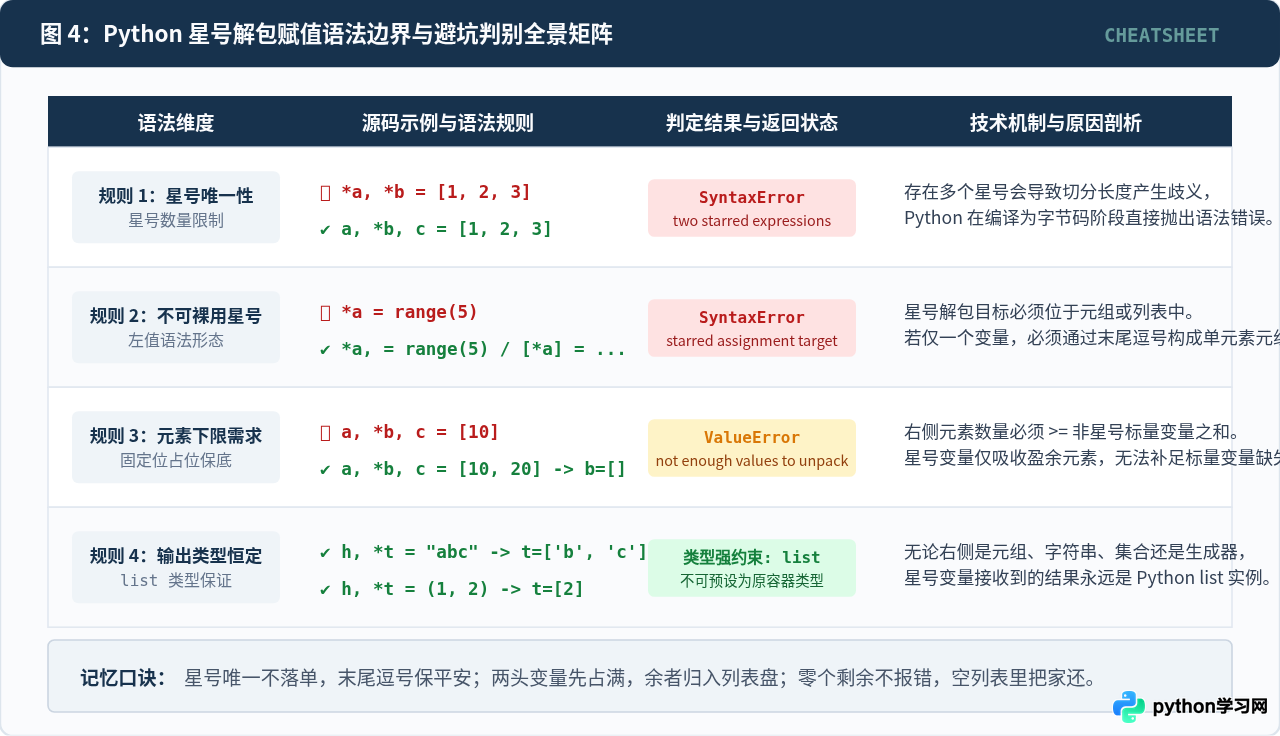
图 4:Python 星号解包赋值语法边界与避坑判别全景矩阵
五、总结:核心用法速查表
下表归纳了不同解包需求下的标准实现模板,可作为日常编码时的必背速查参考:
| 操作诉求 | 必背源代码写法 | 星号变量最终类型 | 空值安全表现 |
|---|---|---|---|
| 取首留后 | head, *tail = data |
list |
若数据仅 1 项,tail 自动为 [] |
| 取尾留前 | *init, last = data |
list |
若数据仅 1 项,init 自动为 [] |
| 首尾夹取 | first, *middle, last = data |
list |
若数据仅 2 项,middle 自动为 [] |
| 强转为表 | *items, = iterable |
list |
若数据为空,items 自动为 [] |
| 跳过中间 | start, *_, end = data |
list (被丢弃) |
标准 PEP 8 命名惯用法,清晰表明忽略意图 |
| 嵌套提取 | name, (*sub, final) = nested |
list |
子层级边界严格隔离,各自独立计算配额 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















