


Python运行汉诺塔报错RecursionError怎么解决?
针对Python运行汉诺塔程序时出现的RecursionError: maximum recursion depth exceeded报错,详细剖析四种核心成因、排查流程、修复方案与运行验证,帮助开发者彻底解决递归超限问题。
一、故障现象与报错本质
在控制台或终端运行汉诺塔脚本时,常见的错误提示如下:
RecursionError: maximum recursion depth exceeded in comparison或者在早期Python版本中提示:
RecursionError: maximum recursion depth exceeded while calling a Python object
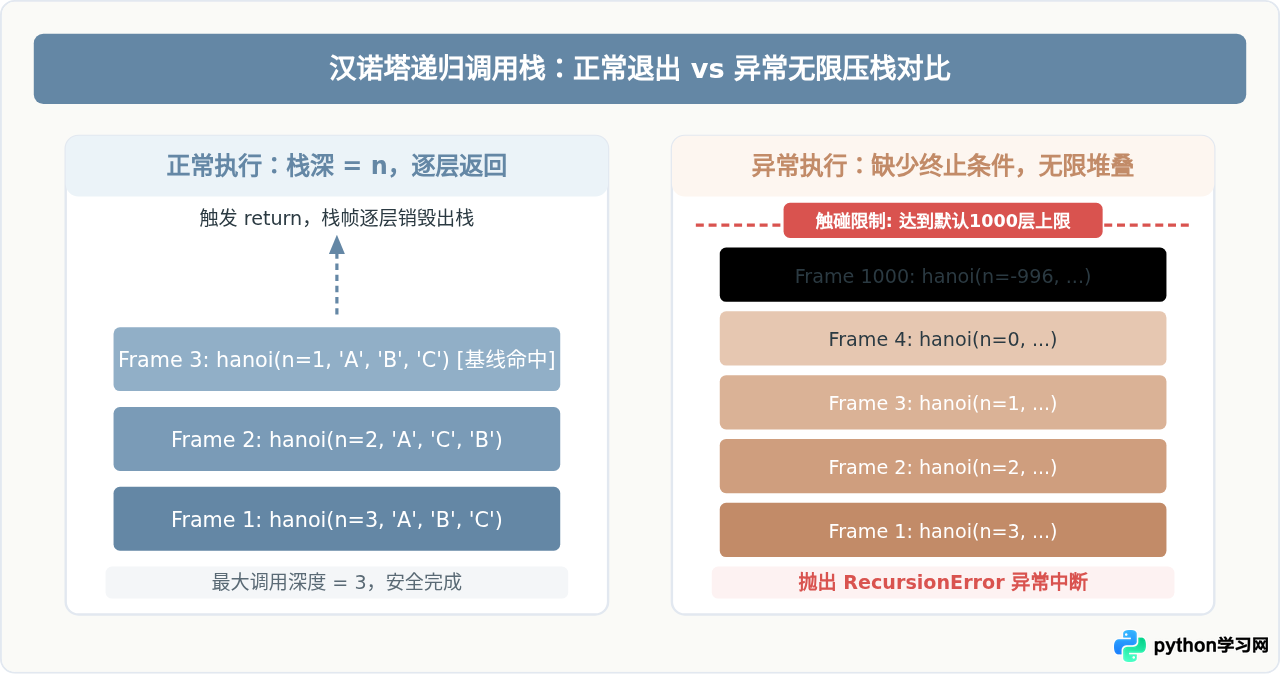
Python解释器为了防止C语言底层调用栈发生不可控的溢出导致程序崩溃,默认设置了最大递归深度保护(通常为1000层)。每次函数调用都会在内存栈中开辟一个栈帧(Stack Frame),包含局部变量和返回地址。如果一个递归函数一直向深层调用而没有适时返回出栈,栈帧累积超过阈值,解释器就会立刻抛出 RecursionError。
二、排查与定位:导致报错的四大根因
汉诺塔算法是典型的单链递归调用,移动 n 个盘子的总步数虽然是 2n - 1(时间复杂度指数级),但其递归树的最大深度恰好只有 n。如果你的程序报错,请对照以下四种最常见的代码缺陷进行排查。
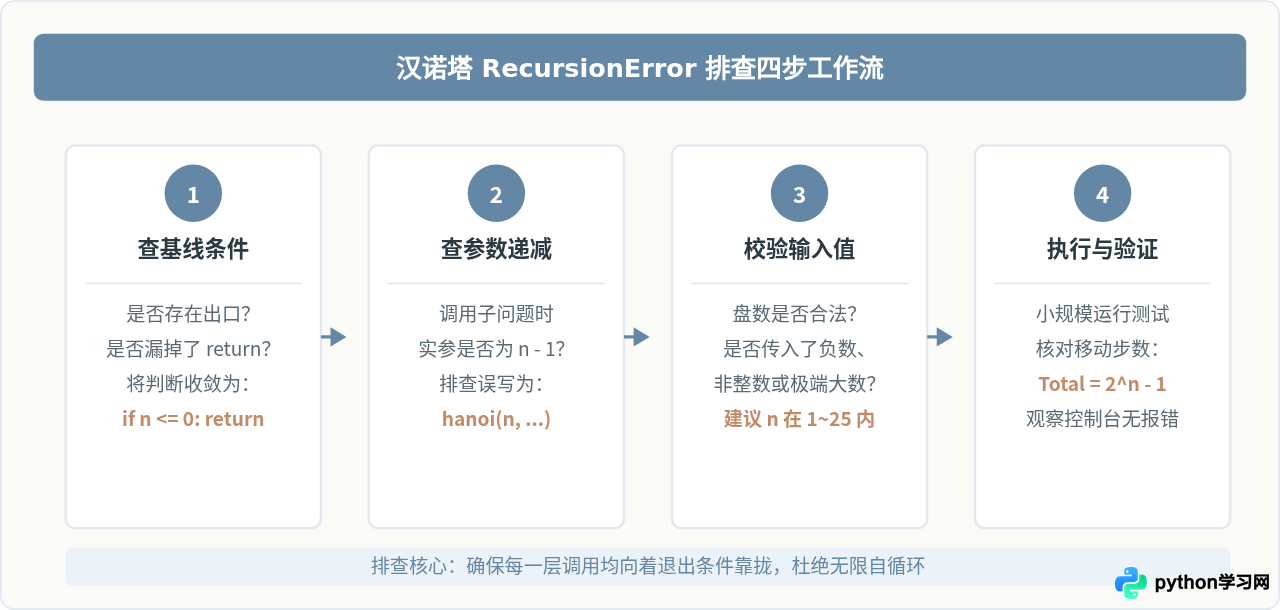
根因 1:缺失基线条件(Base Case)或未执行 return
递归必须有出口。如果在编写函数时忘记写 if n == 1: 或 if n == 0: 的返回分支,函数调用就会一路从正数递减到 0、-1、-2,直至无限递归。
错误代码示例:
# 错误示例:没有基线退出条件
def hanoi_bug1(n, a, b, c):
    hanoi_bug1(n - 1, a, c, b)
    print(f"{a} -> {c}")
    hanoi_bug1(n - 1, b, a, c)

hanoi_bug1(3, 'A', 'B', 'C')  # 立刻抛出 RecursionError
根因 2:递归参数传递错误(未发生规模递减)
递归调用的核心要求是“子问题的规模必须比父问题更小”。如果在递归调用自身时,将 n - 1 误写成了 n,规模从未缩小,调用深度会瞬间用尽。
错误代码示例:
# 错误示例:递归调用时参数误写为 n,没有缩小规模
def hanoi_bug2(n, a, b, c):
    if n == 1:
        print(f"{a} -> {c}")
        return
    hanoi_bug2(n, a, c, b)     # 错误:应为 n - 1
    print(f"{a} -> {c}")
    hanoi_bug2(n - 1, b, a, c)
根因 3:传入了非法输入(负数、0 或浮点数)
如果基线条件严格写成了 if n == 1:,当外界传入 0 或 -5 时,n 在递减过程中永远不会等于 1(例如从 0 变成 -1、-2……),直接跳过判断,陷入死循环。
错误代码示例:
def hanoi_bug3(n, a, b, c):
    if n == 1:  # 如果传入 n <= 0,该等式永远不成立!
        print(f"{a} -> {c}")
        return
    hanoi_bug3(n - 1, a, c, b)
    print(f"{a} -> {c}")
    hanoi_bug3(n - 1, b, a, c)

hanoi_bug3(0, 'A', 'B', 'C')  # 传入0,直接RecursionError
根因 4:将 n 设定过大(超出物理执行与递归极限)
部分初学者在测试算法性能时,直接传入了 n = 1000。汉诺塔移动步数为 2n - 1,即便没有死循环,当 n=1000 时,调用栈深度正好达到 1000 层,直接撞上默认递归保护壁垒。更重要的是,21000 是一个天文数字,在现实中即便每秒完成百亿次计算,也需要宇宙寿命级别的漫长时间才能运行完毕。因此,对汉诺塔传入超大盘数本身在工程逻辑上就是不成立的。
三、完整正确的汉诺塔实现与参数传递解析
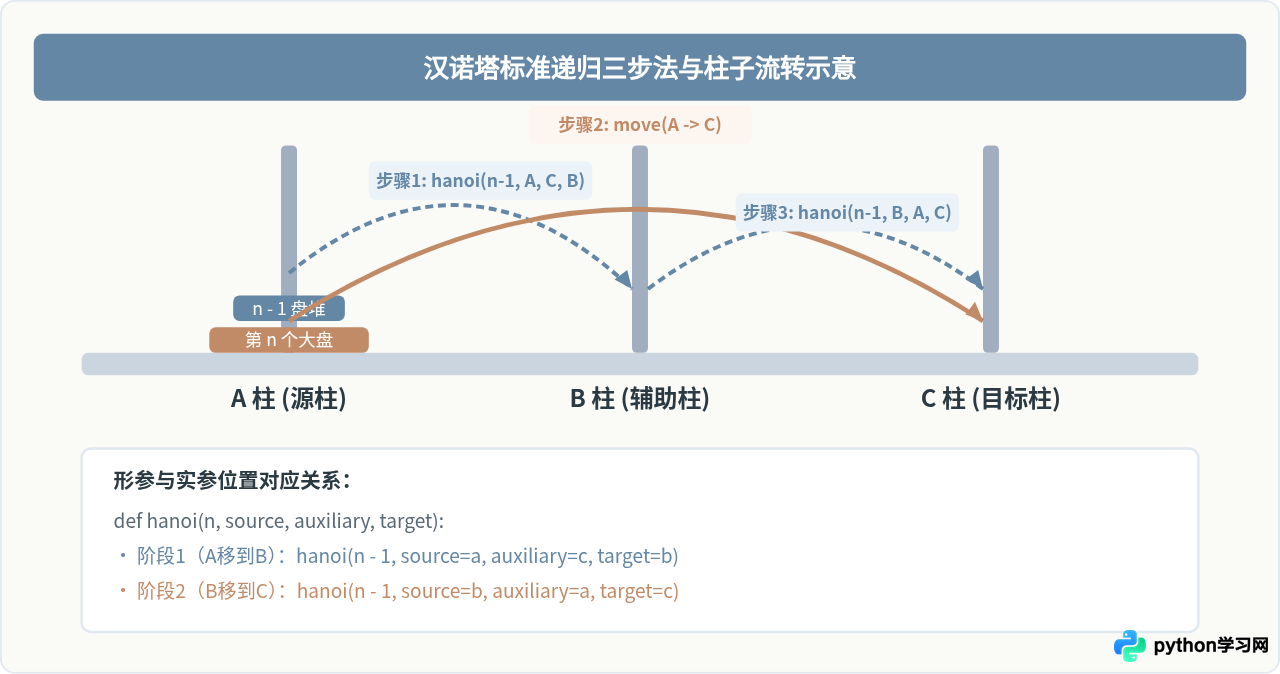
解决问题的关键在于建立清晰严谨的递归逻辑。汉诺塔的标准解题思路包含三个固定子任务:
- 子任务 1:借助目标柱 C,将前
n - 1个圆盘从源柱 A 移动到辅助柱 B; - 单步操作:将底部的第
n个大圆盘直接从源柱 A 移动到目标柱 C; - 子任务 2:借助源柱 A,将辅助柱 B 上的
n - 1个圆盘移动到目标柱 C。
下面给出经过输入边界防护的完整、规范代码:
def hanoi(n, source, auxiliary, target):
    """
    汉诺塔递归求解函数
    :param n: 圆盘数量(正整数)
    :param source: 起始柱
    :param auxiliary: 辅助过渡柱
    :param target: 目标柱
    """
    # 1. 前置安全校验:非正整数直接退出,杜绝死循环
    if not isinstance(n, int) or n <= 0:
        return

    # 2. 基线条件(Base Case):仅剩1个盘子时,直接搬运
    if n == 1:
        print(f"移动盘 1: {source} -> {target}")
        return

    # 3. 递归步骤一:将前 n-1 个盘子借助 target 移到 auxiliary
    hanoi(n - 1, source, target, auxiliary)

    # 4. 关键单步:将当前第 n 个底盘从 source 移到 target
    print(f"移动盘 {n}: {source} -> {target}")

    # 5. 递归步骤二:将 auxiliary 上的 n-1 个盘子借助 source 移到 target
    hanoi(n - 1, auxiliary, source, target)


if __name__ == "__main__":
    # 示例运行:测试 3 个圆盘从 A 移动到 C
    print("=== 开始运行 3 阶汉诺塔 ===")
    hanoi(3, 'A', 'B', 'C')
    print("=== 运行成功完成 ===")
控制台正确输出示例:
=== 开始运行 3 阶汉诺塔 ===
移动盘 1: A -> C
移动盘 2: A -> B
移动盘 1: C -> B
移动盘 3: A -> C
移动盘 1: B -> A
移动盘 2: B -> C
移动盘 1: A -> C
=== 运行成功完成 ===
对于 n = 3,输出共有 23 - 1 = 7 次移动。整个执行过程最大调用深度恰好为 3,运行顺畅,完全不会触发 RecursionError。
四、常见误区:为什么不能通过 setrecursionlimit 解决?
在解决 RecursionError 时,网络上常有人提到使用 sys.setrecursionlimit() 来调高限制:
import sys
# 不推荐盲目使用此方法:
sys.setrecursionlimit(100000)
1. 死循环无法靠调大限制解决:如果是由于基线条件缺失或 n-1 遗漏导致的死循环,调大阈值到 10000 甚至更大,代码仍然会在更深处耗尽并抛错,或者直接导致底层的 C 堆栈溢出(Segmentation Fault 进程硬崩溃)。
2. 时间复杂度是根本制约:汉诺塔的求解步数是 2n - 1。当 n 从 30 增加到 64,计算步数已超过 1844 亿亿次。在现实中,任何计算机都无法在有限时间内跑完上千阶汉诺塔。因此,遇到 RecursionError 应 100% 优先排查算法逻辑,绝非修改系统递归阈值。
五、总结与自查清单
解决汉诺塔中出现的 RecursionError,核心是建立“递推-收敛-退出”的严格防护机制。以下是解决该类问题的关键要点总结:
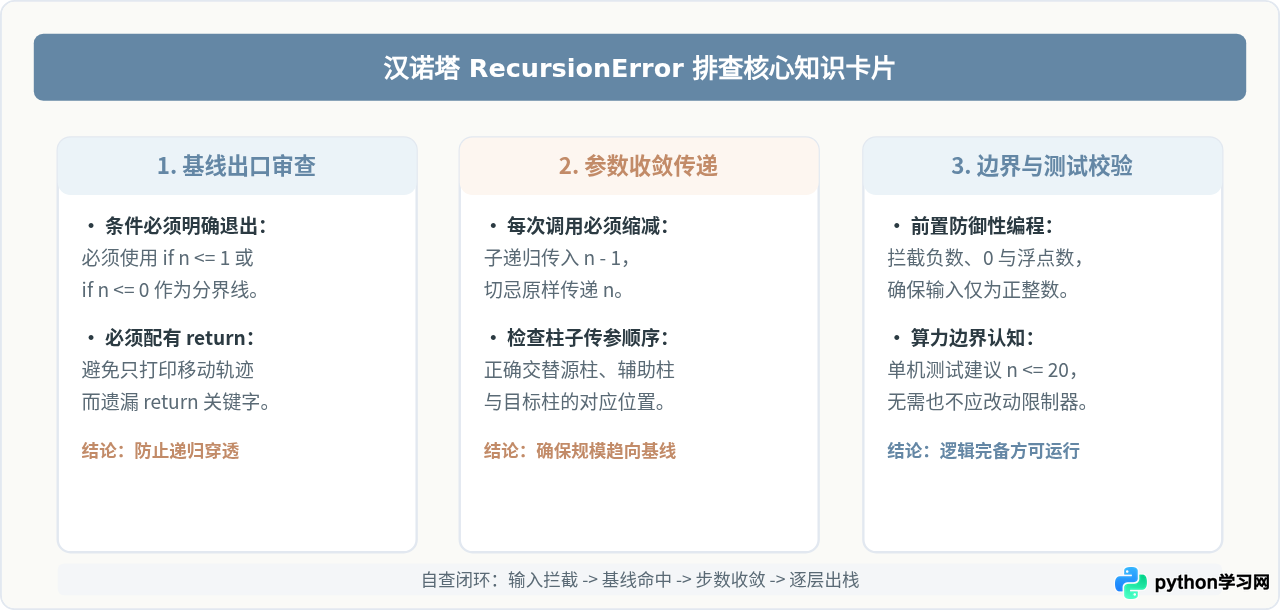
| 排查检查项 | 标准正确写法 | 常见错误写法 | 处理措施 |
|---|---|---|---|
| 基线出口 | if n <= 1: return |
遗漏 if 分支或缺少 return | 增加基线返回逻辑,阻止向负数深入 |
| 递归参数 | hanoi(n - 1, ...) |
hanoi(n, ...) |
检查函数调用实参,确保每次减 1 |
| 非法值输入 | if n <= 0: return |
传入 0、负数或浮点数 | 在函数入口处添加参数类型与范围校验 |
| 输入规模 | 常规测试 n = 3 ~ 15 |
测试 n >= 1000 |
认清 2n 复杂度,设置合理测试规模 |
通过以上排查与规范编写,再次运行汉诺塔程序时,调用栈深度将严格受控在盘数 n 之内,RecursionError 问题便可彻底解决。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















