


Python批量注释符号:三引号与#的区别及正确用法
详细解析Python中批量注释的机制与方法,深入对比井号(#)与三引号('''或""")的底层差异、潜在风险及最佳实践,帮助开发者掌握规范高效的代码注释方式。
许多刚接触 Python 的开发者在需要暂时停用一段代码或添加多行说明时,常常会四处寻找类似 C 语言 /* ... */ 的多行注释符号,并很快被推荐使用三引号(''' 或 """)。然而,Python 官方语法中并不存在真正的多行注释符号,官方规范(PEP 8)唯一认可的注释符号只有井号(#)。三引号本质上是多行字符串字面量,将其作为“批量注释”不仅违背了语言设计初衷,还会带来隐蔽的语法与运行时风险。本文将清晰拆解两者的本质区别、潜在隐患以及生产环境中的正确批量注释方案。
一、核心本质差异:词法注释与字符串常量
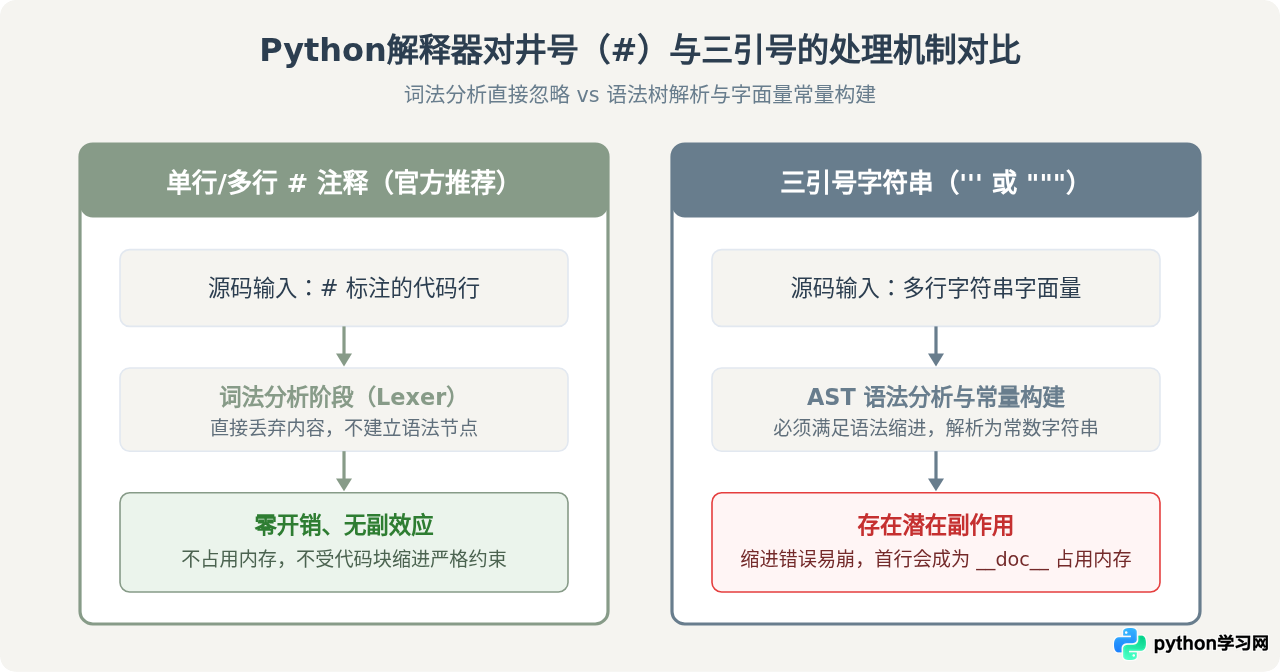
要理解为什么不能盲目使用三引号作为批量注释,首先需要观察 Python 解释器在编译代码时对待两者的不同机制。
- 井号(
#):真正的注释。Python 解释器在词法分析阶段(Lexing)扫描到#时,会直接将该符号直至行尾的所有字符全部丢弃。它们不会进入抽象语法树(AST),不会生成任何字节码指令,更不会在程序运行时占用任何计算资源或内存空间。 - 三引号(
'''或"""):多行字符串字面量。三引号是完整的 Python 表达式。只要它们没有被语法错误阻断,词法分析器就会将其完整解析为字符串常量。虽然如果该常量孤立存在且未赋值给任何变量,编译器在优化阶段可能会剔除没有副作用的代码段,但它仍然必须遵循 Python 严格的语法规则和缩进约定。此外,当它位于模块、类或函数的首行时,解释器会强制将其捕获并绑定为对象的__doc__属性。
二、用三引号代替注释的三个高发陷阱
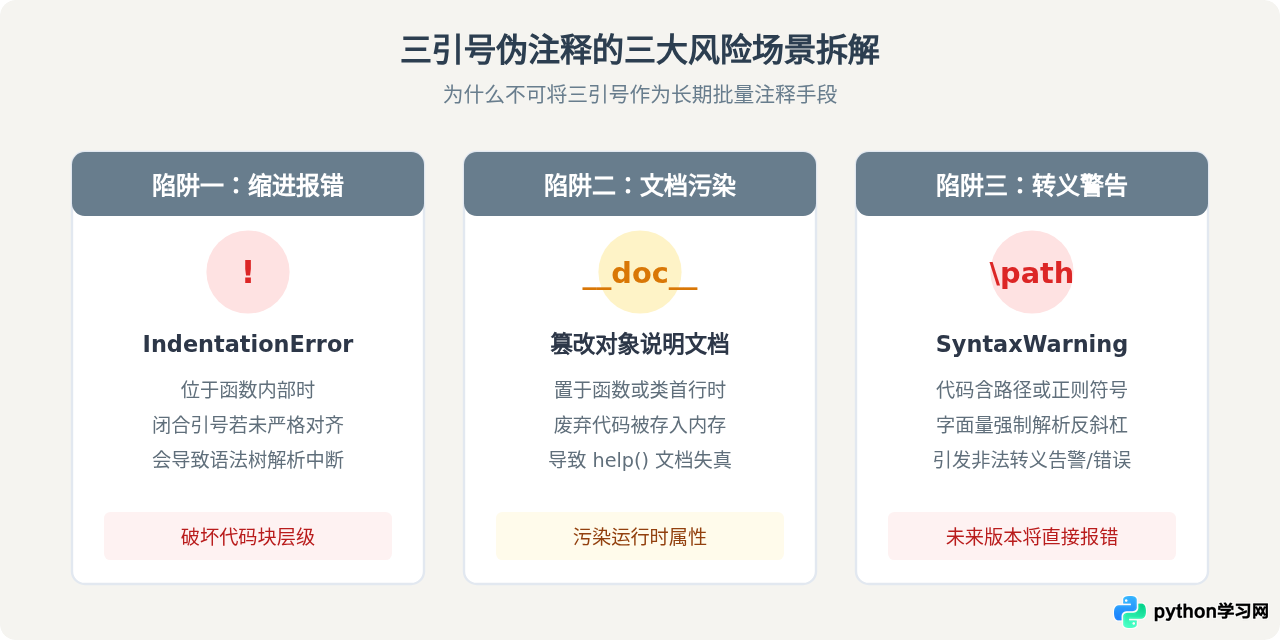
虽然在很多情况下,临时在模块空白处包上一段三引号不会立刻报错,但如果将其作为常规习惯,在以下三种常见场景中极易引发隐蔽故障。
1. 严格缩进要求引发的 IndentationError
因为三引号包裹的内容属于语法树中的代码表达式,如果被注释的代码处于函数、循环或分支结构内部,闭合的三引号必须严格与当前代码块的缩进级别对齐。如果将三引号顶格写在最左侧,Python 解释器在读取下一行时会直接报 IndentationError 异常;而真正的 # 注释无论处于何种缩进位置,都能被安全解析。
def calculate_tax(income):
    base = 5000
    # 错误示范:闭合三引号破坏了缩进逻辑
    """
    if income <= base:
        return 0
"""  # <-- 此处顶格将直接导致后续代码产生 IndentationError
    rate = 0.2
    return (income - base) * rate
2. 篡改函数或类的文档属性(__doc__)
根据 Python 的语法规范,任何模块、类或函数定义后的第一个没有赋值给变量的字符串字面量都会被自动捕获为该对象的 __doc__。如果开发者习惯在函数开头用三引号注释掉一段旧逻辑,这段废弃代码就会直接替换函数原有的帮助文档,导致 help(func) 输出垃圾废弃代码,并在自动化 API 文档生成工具(如 Sphinx)中引发错乱。
def fetch_user_data(user_id):
    """
    旧版废弃逻辑(被三引号注释):
    # response = requests.get(f"/api/v1/user/{user_id}")
    # return response.json()
    """
    # 此时 fetch_user_data.__doc__ 已经被废弃代码霸占!
    return db.query(User).filter_by(id=user_id).first()
3. 转义字符与正则代码引发语法告警(SyntaxWarning)
当被注释的代码段包含文件路径(如 C:\new_folder)或正则表达式(如 \d+)时,三引号会将其当作普通字符串进行转义求值。在现代 Python 版本(Python 3.8+)中,无效的转义序列会抛出 SyntaxWarning,并在未来的主版本中升级为直接致命的 SyntaxError。而 # 是纯文本注释,任何反斜杠与转义符号都不会被编译器解析。
三、真正规范的做法:现代 IDE 的批量注释操作
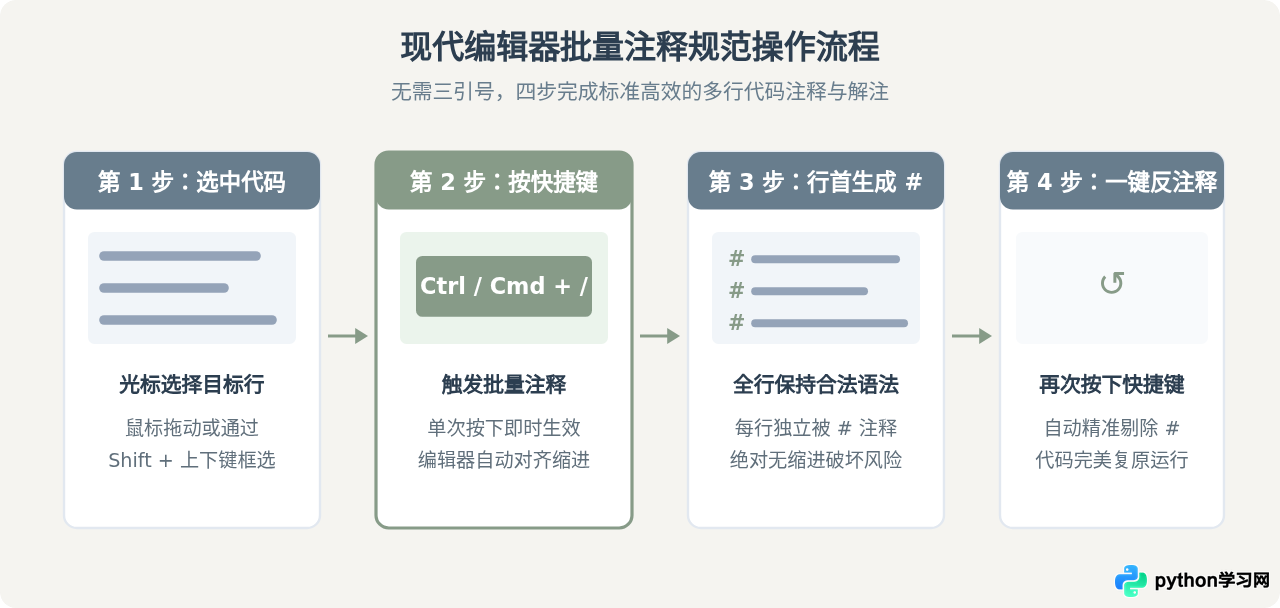
既然 Python 官方坚持只使用 # 作为注释,那么在开发过程中,如何快速对数十行甚至上百行代码进行批量注释与反注释?答案是:借助现代代码编辑器与 IDE 的快捷键功能。无论是 VS Code、PyCharm、Jupyter Notebook 还是 Sublime Text,都内置了一键批量加/减 # 的功能。
# 与注释文字之间应保留一个空格。现代编辑器在批量为选中文本增加 # 时,都会自动处理好前导缩进与空格,确保代码既符合 PEP 8 风格指南,又不会引发任何缩进报错。
常见开发环境批量注释快捷键一览
| 开发工具 / 编辑器 | Windows / Linux 快捷键 | macOS 快捷键 | 操作行为与效果 |
|---|---|---|---|
| VS Code | Ctrl + / |
Cmd + / |
选中文本后按下,自动在每行添加或移除行首 # |
| PyCharm | Ctrl + / |
Cmd + / |
行注释切换;支持智能对齐当前代码块的基础缩进 |
| Jupyter Lab / Notebook | Ctrl + / |
Cmd + / |
支持在单元格内多行选中一键切换 # 注释 |
| Vim / Neovim | Visual 模式 Ctrl + v 块选后 I# <Esc> |
相同 | 列块模式批量插入 # ,或借助 Comment.nvim 插件 |
四、三引号的正确舞台:文档字符串(Docstring)
既然三引号不适合作为注释,那么它在 Python 中的官方正规用途到底是什么?官方 PEP 257 详细规定了三引号的职责:编写模块、类、方法及函数的文档字符串(Docstring)。
文档字符串不仅能帮助团队成员快速阅读代码功能,还能被 Python 内置的 help() 函数以及各类代码提示工具(LSP)自动提取。标准的 Docstring 通常有两种形态:
1. 单行文档字符串
适用于功能极其简单直接的函数,简述该函数完成了什么操作并返回值:
def square(number):
    """计算并返回给定数字的平方值。"""
    return number ** 2
2. 多行文档字符串(遵循 Google 风格或 NumPy 风格)
适用于包含参数、返回值、异常说明以及使用示例的复杂业务逻辑:
def query_order(order_id: str, timeout: int = 10) -> dict:
    """根据订单号查询订单实时详情。

    Args:
        order_id: 32位唯一订单流水号字符串。
        timeout: 网络查询超时时间(单位:秒),默认10秒。

    Returns:
        包含订单详情的字典对象,例如 {"id": "...", "status": "PAID"}。

    Raises:
        ValueError: 当 order_id 格式不合法时抛出。
        TimeoutError: 当网络查询超过设定阈值时抛出。
    """
    if not order_id or len(order_id) != 32:
        raise ValueError("非法的订单ID格式")
    # 具体业务请求逻辑...
    return {"id": order_id, "status": "SUCCESS"}
五、决策树与使用场景终极总结
为了在实际编码过程中不产生犹豫,我们可以将 Python 中注释与文档的使用场景总结为简明的决策树:
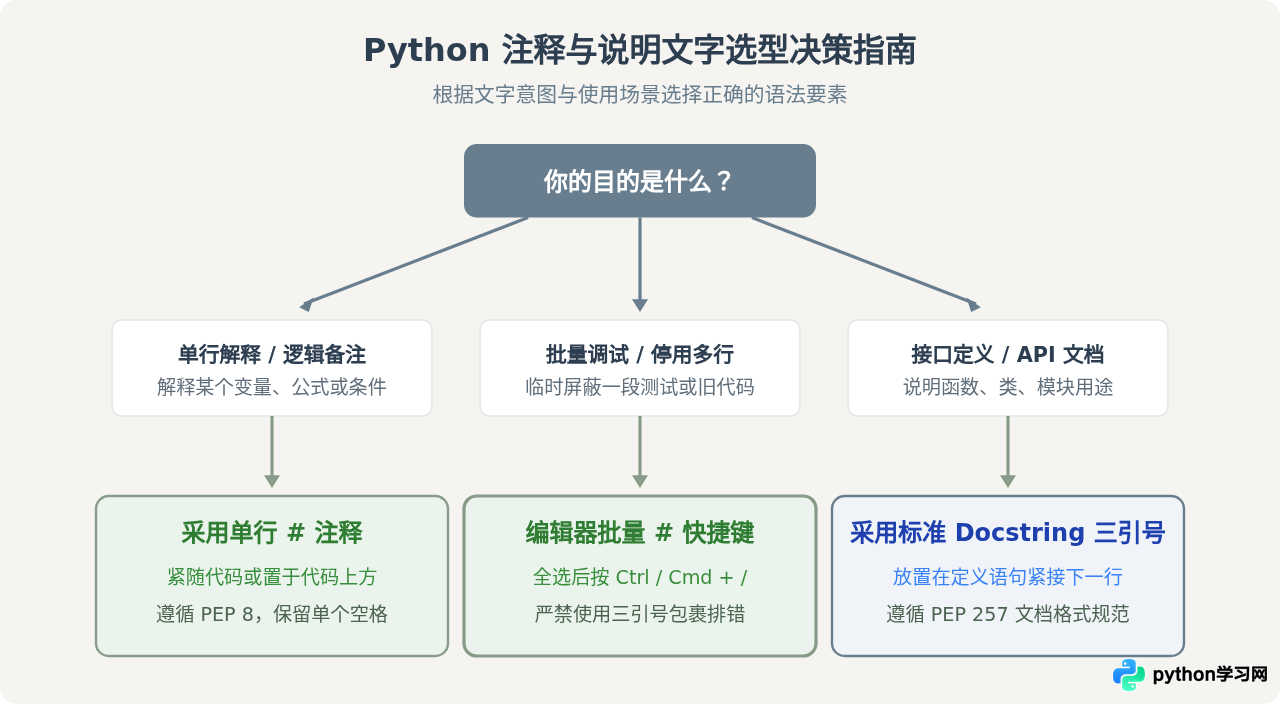
六、常见问答与实践建议
Q1:既然三引号不是官方注释,为什么 Python 官方解释器执行它时通常不会报错?
在 Python 中,任何独立存在的表达式语句(Expression Statement)本身都是合法的语法结构。例如,你在一行代码中只写一个数字 42 或普通字符串 "hello",解释器都不会报语法错误。三引号只是一个可以跨多行的字符串字面量常量,未绑定变量时在解释执行中通常会被当成无副作用的表达式忽略。不报错并不等于它是语法上被设计的注释功能。
Q2:如果我实在想用多行字符做大段设计说明,有什么折中方式?
如果需要在函数内部写非常详尽的算法设计说明,最干净的做法仍然是每一行都以 # 开头。在 VS Code 或 PyCharm 中,选中所有说明文字一键按下快捷键即可瞬间完成。这不仅符合 PEP 8 的格式规范,也能确保静态代码检查工具(如 flake8、mypy、pylint)不会将其识别为死代码(Useless statement)或字符串资源泄漏。
Q3:生产环境中应该如何规范团队的注释习惯?
建议在持续集成(CI)流水线或本地 Git pre-commit 钩子中引入 flake8 或 ruff 等静态检查工具。开启 B018(无用表达式检测)等规则后,工具会自动捕获代码块内随意裸写的三引号并发出警告,帮助团队彻底杜绝用三引号充当批量注释的不良习惯,保障代码库的纯净与稳定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















