


数据分析与AI训练:运行Python高负载任务的电脑配置建议
针对Python数据分析与AI模型训练的高负载场景,系统梳理CPU、GPU、内存、显存与存储的选型依据,提供清晰的配置选型方案与瓶颈排查方法。
运行Python高负载任务的核心选型法则是分清瓶颈归属:数据分析(Pandas/Polars/Scikit-learn)属于“大内存与高频CPU密集型”,优先保障系统物理内存与单核高主频;而AI深度学习(PyTorch/TensorFlow)属于“大显存与张量算力密集型”,显卡显存容量决定模型能否运行,Tensor Core吞吐决定训练周期。
一、Python高负载计算的硬件协同与瓶颈流动
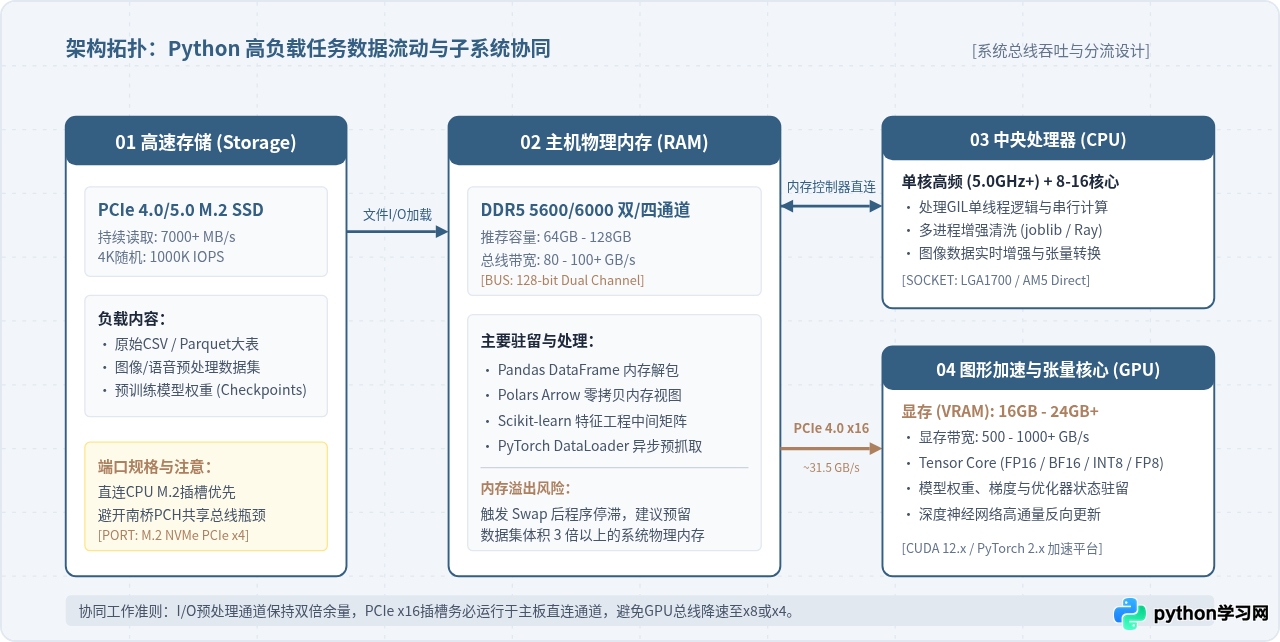
在进行Python计算时,不同库和框架调动的底层硬件存在本质差异。常规的数据预处理与特征工程依赖CPU的多进程与系统内存,而神经网络的反向传播与矩阵乘法完全卸载到GPU端执行。了解数据在系统总线中的流转逻辑,是避免“高配低效”的关键。
许多开发者误以为配置了旗舰显卡就能解决一切性能问题,但如果数据在PCIe总线与内存之间搬运过慢,GPU往往会陷入漫长的等待(CUDA Kernel等待DataLoader数据就绪)。典型的软硬件瓶颈分布如下:
- 数据加载与缓存(存储层):当读取数十GB的CSV或Parquet数据集时,NVMe固态硬盘的持续与随机读取速度直接决定启动耗时。
- 表结构变换与聚合(内存层):Pandas执行全表合并或重采样时,内存峰值开销可达原数据集体积的3到5倍。如果物理内存耗尽触发操作系统Swap交换分区,计算速度会遭遇数千倍的断崖式下跌。
- 预处理与特征清洗(CPU层):受制于Python全局解释器锁(GIL),纯Python循环仅利用单核算力,依赖高主频;而多进程数据分片(如PyTorch的
num_workers)则需要足够的物理核心。 - 张量矩阵乘加(GPU层):数据通过PCIe通道推送入显卡显存(VRAM),由CUDA核心与Tensor Core执行大规模并行前向与反向梯度计算。
二、AI训练与大模型微调的核心瓶颈:显存容量与计算架构
在进行深度学习(如计算机视觉、自然语言处理)或本地大模型(LLM)微调时,最常见且致命的错误是 CUDA out of memory(OOM)。显存具有严格的物理上限,一旦显存被填满,程序将直接崩溃退出,无法像CPU那样通过虚拟内存平滑降速运行。
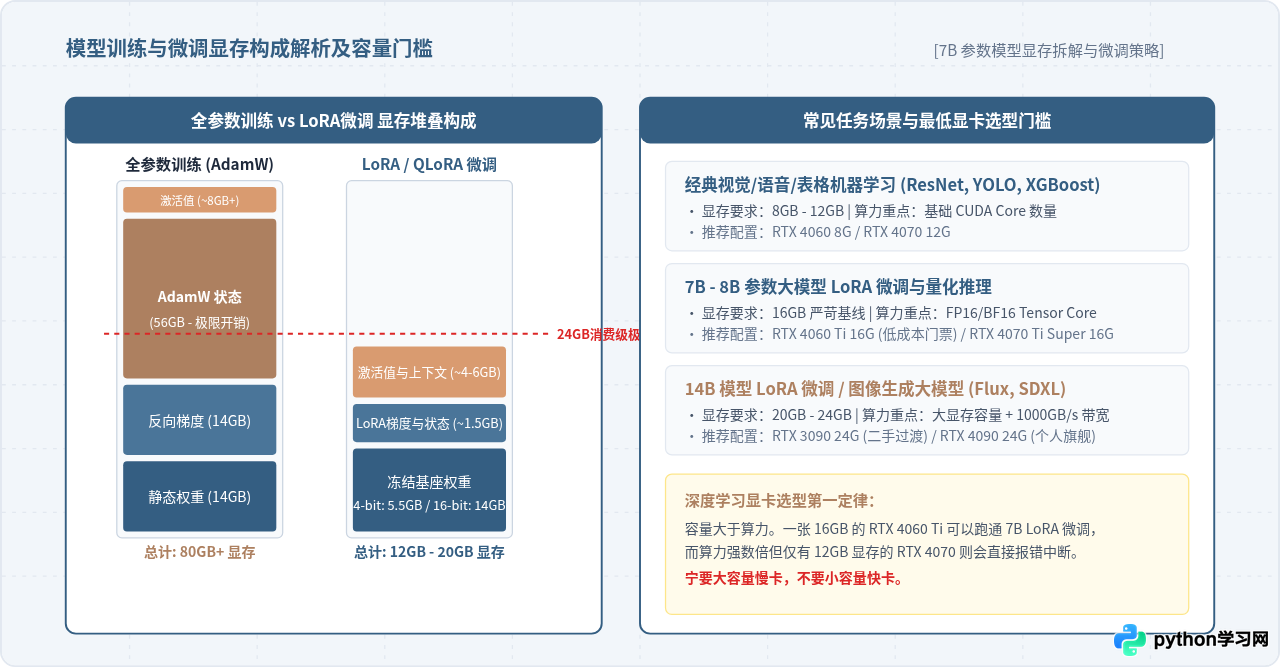
评估显存需求不能仅仅看模型的参数量大小,必须精确计算模型在训练生命周期中的组成部分:
- 模型静态权重:采用 16 位浮点数(FP16 或 BF16)保存时,每个参数占用 2 字节。例如一个 7B(70亿参数)模型,仅静态权重就需要约 14GB 显存。
- 梯度(Gradients):反向传播计算梯度同样以 FP16/BF16 存储,额外消耗 2 字节/参数(7B 模型约 14GB)。
- 优化器状态(Optimizer States):最常用的 AdamW 优化器需要维护一阶动量(FP32,4字节)和二阶动量(FP32,4字节),合计 8 字节/参数。仅优化器一项就会消耗 56GB 显存!这也是为什么消费级单卡无法对 7B 模型进行全参数训练的根本原因。
- 激活值与上下文缓存(Activation Memory):受 Batch Size(批大小)和 Sequence Length(序列长度)影响,激活值随着训练深度和并发量成正比增长。
因此,在单卡 24GB 显存的显卡(如 RTX 4090)上,主流解决方案是采用 LoRA / QLoRA 阶段微调。LoRA 仅冻结基座模型权重并微调极少数适配器参数(通常小于总参数量的 1%),大幅度削减了优化器状态与梯度的显存开销,使得 7B 至 14B 参数量的模型得以在 24GB 显存内流畅训练。
三、硬件选型与系统落地的四步评估法
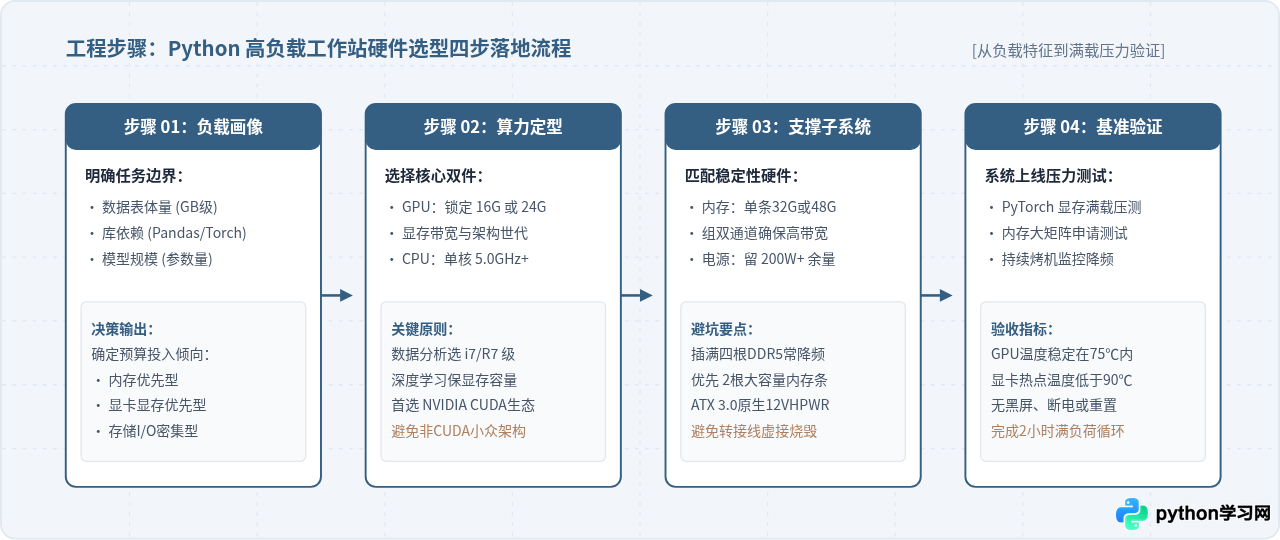
选购或组装用于 Python 计算的工作站时,切忌盲目按照游戏主机的配置照单全收。游戏电脑偏向“显卡高配、内存适中(32G)、CPU重多核超频”,而数据科学与AI训练则需要严格评估各环节的耐压与持续输出能力。请遵循以下四步法:
装机后的Python环境与硬件基准验证脚本
在机器部署完毕后,建议直接在Python环境中运行一段基准检测脚本,确认CUDA驱动状态、物理显存识别、PCIe带宽传输以及高负载矩阵乘法是否稳定:
import sys
import time
import torch

def verify_hardware_environment():
    print(f"=== Python 运行环境 ===")
    print(f"Python 版本: {sys.version.split()[0]}")
    print(f"PyTorch 版本: {torch.__version__}")

    # 1. 验证 CUDA 与 GPU 硬件可用性
    cuda_available = torch.cuda.is_available()
    print(f"CUDA 可用状态: {cuda_available}")
    if not cuda_available:
        print("[警告] 未检测到可用 CUDA 设备,任务将回退至 CPU 缓慢运行!")
        return

    device_count = torch.cuda.device_count()
    current_device = torch.cuda.current_device()
    device_name = torch.cuda.get_device_name(current_device)
    total_memory_gb = torch.cuda.get_device_properties(current_device).total_memory / (1024 ** 3)

    print(f"检测到 GPU 数量: {device_count}")
    print(f"当前主设备: {device_name}")
    print(f"物理显存容量: {total_memory_gb:.2f} GB")

    # 2. 模拟高负载张量矩阵乘法 (GEMM 压测)
    print("\n=== 执行 FP16 高负载张量压测 ===")
    matrix_dim = 16384  # 16K x 16K 矩阵
    print(f"分配两组 {matrix_dim}x{matrix_dim} FP16 矩阵至显存...")

    try:
        start_mem = torch.cuda.memory_allocated() / (1024 ** 3)
        a = torch.randn(matrix_dim, matrix_dim, device="cuda", dtype=torch.float16)
        b = torch.randn(matrix_dim, matrix_dim, device="cuda", dtype=torch.float16)
        allocated_mem = torch.cuda.memory_allocated() / (1024 ** 3)
        print(f"显存占用增量: {allocated_mem - start_mem:.2f} GB")

        # 预热 GPU
        _ = torch.matmul(a[:1024, :1024], b[:1024, :1024])
        torch.cuda.synchronize()

        # 计时 10 次全尺寸乘加迭代
        start_time = time.time()
        iterations = 10
        for i in range(iterations):
            c = torch.matmul(a, b)
        torch.cuda.synchronize()
        elapsed = time.time() - start_time

        tflops = (2 * (matrix_dim ** 3) * iterations) / (elapsed * 1e12)
        print(f"完成 {iterations} 次高负载矩阵乘法,耗时: {elapsed:.3f} 秒")
        print(f"实测有效算力: {tflops:.2f} TFLOPS")
        print("[成功] 硬件通信与张量计算核心工作正常!")

    except RuntimeError as e:
        print(f"[失败] 发生显存溢出或执行异常: {e}")

if __name__ == "__main__":
    verify_hardware_environment()
watch -n 1 nvidia-smi,Windows 下使用任务管理器性能页)。重点观察显存占用是否平稳达到预期、GPU 功耗是否达到额定 TDP、以及风扇转速上升时核心温度是否稳在 80℃ 以下。
四、不同应用场景的具体配置清单与决策总结
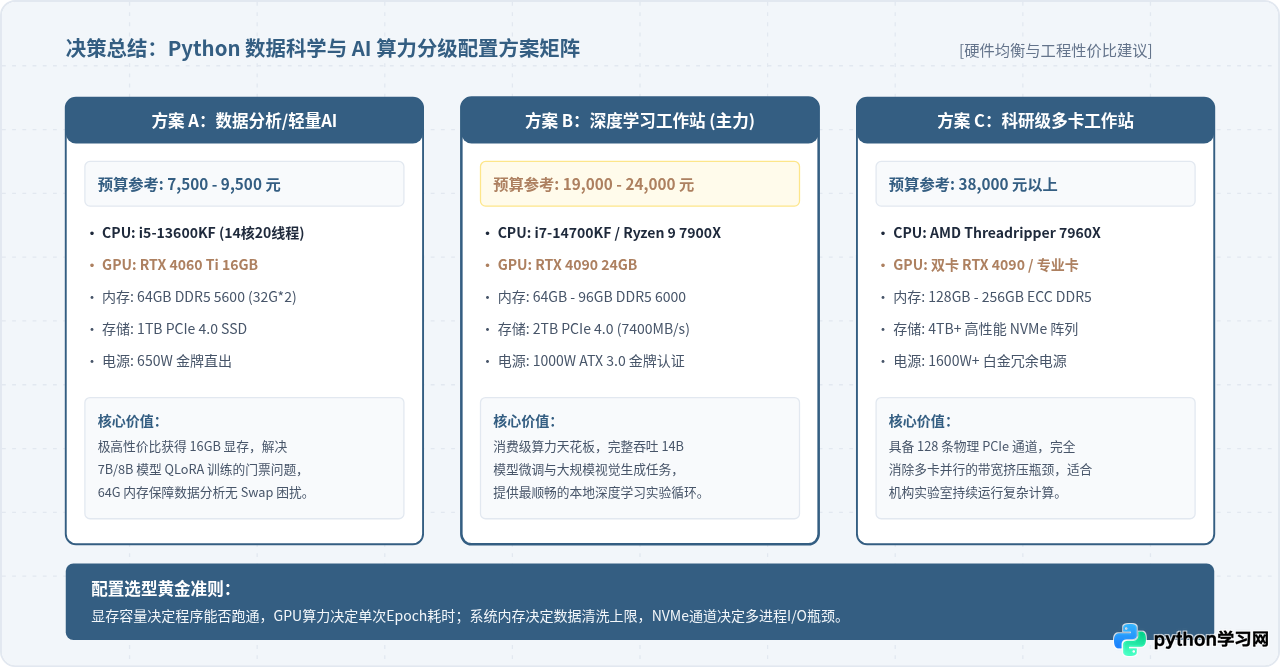
为了帮助不同需求层次的开发者精准分配预算,我们根据主流数据分析与 AI 任务的特征,整理了三套具有明确工程适用边界的配置方案:
| 配置级别 | 核心定位与适用场景 | 推荐核心硬件规格 | 预算参考区间 |
|---|---|---|---|
| 入门/中度数据分析 | 千万级表格统计 (Pandas/Polars)、Scikit-learn、LightGBM、7B大模型轻量推理 |
· CPU: Intel i5-13600K / AMD Ryzen 7 7700 · GPU: NVIDIA RTX 4060 Ti 16GB · 内存: 64GB (32GB x 2) DDR5 5600 · 存储: 1TB PCIe 4.0 NVMe (7000MB/s) |
约 7,500 - 9,500 元 |
| 深度学习与模型微调 | 7B/14B 大语言模型 LoRA/QLoRA 训练、Stable Diffusion/Flux 图像生成、中大规模特征工程 |
· CPU: Intel i7-14700K / AMD Ryzen 9 7900X · GPU: NVIDIA RTX 4090 24GB · 内存: 64GB - 128GB (48GB x 2 或 32GB x 4) · 存储: 2TB PCIe 4.0 NVMe + 4TB 机械归档 |
约 19,000 - 24,000 元 |
| 科研与重度训练工作站 | 多卡并行微调、高并发数据回测、私有化知识库与大规模视觉预训练 |
· CPU: AMD Threadripper 7960X / i9-14900KS · GPU: 双卡 RTX 4090 24GB 或 单卡 RTX 6000 Ada 48GB · 内存: 128GB - 256GB ECC DDR5 · 存储: 4TB NVMe 系统盘 + PCIe 扩展阵列 |
约 38,000 元以上 |
五、工程装配与长期运行注意事项
选定零部件后,在实际组装与生产部署中,还有三个极易被忽视但直接影响稳定性的工程细节:
- DDR5 内存的四插槽降频陷阱:在当前消费级主板(Intel Z790 / AMD B650/X670)上,由于主板走线拓扑限制,插满 4 根 DDR5 内存通常会导致内存控制器无法维持高频率,甚至会从 6000MHz 降频至 4000MHz 或 3600MHz。因此,需要 64GB 或 96GB 内存时,强烈建议选择单条 32GB 或 48GB 的双条套条,保持双通道高效运行。
- PCIe 通道分配与显卡插槽选择:主流消费级 CPU 仅提供 16 条直连显卡的 PCIe 通道。主板上的第一条 PCIe x16 插槽直连 CPU,而第二、第三条通常走南桥芯片组(PCH)共享带宽。GPU 必须插在第一条插槽上,确保拥有完整的 PCIe 4.0/5.0 x16(31.5 GB/s)吞吐,切勿因机箱空间不足移至副插槽。
- ATX 3.0 电源与 12VHPWR 原生供电:RTX 40 系列高端显卡具有极高的瞬间动态功耗峰值(Transient Spikes)。务必选用符合 ATX 3.0 规范并配备原生 16-pin(12VHPWR)供电线的电源,避免使用老旧多路 8-pin 转接线,并在插入时确认接头完全卡紧入位,防止接触电阻过大引起发热损坏。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















