


Python主流爬虫库选型对比:requests、Scrapy还是Playwright更适合你?
深度对比Python三大主流爬虫工具requests、Scrapy与Playwright的底层架构、核心优势、资源消耗与适用边界,提供详尽的操作选型决策路径与避坑指南。
一、核心架构与运行模型差异
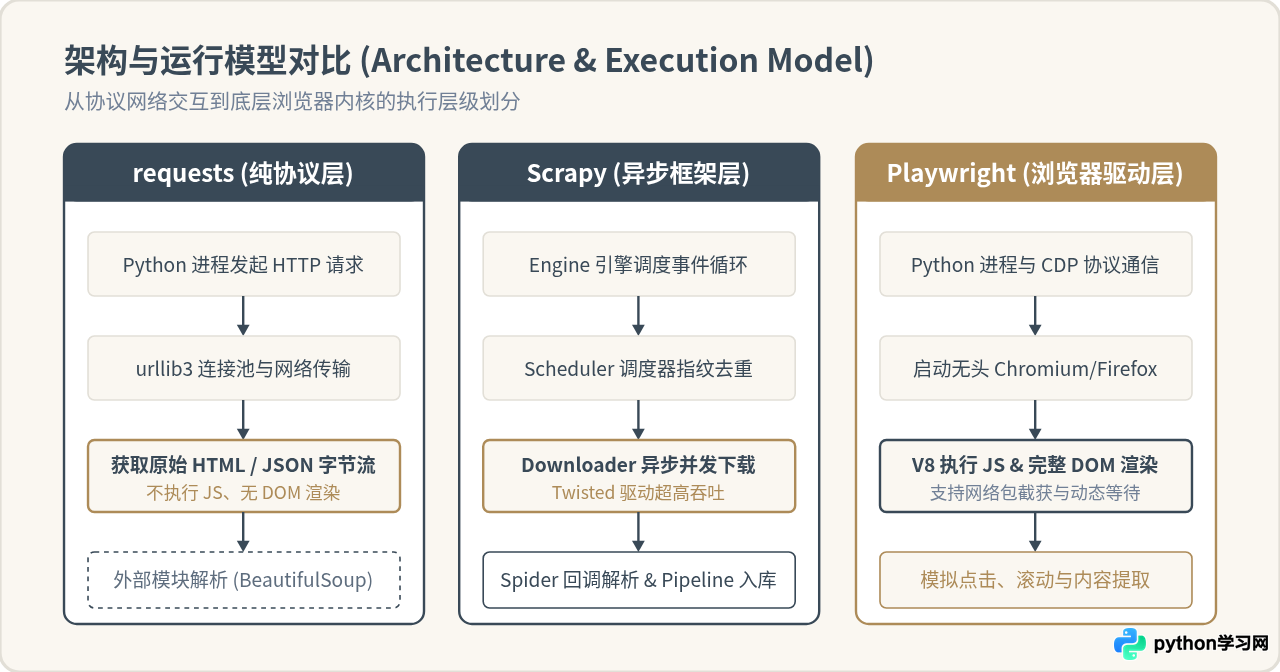
选型的本质是理解不同工具在网络协议栈中所处的层级。很多初学者容易将这三者混为一谈,甚至尝试用纯 HTTP 请求库去死磕前端动态混淆加密,或者用重量级浏览器内核去抓取数百万个纯静态页面,最终导致项目维护成本飙升或资源耗尽崩溃。
从底层交互模型来看,三者代表了三种截然不同的处理哲学:
- requests(纯协议层):基于底层
urllib3封装的同步阻塞式 HTTP 客户端。它的职责极其专一——构造合规的 HTTP 请求报文、发送至服务器并接收原始二进制字节流。它完全不解析 DOM,更不包含任何 JavaScript 虚拟机。后续的数据提取必须依赖外部库(如 BeautifulSoup、lxml 或标准库 json)。 - Scrapy(异步框架层):基于
Twisted事件驱动架构构建的大规模爬虫流水线系统。它通过 Engine 引擎协调 Scheduler(请求队列与去重)、Downloader(异步高吞吐下载)、Spiders(解析逻辑)与 Item Pipeline(数据清洗存储),形成了完整的生产级工业闭环。 - Playwright(浏览器内核驱动层):微软开源的现代端到端自动化利器。它通过 Chrome DevTools Protocol (CDP) 等协议,直接双向控制真正的 Chromium、Firefox 或 WebKit 浏览器内核。网页在 Playwright 中会经历完整的样式计算、V8 引擎脚本执行与 DOM 挂载。
二、三大库的技术特性与代码范例
1. requests:敏捷抓取与数据接口的首选
requests 被誉为“人类可读的 HTTP 库”。它的设计哲学是保持简单直接。在面对结构清晰的服务端直出页面或抓包逆向获得的 RESTful API 时,它提供了极为流畅的编写体验。
核心优势:
- 极低的学习门槛,只需掌握
get、post、请求头与参数传递即可上手。 - 进程内存占用极小(单个请求通常仅需几十 KB 内存),启动耗时微秒级。
- 透明的会话维持机制(
requests.Session),便于管理 Cookie 与底层 TCP 连接复用。
局限性:原生缺乏并发支持,面对百万级抓取必须自行配合 ThreadPoolExecutor 或改用 httpx/aiohttp;无法执行网页内部的 JavaScript 脚本。
import requests

def fetch_api_products():
    url = "https://example.com/api/products"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
        "Accept": "application/json"
    }
    params = {"category": "books", "page": 1}

    try:
        response = requests.get(url, headers=headers, params=params, timeout=10)
        # 严格校验 HTTP 响应状态码
        response.raise_for_status()
        data = response.json()

        for item in data.get("items", []):
            print(f"商品: {item.get('name')} | 价格: ¥{item.get('price')}")

    except requests.exceptions.Timeout:
        print("请求超时,需记录重试队列")
    except requests.exceptions.RequestException as e:
        print(f"网络请求异常: {e}")

if __name__ == "__main__":
    fetch_api_products()
2. Scrapy:大规模结构化抓取的工业重器
Scrapy 不是一个简单的网络请求库,而是一套严密的应用程序框架。它天生为大规模、可持续运行的数据采集流水线而设计。
核心优势:
- 异步高吞吐:底层基于 Twisted 事件循环,单机即可轻松维持数百个并发连接。
- 内置健壮的调度系统:提供基于 SHA1 哈希的请求去重、自动重试、失败重定向跟踪。
- 工程化分工:中间件(Downloader Middlewares)专管代理切换与请求头注入,管道(Item Pipeline)专管数据清洗、验证与持久化落库。
局限性:样板文件繁多,有严格的目录规范和生命周期,用于简单临时抓取时显得冗长笨重;同样不直接运行 JS 代码。
import scrapy

class CatalogSpider(scrapy.Spider):
    name = "catalog_spider"
    allowed_domains = ["example.com"]
    start_urls = ["https://example.com/catalog/books"]

    custom_settings = {
        "CONCURRENT_REQUESTS": 16,
        "DOWNLOAD_DELAY": 0.25,
        "ROBOTSTXT_OBEY": True,
        "COOKIES_ENABLED": False,
    }

    def parse(self, response):
        # 使用 CSS 选择器高效提取结构化卡片
        for card in response.css("div.product-card"):
            yield {
                "title": card.css("h2.title::text").get("").strip(),
                "price": card.css("span.price::text").get("").strip(),
                "url": response.urljoin(card.css("a::attr(href)").get("")),
            }

        # 自动跟踪下一页链接
        next_page = response.css("a.next-btn::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
3. Playwright:复杂动态渲染与交互破壁者
随着前端技术的发展,越来越多现代站点采用 React、Vue 等构建单页应用(SPA),数据往往通过 WebSocket 实时推送,或利用混淆后的 WASM / JS 动态计算鉴权签名。传统的逆向分析耗时费力,而 Playwright 能够以真实浏览器的身份渲染并获取最终状态。
核心优势:
- 真正的浏览器上下文:完整执行现代 ES 规范、WebAssembly、Canvas 绘图与 CSS 动画。
- 自适应智能等待:告别脆弱的
time.sleep(),Playwright 会自动等待元素挂载、可见、可交互。 - 强大的网络拦截功能:不仅能渲染页面,还能直接在浏览器发起网络请求时拦截抓取原始 JSON 响应包,实现“降维打击”。
局限性:内存与 CPU 资源开销极大,单进程启动浏览器内核可能耗费 100MB~300MB 内存;并发吞吐量相比 Scrapy 存在物理上限。
from playwright.sync_api import sync_playwright

def crawl_dynamic_spa():
    with sync_playwright() as p:
        # 启动无头 Chromium 实例
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            viewport={"width": 1366, "height": 768},
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        )
        page = context.new_page()

        try:
            # 访问动态渲染的目标页面并等待网络空闲
            page.goto("https://example.com/spa-feed", wait_until="networkidle")

            # 等待前端异步加载卡片渲染完毕
            page.wait_for_selector(".feed-card", timeout=8000)

            cards = page.locator(".feed-card").all()
            print(f"捕获到动态渲染节点总数: {len(cards)}")

            for card in cards:
                title = card.locator(".item-title").inner_text()
                tag = card.locator(".badge").inner_text()
                print(f"动态卡片: {title} [{tag}]")

        finally:
            context.close()
            browser.close()

if __name__ == "__main__":
    crawl_dynamic_spa()
三、实战选型决策操作路径
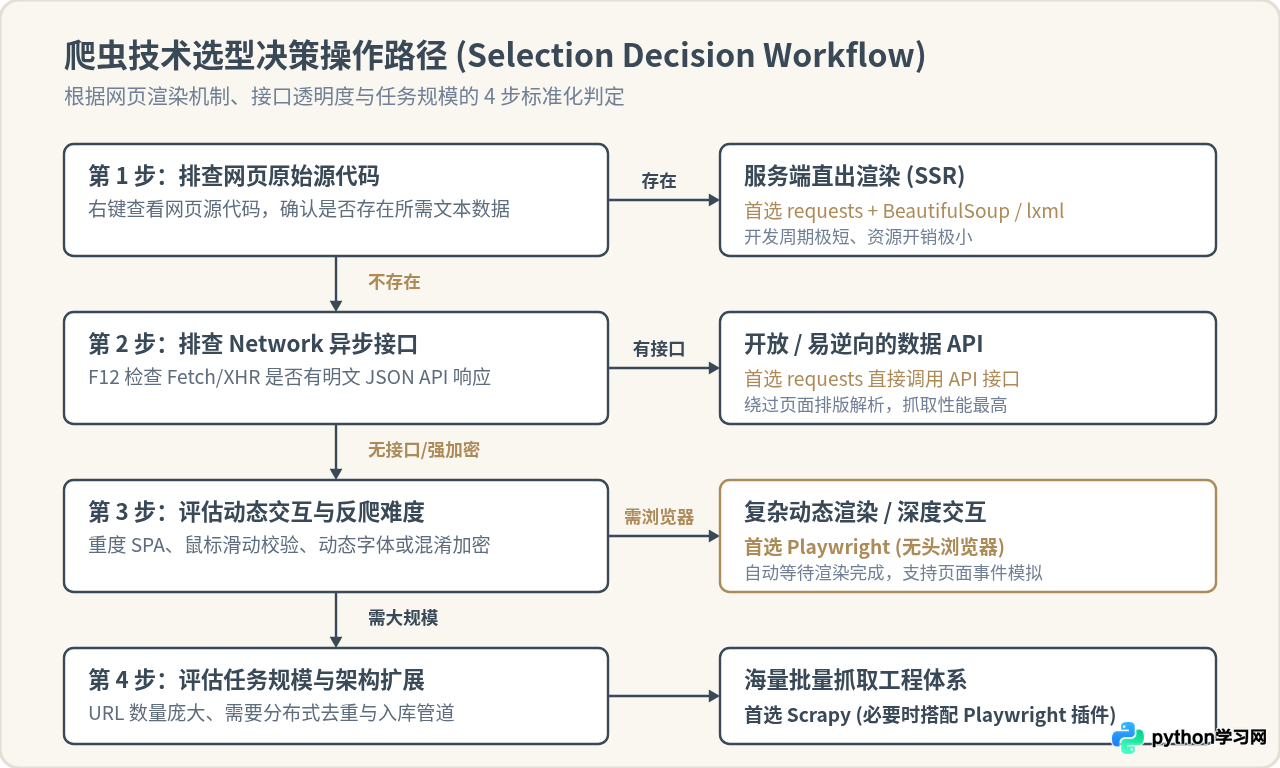
在实际项目启动前,不要盲目挑选熟悉的工具,而应按照标准化步骤对目标站点进行体检。以下是经过实战验证的 4 步排查与决策流程:
- 步骤一:验证服务端直出能力。在浏览器中打开目标页面,右键点击“查看网页源代码”(注意:不是“检查元素”)。在纯源码中搜索目标数据字段。如果能直接搜到,说明是服务端直接渲染,无需浏览器参与,进入轻量选型分支。
- 步骤二:排查 Network 异步接口。如果在源码中搜索不到目标文本,按 F12 打开开发者工具,切换到 Network 选项卡并刷新。筛选
Fetch/XHR类型请求。依次检查响应体(Response)。如果有结构清晰的明文 JSON,且请求头不包含极其复杂的动态时间戳签名,直接用requests模拟请求即可。 - 步骤三:评估前端加密与交互门槛。若关键数据包含重度前端混淆代码、字体反爬加密、或强制需要滑块拼图拖拽、复杂 Canvas 验证,强行逆向会大幅拉长开发周期。此时应迅速切换到
Playwright,利用真实浏览器环境直接读取已解密的 DOM 树。 - 步骤四:评估并发吞吐与工程生命周期。若仅需单次抓取数千条记录,轻量脚本快速交付即可;若目标任务为数十万到千万级 URL、需要多机器协同、周期性监控更新,则应当选择
Scrapy作为基础骨架,必要时结合scrapy-playwright扩展插件进行混合驱动。
四、抓取生命周期与流转环节对比
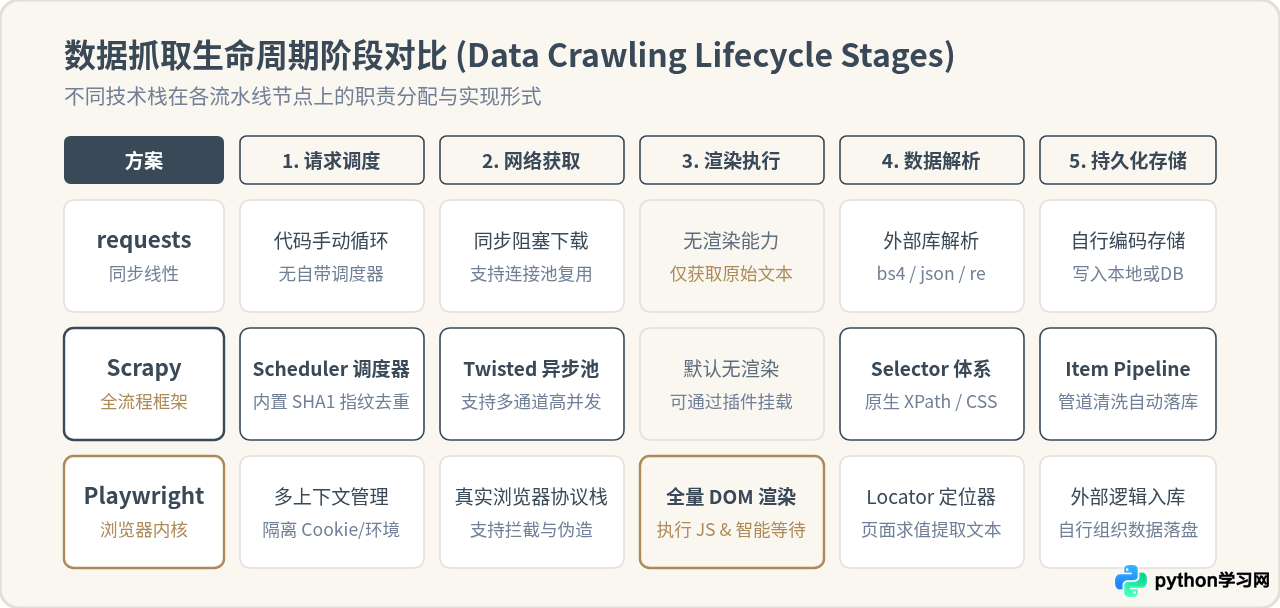
爬虫工作流可以划分为五个连续的生命周期阶段:请求调度、网络获取、渲染执行、数据解析与结果持久化。对比这五个阶段的处理方式,能更清楚地展现三者的工程边界:
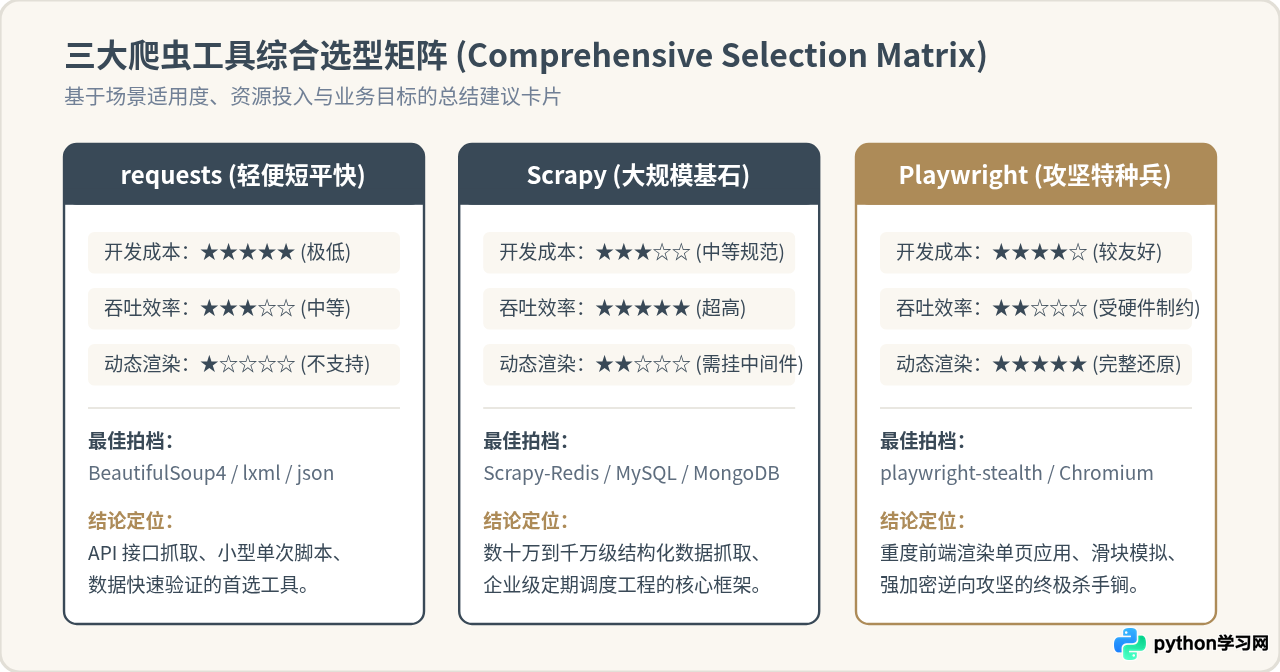
五、核心维度综合指标横向对比
为了更直观地衡量工程成本与收益,下表总结了三种工具在实际生产中的关键指标表现:
| 对比维度 | requests | Scrapy | Playwright |
|---|---|---|---|
| 底层原理 | HTTP 协议客户端 (urllib3) | 异步事件驱动爬虫框架 (Twisted) | 浏览器自动化驱动引擎 (CDP) |
| JavaScript 执行 | 完全不支持 | 默认不支持 (需额外挂载中间件) | 原生完全支持 (真实 V8 引擎) |
| 并发吞吐能力 | 低 (同步阻塞;需多线程辅助) | 极高 (异步事件机制,可达数千 QPS) | 受限 (受限于 CPU/内存与浏览器进程) |
| 内存资源消耗 | 极低 (单个请求约数 KB 至 MB 级) | 低至中等 (单引擎实例几十至上百 MB) | 极高 (每个无头浏览器通常需 100~400MB) |
| 反爬绕过难度 | 高 (易暴露 TLS 指纹与非真实环境) | 中等 (可自定义 Header 与代理中间件) | 较低 (天生具备真实浏览器上下文与环境) |
| 开发与维护成本 | 开发极快,单文件即写即跑 | 初期配置成本较高,后期维护极具条理 | 代码编写简单,但环境依赖与容器化偏重 |
| 典型推荐场景 | 开放 API、服务端直出页、快速验证脚本 | 中大型站全量爬取、持续监控、数据仓库建设 | 复杂 SPA、滑块验证码、防爬签名难破解的站点 |
六、生产环境常见误区与避坑指南
部分开发者由于不愿排查网络包,对任何网站都直接调用 Playwright 爬取数万个页面。这会导致严重的性能反噬:Chromium 实例不仅会产生大量无用的图片、字体与 CSS 渲染负载,长时间运行更可能因内存碎片导致机器卡死。
解决办法:优先通过 page.route() 拦截并终止图片、多媒体与样式文件加载;或者利用 Playwright 监听 response 事件直接截取底层 JSON 数据,而不是反复从 DOM 树中抓取文本。
Scrapy 的高性能完全依赖 Twisted 单线程事件驱动模型。一旦在 parse() 回调中调用了 time.sleep() 或同步写数据库模块,整个 Twisted 事件循环都会被强行卡住,导致其他数百个并发下载请求全部停滞。
解决办法:限速请在 settings.py 中配置 DOWNLOAD_DELAY;复杂的持久化操作应交由 Item Pipeline 处理,或使用 twisted.enterprise.adbapi 进行异步数据库写入。
requests.get() 默认不会设置 timeout。当目标服务器发生挂起或遭遇长阻塞连接时,爬虫进程将无限期挂起;如果在循环中频繁实例化 requests.get() 而不使用 requests.Session(),则会导致每一次请求都重新经历 TCP 三次握手与 TLS 协商。
解决办法:永远显式传递 timeout=(connect_timeout, read_timeout),并在循环任务中始终复用同一个 requests.Session 实例。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















