


Python爬虫的优缺点:为什么它是数据采集的首选语言
深入分析Python在网络数据采集领域的核心优势与局限性,客观对比开发效率与运行性能,剖析‘Python速度慢’的认知误区,并提供实用的采集技术栈选型决策指南。
网络爬虫的本质与标准采集流程
网络爬虫本质上是一种自动化程序,通过模拟客户端发起网络请求,获取目标服务器的响应内容,再从中提取、清洗并存储所需的信息。无论使用何种编程语言,其核心工作流程均由一系列紧密耦合的处理阶段组成。
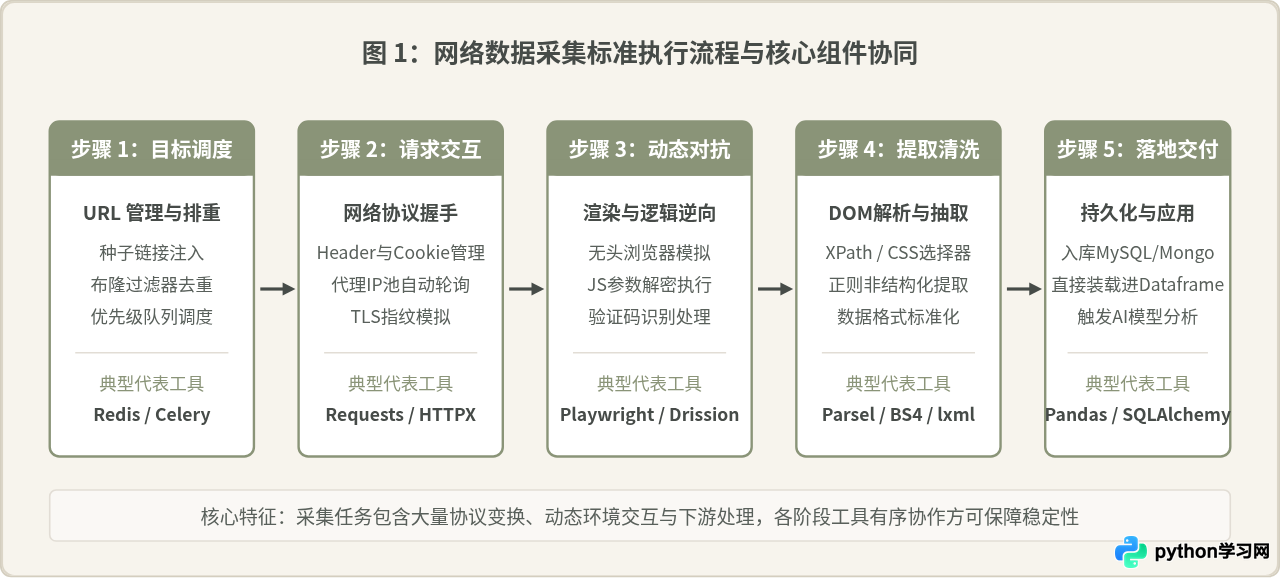
在上述流程中,网络通信、HTML/JSON解析、防风控拦截与持久化存储是四个核心节点。Python之所以在数据采集中独占鳌头,关键就在于它在这五个步骤中都有着极其完善的开箱即用支持。
为什么Python是数据采集的首选:四大核心优势
数据采集工程具有极强的特殊性:目标站点的结构不可控、防爬策略频繁变更、网络抖动不可避免。这决定了语言的迭代速度、调试成本和现成工具成熟度往往优先于纯算法执行效率。
1. 覆盖全生命周期的分层工具链生态
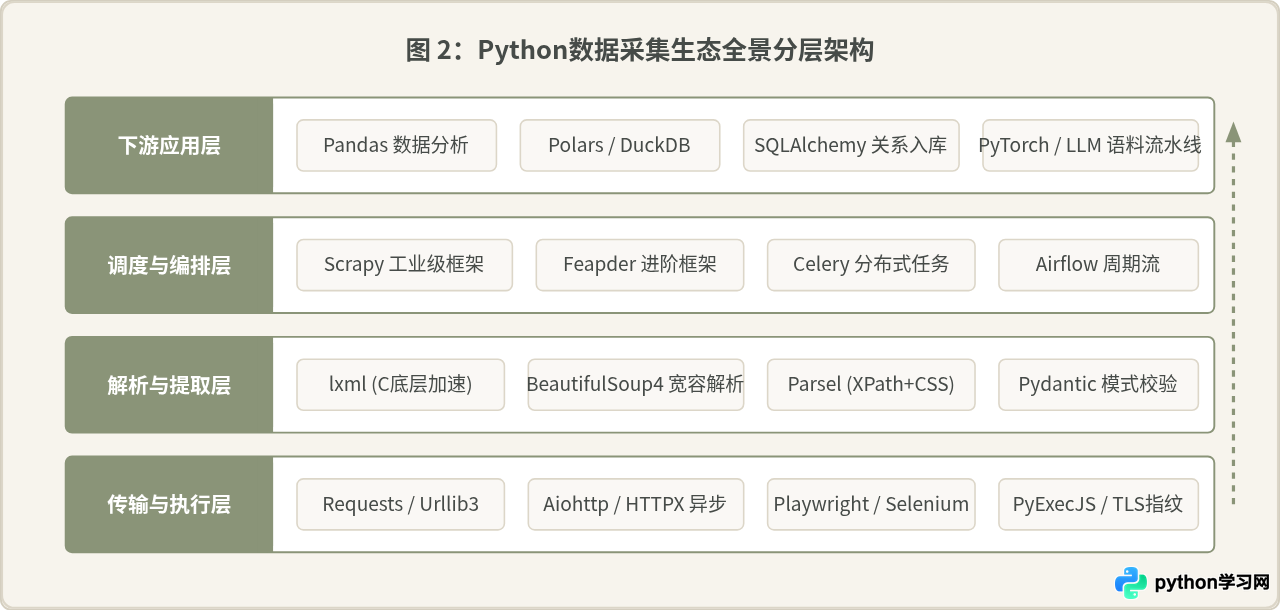
Python拥有业内覆盖最全面的爬虫工具链矩阵。从简单的单页面抓取,到具备异步高并发的现代网络库,再到分布式企业级抓取框架,开发者可以根据项目规模无缝切换:
- 轻量级与标准HTTP交互:
requests以其简洁优雅的API成为行业事实标准;httpx则原生支持HTTP/2和asyncio异步语法。 - 多语法HTML/XML解析引擎:
lxml基于C语言底层libxml2,提供极致的XPath与XSLT解析性能;BeautifulSoup4对畸形或不规范的HTML标签具备极佳的容错能力;parsel则将CSS选择器、XPath和正则表达式封装在统一链式调用中。 - 工业级抓取框架:
Scrapy内置了引擎、调度器、下载器中间件、爬虫中间件及数据管道(Pipeline),天然支持并发控制、自动限速(AutoThrottle)与失败重试。 - 现代动态渲染对抗:针对SPA单页应用与严格前端风控,
Playwright与Selenium提供了对Chromium、Firefox和WebKit的深度控制能力。
2. 极高的开发与调试效率
数据采集程序不是“编写一次便永久稳定运行”的系统。目标网站更新改版、反爬规则调整或页面结构重构是常态。
Python具备动态解释执行特性,配合交互式环境(如IPython或Jupyter Notebook),工程师可以在断点处直接抓取并解析实时响应。修改一个CSS选择器或补充一个字段清洗函数仅需数秒,无需经历编译打包流程。相比Java或Go,其整体调试周期通常缩短50%以上。
3. 与数据科学和下游处理无缝闭环
数据采集只是整个数据链条的起点。采集到的非结构化文本通常需要立即进行去重、统计、结构转换或喂给算法模型。
如果使用Go或Java采集,通常需要将数据先写入消息队列或中间数据库,再由Python数据管道读取处理,增加了架构复杂度与跨系统通信序列化开销。而在Python体系中,爬虫输出的字典可以直接无缝灌入pandas.DataFrame,直接执行向量化计算或特征工程,形成闭环流水线。
4. 完备的反爬对抗与前端逆向支持
现代网络采集的核心瓶颈早已不是抓取静态HTML,而是应对复杂的前端反爬手段,例如字体加密、JS参数签名(如Token、Cookie生成逻辑)、TLS握手特征检测以及滑动验证码。
Python社区积累了极其丰富的反向工程辅助库,例如用于快速执行混淆JS逻辑的执行器、模拟浏览器TLS/JA3指纹的curl_cffi、以及基于机器视觉和OCR的验证码解析工具包。这些工具极大降低了突破反爬防护的技术门槛。
生产级基础采集示例代码
以下是一个符合生产环境要求的Python采集函数,集成了自定义请求头、超时重试、状态码校验以及基于选择器的结构化提取逻辑:
# 运行环境:Python 3.10+
# 依赖安装:pip install httpx parsel tenacity

import logging
from typing import Optional, Dict, Any
import httpx
from parsel import Selector
from tenacity import retry, stop_after_attempt, wait_exponential, retry_if_exception_type

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("spider")

USER_AGENT = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36"

@retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential(multiplier=1, min=2, max=10),
    retry_if_exception_type((httpx.RequestError, httpx.HTTPStatusError)),
    reraise=True
)
def fetch_and_parse(url: str, timeout_sec: float = 8.0) -> Optional[Dict[str, Any]]:
    """
    抓取指定URL并提取文章标题与正文段落
    """
    headers = {
        "User-Agent": USER_AGENT,
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    }

    with httpx.Client(timeout=timeout_sec, follow_redirects=True) as client:
        logger.info(f"正在发起请求: {url}")
        response = client.get(url, headers=headers)
        response.raise_for_status()

        # 使用parsel进行DOM结构化抽取
        selector = Selector(text=response.text)
        title = selector.css("h1::text").get(default="").strip()
        paragraphs = selector.css("article p::text").getall()
        clean_text = "\n".join(p.strip() for p in paragraphs if p.strip())

        if not title:
            logger.warning(f"页面未匹配到主标题: {url}")
            return None

        return {
            "url": str(response.url),
            "status_code": response.status_code,
            "title": title,
            "content": clean_text
        }

if __name__ == "__main__":
    target = "https://example.com/sample-article"
    try:
        data = fetch_and_parse(target)
        print("提取结果示例:", data)
    except Exception as exc:
        logger.error(f"采集失败: {exc}")
不容忽视的短板与边界:Python爬虫的局限性
尽管Python是多数场景的首选,但在特定极端需求下,它自身的语言特性也会带来明显的工程瓶颈。
1. CPU密集型任务与GIL约束
Python的全局解释器锁(GIL)限制了单个进程内同一时刻只能有一个线程执行字节码。虽然大多数常规网络爬虫是I/O密集型任务(线程等待网络数据时会释放GIL),但在以下场景中CPU耗时会骤增:
- 高频的大体积HTML/XML文档解析;
- 在内存中密集执行解压、解密或超复杂正则表达式匹配;
- 通过Python环境频繁调用大量混淆JavaScript的逆向运算。
在这些CPU密集场景下,Python多线程无法利用多核性能,必须改用多进程(multiprocessing)架构,而这会带来更高的跨进程内存通信开销。
2. 内存消耗与大规模并发开销
相比Go、Rust或C++等编译型语言,Python对象的内存开销较大。一个空的Python字典或对象包装层往往占据数十字节至上百字节。
在维持数十万级别长连接或超大队列内存缓存时,Python常驻内存会显著偏高。使用Go语言的Goroutine可以轻松在几百兆内存中维持上万并发协程,而在Python中虽然有asyncio协助,但由于底层对象开销,同等并发下的内存消耗通常高出数倍。
3. 商业交付与代码资产保护较弱
Python属于解释型脚本语言,发布时分发的是.py源码或容易被反编译的.pyc字节码。对于需要向第三方独立交付、内嵌了核心逆向算法的商业爬虫软件,代码混淆与防破解成本远高于直接编译为二进制文件的Go或Rust。
认知辨析:“Python速度慢,所以不适合高并发爬虫”?
许多开发者常有一个直觉判断:“Python在基准测试中运行速度远落后于C++或Go,因此在大规模爬虫项目中Python必然成为性能瓶颈。”
这个说法在特定条件下看似合理,但在绝大多数实际网络采集工程中,这一推论并不成立。我们必须区分“算法执行耗时”与“网络I/O等待耗时”的本质区别。
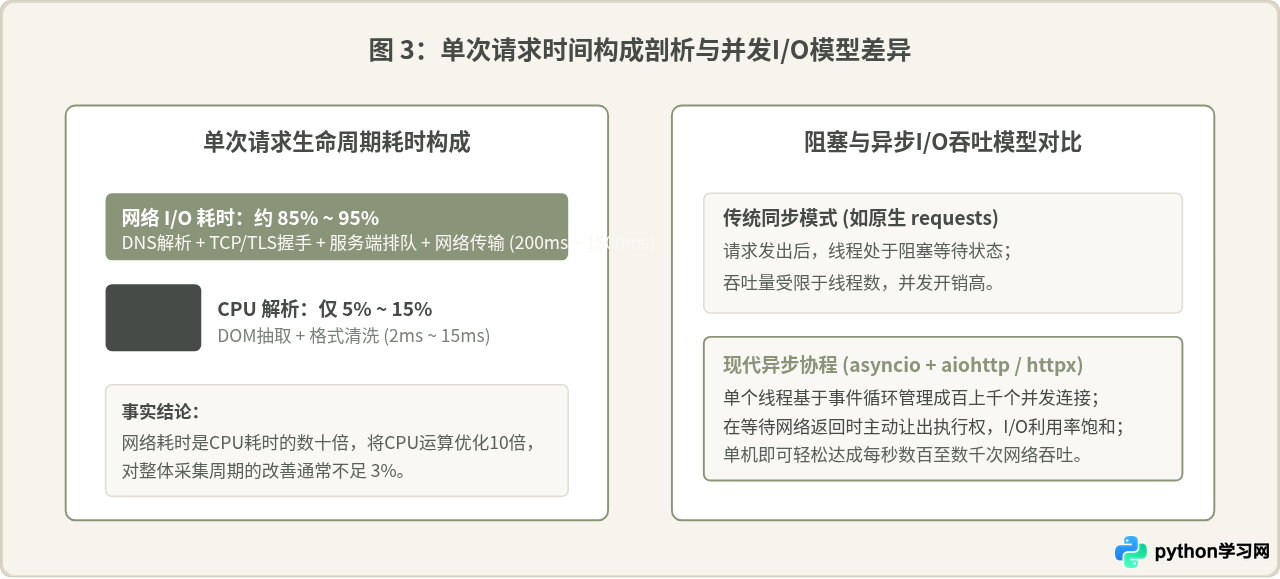
从图3的剖析可以看出:
- 爬虫是典型的I/O密集型应用:程序绝大部分时间都在等待远程服务器响应、DNS查询或网络数据传输。CPU本身的计算时间仅占总时间的极小比例。
- 真正的瓶颈在外部约束:在生产实践中,限制爬虫速度的往往不是语言性能,而是目标站点的风控限速(Rate Limit)、代理IP池的吞吐上限,以及带宽资源。即便用C语言发请求,如果目标站点每秒只允许来自同IP的5个请求,C语言也只能降速等待。
- 异步消除单线程瓶颈:引入
asyncio事件循环后,Python可以在单个系统线程内高效管理数千个Socket,完全抵消了以往同步等待带来的资源浪费。
什么时候该修正上述判断?如果你的任务是搜索引擎级别的全网原始网页抓取(要求单机维持数万QPS、抓取整个互联网并直接落盘),或者属于超大规模的内网网络空间测绘,此时CPU解析开销与内存占用会累积成主要矛盾。在这些极少数极限场景下,Go或Rust的高并发与轻量内存确实优于Python。
主流数据采集语言横向对比
为了给工程实践提供客观依据,我们将目前常用于数据采集的四种语言进行多维度对比:
| 对比维度 | Python | Go (Golang) | Node.js (JavaScript) | Java |
|---|---|---|---|---|
| 开发与调试速度 | 极高(动态交互、即改即测) | 较高(编译迅速、语法严谨) | 高(全栈同构、事件驱动) | 中等(样板代码较多) |
| 单机并发与资源开销 | 中等(协程可用,内存偏高) | 极高(轻量Goroutine,内存极省) | 较高(原生异步事件循环) | 高(线程开销偏大,JVM调优) |
| 爬虫框架成熟度 | 极丰富(Scrapy/Feapder等) | 良好(Colly/Geziyor) | 一般(Crawlee/偏轻量库) | 良好(WebMagic/Crawler4j) |
| 动态渲染与自动化 | 顶级(Playwright/Selenium) | 中等(chromedp较底层) | 顶级(Puppeteer/Playwright原生) | 良好(Selenium/Playwright-Java) |
| 前端逆向与JS调用 | 顶级(生态丰富、工具齐全) | 较弱(调用V8引擎较重) | 天然优势(无需跨语言解释JS) | 一般(Nashorn/GraalVM较重) |
| 下游数据处理衔接 | 完美(Pandas/AI无缝承接) | 一般(需转交其他语言清洗) | 一般(需入库后清洗) | 良好(大数据Hadoop/Spark体系) |
采集架构与语言选型决策指南
选择采集语言时,不应脱离具体的业务场景与团队背景。以下决策图总结了技术选型的清晰路径:
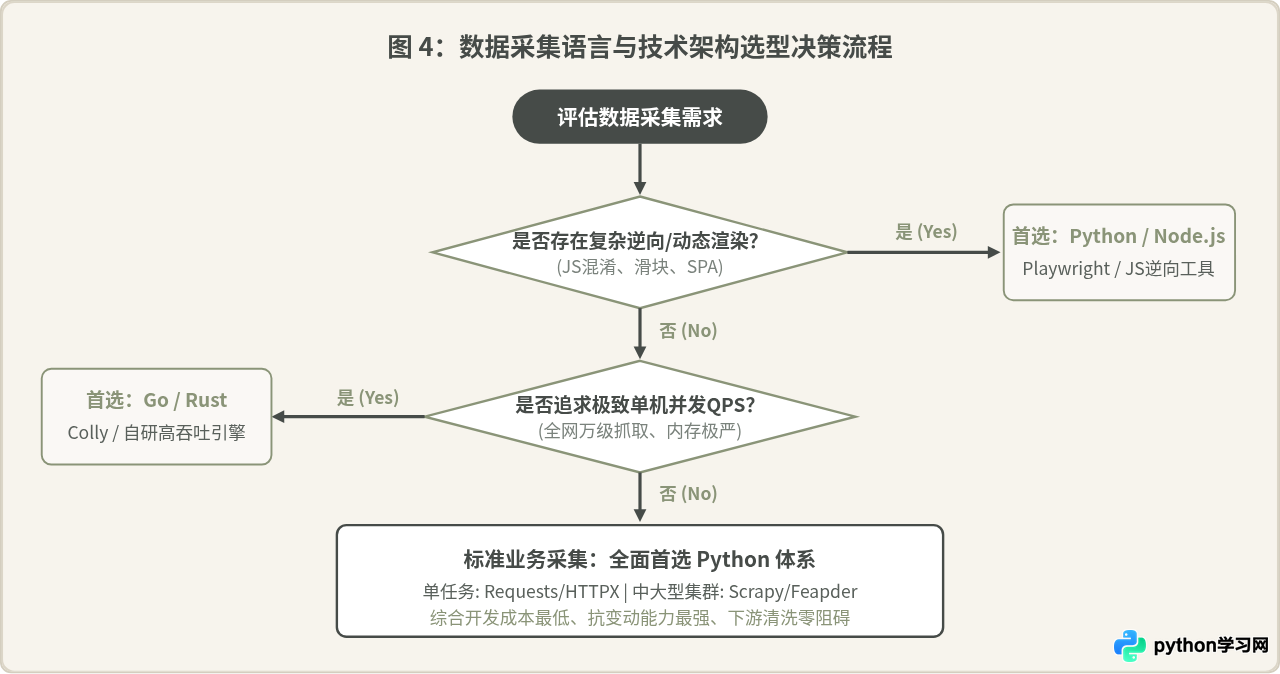
基于上述决策逻辑,合理的工程实践建议如下:
- 常规业务数据采集:首选Python。无论数据规模是几万页还是几千万页,通过Scrapy或异步架构均能平稳支撑,同时节约大量逆向与调试人月。
- 重度动态渲染与纯JS逆向:优先Python(Playwright/Selenium)或Node.js(Puppeteer)。在需要直接对浏览器上下文注入脚本时,Node.js与Python的表现最为出彩。
- 超高并发底层页面抓取:若目标接口无复杂风控,且需要单机榨干万兆网卡带宽,推荐Go语言编写核心下载器,再将原始网页交付给Python下游集群解析清洗。
总结与合规实践
Python成为数据采集领域无可置疑的首选语言,根本原因在于它精准切中了爬虫开发的核心矛盾——开发迭代效率与工程适应性远比纯计算性能重要。借助完善的分层工具链、灵活的动态调试能力以及与数据科学体系的无缝闭环,Python构建了极高的行业壁垒。
在实际落地采集任务时,除了合理进行技术选型,还需严守工程道德与合规底线:遵守目标站点的robots.txt协议,合理设置请求间隔与并发阈值以避免对其服务器造成拒绝服务(DoS),并在采集涉及个人信息或知识产权数据时严格遵照相关法律规范。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















