


Polars的流式执行怎么处理超内存的大数据集?
详细解析Polars流式执行(Streaming Execution)处理超内存大数据的核心原理与实操方法。包含从LazyFrame惰性扫描、分块流水线计算,到sink流式直接落盘的完整步骤、算子支持边界与避免OOM的最佳实践。
一、为什么常规加载会爆内存,而流式不会?
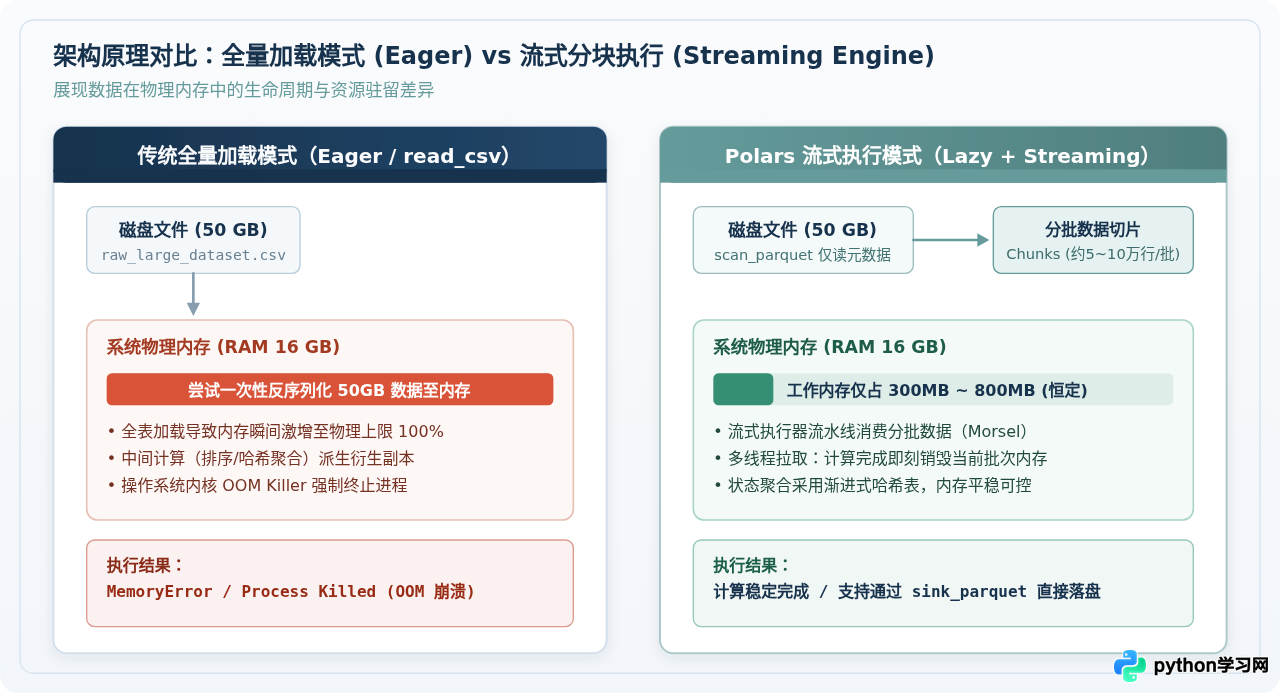
在默认的即时执行模式(Eager Mode,例如调用 pl.read_csv() 或 pl.read_parquet())下,系统会将整份文件完整解析并反序列化为底层的 Apache Arrow 内存块。如果文件本身有 50GB,而计算机只有 16GB 物理内存,操作系统在反序列化中途就会耗尽可用内存,并直接触发 OOM Killer(内存溢出终止)中断进程。即便物理内存足够容纳原始文件,后续的 filter、sort 或 group_by 计算往往需要开辟临时的衍生副本与哈希表,瞬时内存占用通常会膨胀至原始数据的 2 到 4 倍。
流式执行(Streaming Execution)改变了底层的数据流向。Polars 引擎将数据看作一条“源源不断的传送带”,其核心运作逻辑体现为三个方面:
- 微批次推进(Morsel-based Execution):流式引擎以 Chunk 为基本单位(默认通常为 50,000 至 100,000 行)逐段向后传递,各计算节点处理完一批数据后立即丢弃临时对象,驻留内存与整个数据集的总行数完全脱钩。
- 算子下推与就地剪裁:在分块从磁盘读取的瞬间,谓词下推(Predicate Pushdown)与投影下推(Projection Pushdown)就已经生效,不需要的列根本不会被读取进缓冲区,不符合过滤条件的行在数据进入核心内存前就被剔除。
- 流式哈希聚合与外部排序:聚合计算不需要持有明细行,只在流式哈希表中增量更新键对应的值;排序操作则支持分块排好后溢写磁盘(Spilling),再通过多路归并完成全局有序化。
二、开启流式处理的标准四步法
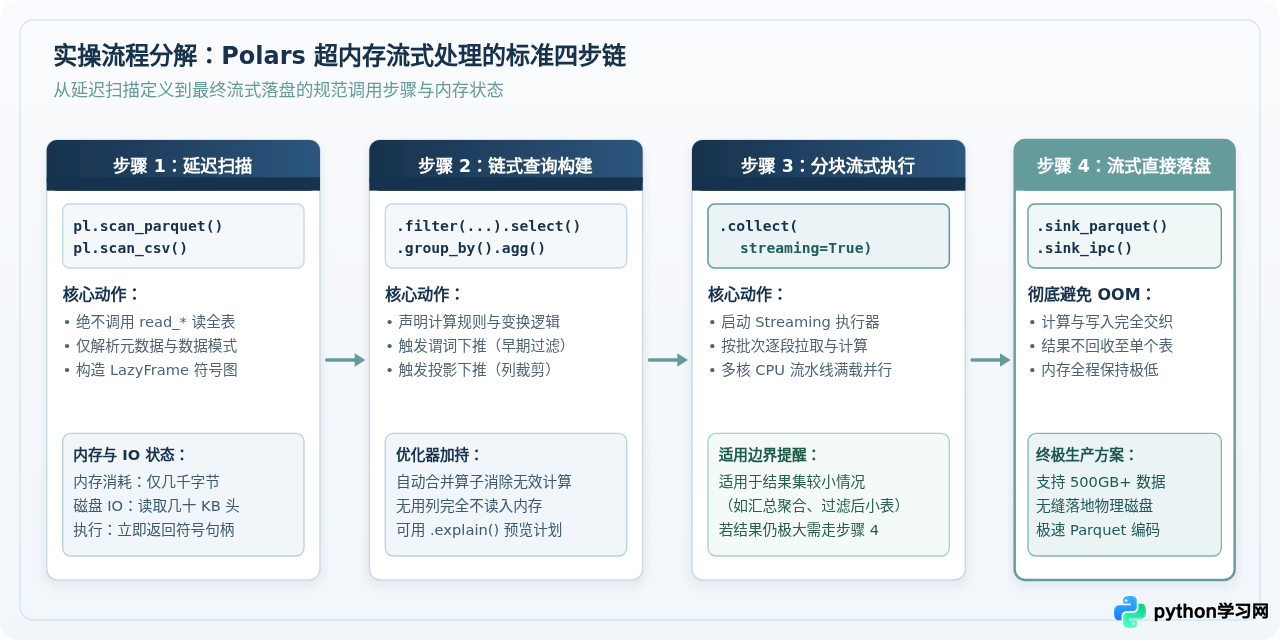
在实际编写代码时,将一个原本会爆内存的数据处理任务改造为流式执行,只需要遵循标准的四步范式。
步骤一:使用扫描函数构建惰性图
必须使用以 scan_ 开头的函数创建 LazyFrame,例如 pl.scan_parquet()、pl.scan_csv() 或 pl.scan_ndjson()。扫描函数只读取文件头部与元数据,并推断 Schema,不会把数据实体载入内存。
import polars as pl

# 仅扫描文件结构,返回 LazyFrame 符号句柄,内存消耗几乎为零
lazy_df = pl.scan_parquet("transactions_100gb.parquet")
步骤二:声明链式变换与表达式
在 LazyFrame 上链式调用各种转换逻辑。请尽量先写过滤条件与列裁剪,Polars 优化器会重新组织逻辑执行图,确保流式引擎启动时接收到最精简的数据流。
query = (
    lazy_df
    .filter(pl.col("status") == "COMPLETED")
    .select(["user_id", "amount", "category"])
    .group_by(["category"])
    .agg([
        pl.col("amount").sum().alias("total_amount"),
        pl.col("amount").count().alias("tx_count")
    ])
)
步骤三:使用 collect(streaming=True) 分块计算
如果计算的最终目标是获取汇总后的聚合结果(例如各分类的统计数据,只有几十行),可以直接在末尾调用 .collect(streaming=True)。Polars 会启动多线程流水线,分批拉取计算并最终组合出汇总表。
# 触发流式分批计算,收集聚合结果
result_df = query.collect(streaming=True)
print(result_df)
┌──────────────┬──────────────┬──────────┐
│ category │ total_amount │ tx_count │
│ --- │ --- │ --- │
│ str │ f64 │ u32 │
├──────────────┼──────────────┼──────────┤
│ Electronics │ 1.8492e8 │ 482019 │
│ Clothing │ 9.2104e7 │ 1294820 │
│ Books │ 3.4190e7 │ 890412 │
│ HomeGoods │ 6.1829e7 │ 670123 │
│ Groceries │ 4.9012e7 │ 2194890 │
└──────────────┴──────────────┴──────────┘
三、避免“终点爆内存”:使用 sink_parquet 流式落盘
许多初学者在掌握 collect(streaming=True) 后,依然会遭遇 OOM。这是因为他们忽略了结果集的最终体积。
collect() 无论是否开启流式,其函数语义都是“在物理内存中拼装出完整的单个 DataFrame”。如果输入是 100GB,经过过滤和计算后,结果依然有 30GB,即便流式引擎在整个计算过程中将内存压得很低,在最后一瞬间拼接 30GB DataFrame 时依然会挤爆 RAM。
要实现真正彻底的“Out-of-Core 端到端纯流式计算”,必须使用 sink_* 系列方法(如 sink_parquet()、sink_ipc() 或 sink_csv())。
sink_parquet() 的工作方式是:计算引擎每算完一个微批次,就将结果编码成 Parquet 的一个 Row Group 直接写入物理磁盘文件,随后将批次从内存中彻底释放。整个任务从开始到完成,内存曲线像一条平稳的直线,几乎不受输入与输出规模的影响。
# 完整端到端超内存清洗并直接落盘
lazy_clean = (
    pl.scan_parquet("raw_massive_logs_*.parquet")
    .filter(pl.col("response_code") == 200)
    .with_columns([
        pl.col("timestamp").str.to_datetime().alias("datetime"),
        (pl.col("latency_ms") / 1000.0).alias("latency_sec")
    ])
    .select(["datetime", "user_id", "latency_sec", "path"])
)

# 流式直接落地到磁盘目标文件,全程常驻内存维持在 300MB 以内
lazy_clean.sink_parquet(
    "processed_clean_logs.parquet",
    compression="zstd",
    maintain_order=False  # 允许无序写入以换取最大多核并发性能
)
四、算子流式兼容性与回退机制
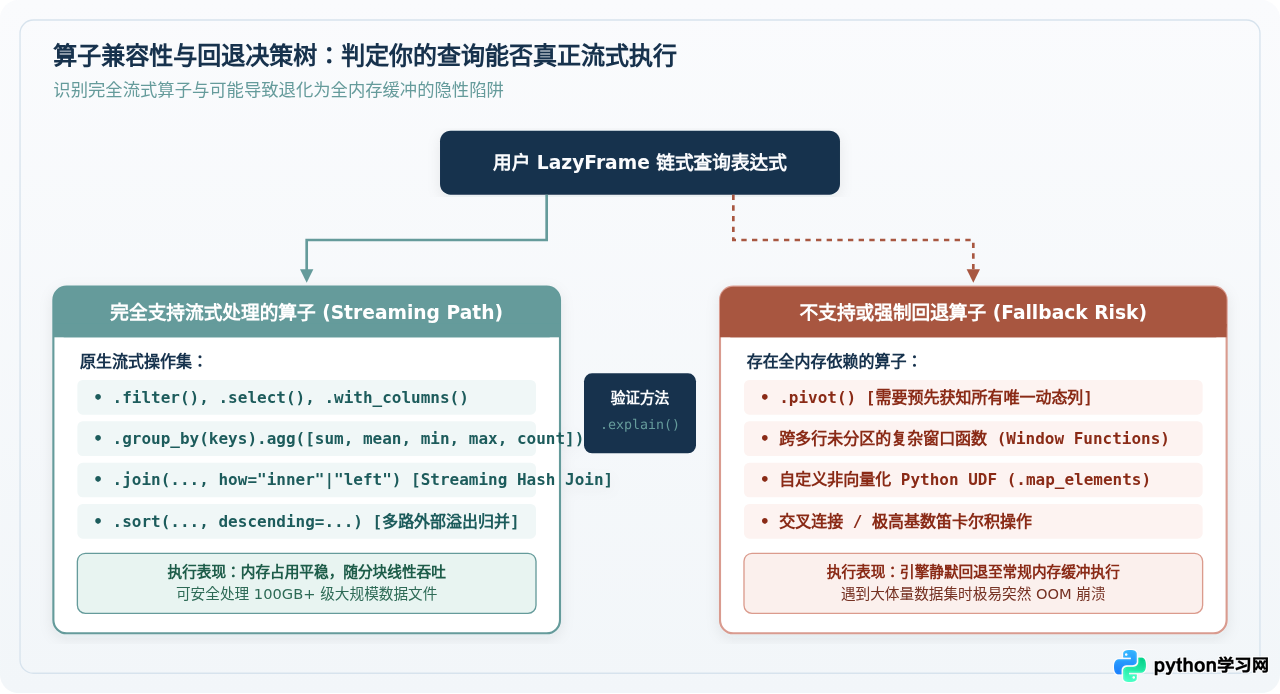
Polars 的流式引擎是一个专门的子执行器,但并非所有数据分析算子在数学或逻辑上都能单向分块流式完成。
当查询计划中包含了流式引擎尚未支持的算子,或者依赖全局全量上下文的算子时,Polars 会发生回退(Fallback)。回退意味着引擎会将该节点及其上游的所有数据全部物化到内存中,重新以非流式模式计算。如果在处理百 G 级数据时发生回退,内存就会瞬间飙升导致崩溃。
| 算子类型 | 代表操作 | 流式支持状态与行为说明 |
|---|---|---|
| 单行映射与筛选 | filter, select, with_columns, 算术运算 |
原生完全流式:各批次完全独立,内存占用最小,几乎线性扩展。 |
| 流式聚合 | group_by().agg()(sum, count, min, max, mean) |
原生支持:使用增量哈希表累加状态;注意如果分组键基数极大(数亿唯一值),哈希表本身仍会占用可观内存。 |
| 关联连接 | join(..., how="inner"|"left") |
流式哈希连接:将较小的右表构建为哈希表(需能放入内存),左侧超大表分批流式探测(Probe)。 |
| 排序 | sort() |
支持流式外部溢写:通过多路归并排序(External Spill-to-Disk)处理,磁盘 IO 增加但内存平稳。 |
| 透视与重塑 | pivot() |
不支持流式(必回退):透视需要预先全量扫描出所有唯一动态列头,必须持有全局数据。 |
| 自定义函数 | map_elements() (Python UDF) |
限制/退化:Python GIL 锁会导致多线程流式流水线停顿,无法发挥 Rust 原生流水线性能。 |
如何验证查询是否真正处于流式模式?
在正式执行大规模任务前,可以使用 explain() 方法检查优化后的执行计划:
# 打印执行计划树,检查是否有 STREAMING 节点
print(lazy_clean.explain(streaming=True))
PARQUET SINK: processed_clean_logs.parquet
SELECT [datetime, user_id, latency_sec, path]
FAST_PROJECT: [response_code, timestamp, user_id, latency_ms, path]
FILTER: [(col("response_code")) == (200)]
PARQUET SCAN: raw_massive_logs_*.parquet
PROJECT 5/18 COLUMNS
如果在输出的顶部看到了 --- STREAMING ---,说明整条流水线成功被流式引擎接管,没有发生非预期的全内存回退。
五、超大任务的调优技巧与避坑清单
面对资源受限环境(例如容器仅分配了 2GB 或 4GB 内存),可以通过调整环境参数与优化表达方式进一步压实内存基线:
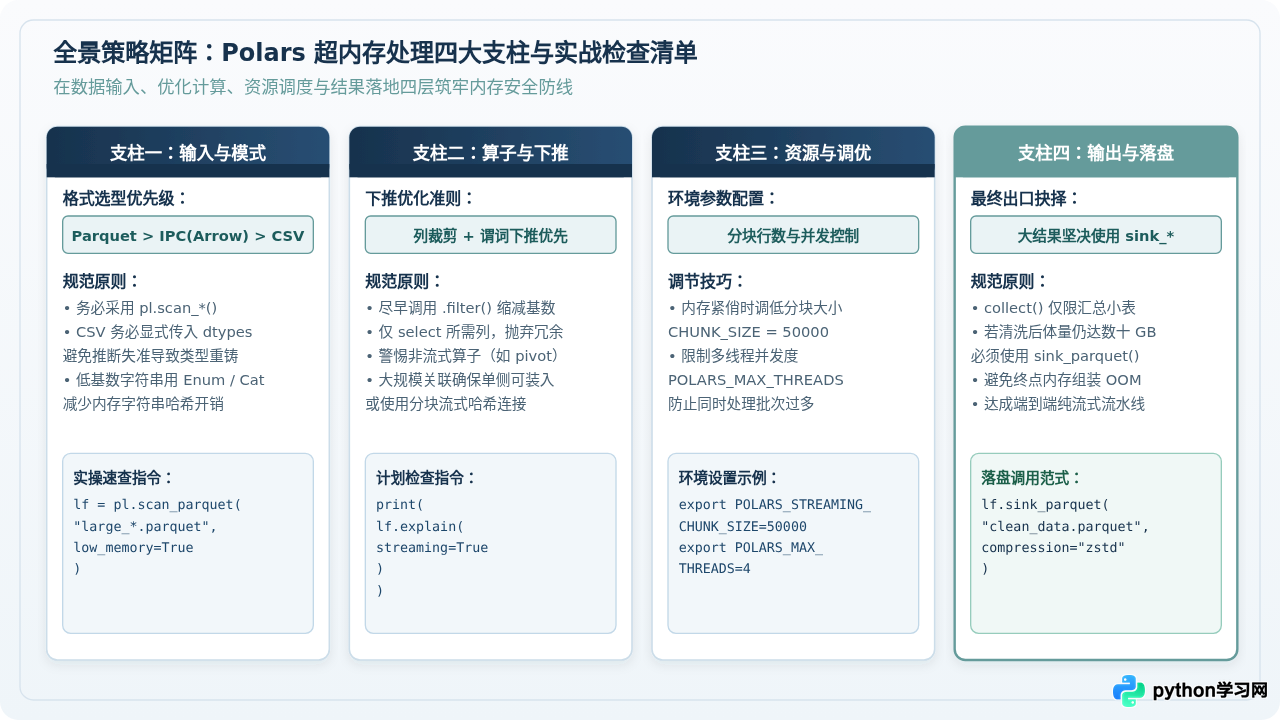
1. 控制批次行数(Chunk Size):默认情况下 Polars 会根据核心数自适应分块。通过设置环境变量 POLARS_STREAMING_CHUNK_SIZE=50000,可以强制缩小每个批次的行数,从而直接压减单个批次的内存体积。
2. 限制工作线程数(Concurrency):通过设置 POLARS_MAX_THREADS=4,可以减少同时处于流水线中的活动批次数量。核心数越多,并发处理的批次越多,瞬时内存占用也就越高;适度限制线程数是用轻微的速度换取极高的内存稳定性。
- 使用 Enum 或 Categorical 代替原生 String:如果数据集中包含大量重复的文本标签(如国家代码、订单状态、设备型号),在扫描时将其指定为
pl.Enum或pl.Categorical。这能将巨大的字符串内存分配转变为紧凑的整数编码,降低哈希聚合表的内存占用 70% 以上。 - 优先选用 Parquet 或 Arrow IPC 格式:CSV 文件由于缺乏列式元数据和行组索引,解析时需要大量的字符转换开销。Parquet 原生自带 Row Group 分块结构与列投影支持,是流式计算最理想的底层存储。
- 警惕高基数 Group By 聚合:虽然聚合算子本身支持流式,但如果聚合键是唯一的 UUID 或用户身份证号(1 亿行产生 1 亿个 Key),哈希表本身就需要容纳 1 亿个条目,内存依然会耗尽。高基数场景应先进行范围切分或采用分层汇总。
六、端到端完整生产代码模板
以下为工业级批量处理大体量数据的标准化脚本模板,涵盖了环境设置、模式优化、流式过滤、列剪裁与流式落地全过程:
import os
import polars as pl

# 1. 设置流式环境配额(根据机器硬件灵活配置)
os.environ["POLARS_STREAMING_CHUNK_SIZE"] = "65536"  # 约 6.5 万行/批
os.environ["POLARS_MAX_THREADS"] = "4"             # 限制并发管线

def run_out_of_core_pipeline(input_glob: str, output_path: str):
    # 2. 惰性扫描数据源(投影推断)
    q = pl.scan_parquet(
        input_glob,
        low_memory=True,
        cache=False  # 超大数据集关闭中间缓存,避免内存驻留
    )

    # 3. 构造流水线转换逻辑
    pipeline = (
        q
        .filter(pl.col("is_valid") == True)
        .select([
            pl.col("event_time"),
            pl.col("device_id").cast(pl.Categorical),
            pl.col("duration_ms").fill_null(0)
        ])
        .with_columns([
            (pl.col("duration_ms") / 1000.0).alias("duration_sec")
        ])
    )

    # 4. 验证计划是否为流式
    plan_str = pipeline.explain(streaming=True)
    if "--- STREAMING ---" not in plan_str:
        print("[警告] 该查询未能完全进入流式管线,请检查算子兼容性!")

    # 5. 流式直接落盘至 Parquet 存储
    print("开始执行流式落盘任务...")
    pipeline.sink_parquet(
        output_path,
        compression="zstd",
        compression_level=3,
        maintain_order=False
    )
    print("数据流式处理完成!输出文件已写入:", output_path)

if __name__ == "__main__":
    # 示例调用(路径按需替换)
    # run_out_of_core_pipeline("data/telemetry_*.parquet", "output/telemetry_clean.parquet")
    pass
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















