


NumPy loadtxt和genfromtxt读取CSV有什么区别
深入对比 NumPy 中 loadtxt 与 genfromtxt 两个 CSV 及文本数据读取函数的核心机制、性能差异、缺失值容错能力与适用场景,提供详尽代码示例与选型指南。
在数据分析与科学计算开发中,读取以逗号、制表符或空格分隔的文本表格是一项高频基础任务。假设你刚刚导出一份传感器记录或实验日志,正准备使用 Python 进行矩阵计算,发现终端中抛出了一长串 ValueError: could not convert string to float 错误——这通常是因为文件中混杂了空行、缺失数据或字符串标签,而你选择的加载函数未能兼容此类不规则格式。在 NumPy 库中,numpy.loadtxt 和 numpy.genfromtxt 是专门用来读取文本数据文件的两个核心函数。从结论上看,loadtxt 是轻量、快速、面向规整纯净数据的低延迟解析工具;而 genfromtxt 则是面向非规则表格、具备两遍扫描与缺失值补齐容错能力的重型加载器。理解二者在运行机制、容错机制和数据类型处理上的区别,能够帮助我们在性能与稳健性之间做出精准权衡。
一、核心机制:单遍快速读取与两遍容错解析
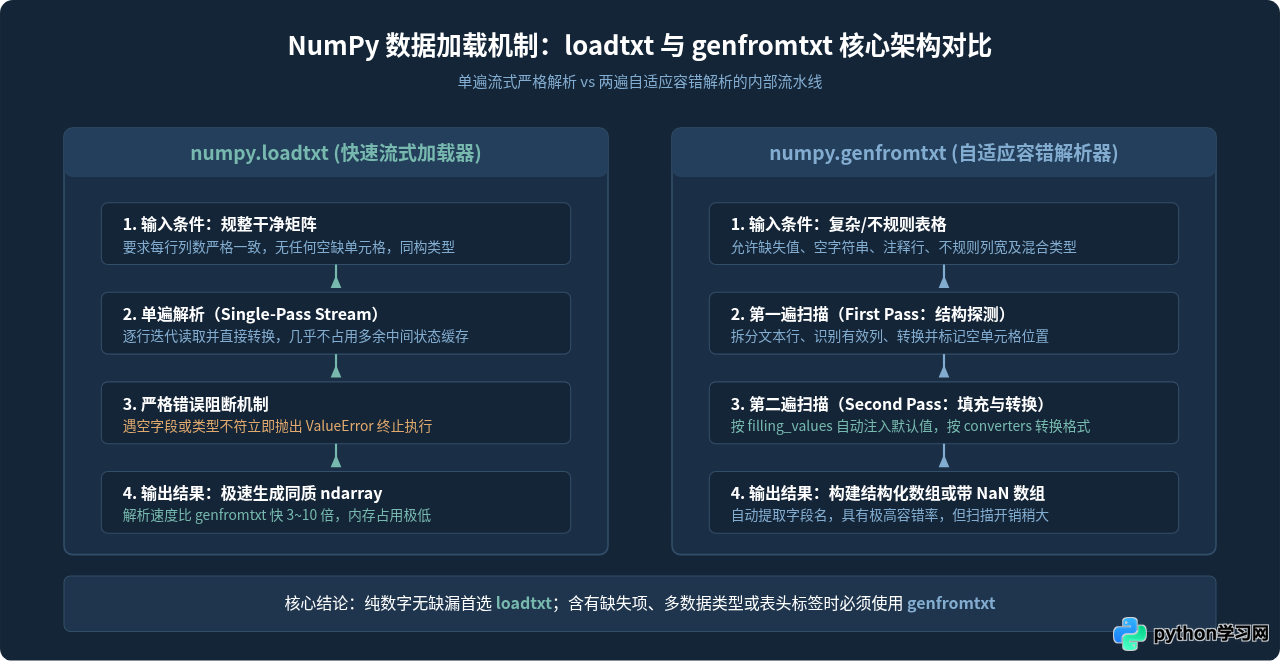
为了直观展现两者在底层的差异,我们需要从文件遍历方式入手。numpy.loadtxt 采用单遍(Single-Pass)流式解析。它从首行开始(可以通过 skiprows 跳过指定行),逐行按分隔符切割字符串,并将切片直接输入到底层 C 语言转换函数中。由于不存储冗余的中间字符串结构,也没有回溯流程,其执行速度非常快,内存利用效率极高。但这种机制的代价是零容错:如果在第 1000 行的某个字段上出现了缺失(即连续两个分隔符 ,,),底层转换函数无法将空字符转换为数值,整个解析流程立即中断。
相比之下,numpy.genfromtxt(名字来源即“generate from text”)设计初衷就是为了应对现实世界中残缺不全的数据集。它在 Python 层面实现了两阶段解析:
- 第一遍(First Pass):逐行读取原始文件,将文本拆解为一系列独立的字符串列表。在此阶段,它会识别注释、空行,并统计每行的字段数;如果某个字段为空,它会将其标记为“缺失项”占位符,而不是直接报错。
- 第二遍(Second Pass):根据用户指定的
dtype、converters(列转换器)以及filling_values(填充值),依次对各个字段进行类型转换。对于上一阶段标记出的缺失项,系统会自动使用预设规则进行安全补齐。
二、面对缺失值:抛出异常还是安全填充
缺失值(Missing Values)是区分二者最直观的分水岭。在日常处理由 Excel 导出的 CSV 文件时,未填写的单元格常表现为空白。我们通过一段具体的示例代码来观察两个函数的真实表现。
假设在项目根目录下存在一个名为 sensor_data.csv 的数据文件,其内容如下:
# 设备采集日志: 时间戳, 测量值A, 测量值B, 状态码
101, 12.5, 33.1, 0
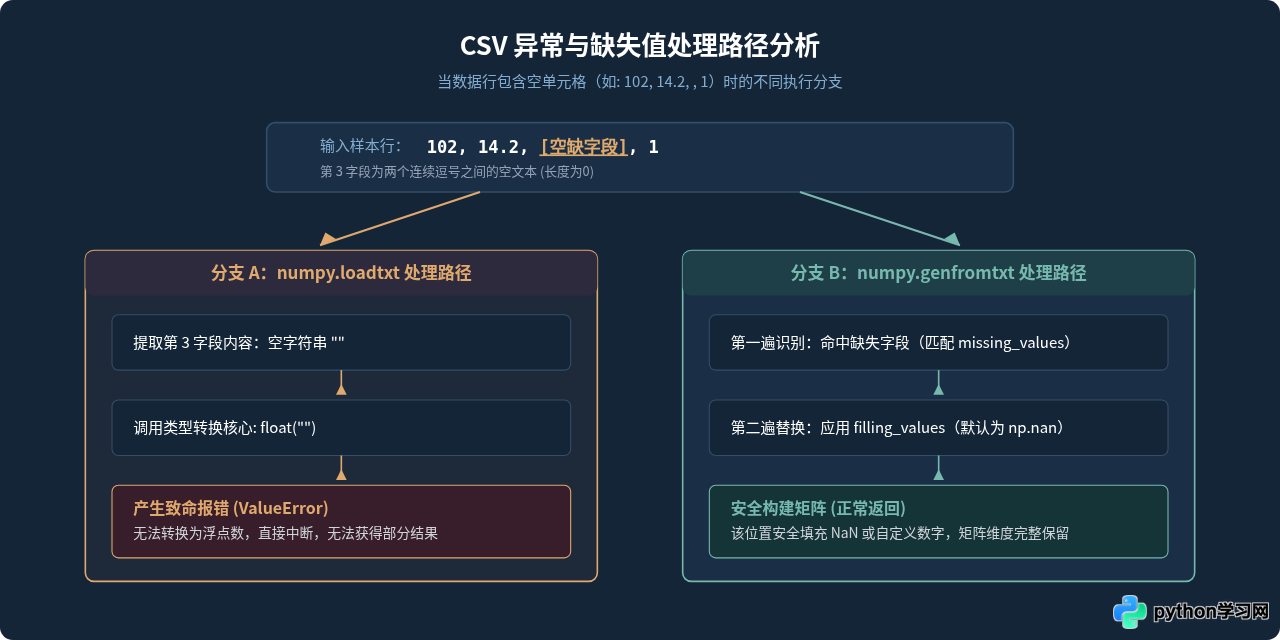
102, 14.2, , 1
103, 11.8, 29.4, 0
注意第二行数据的第 3 列(测量值B)处于留空状态。我们分别使用 loadtxt 与 genfromtxt 进行读取:
import numpy as np

# 尝试使用 loadtxt 读取
try:
    data_lt = np.loadtxt('sensor_data.csv', delimiter=',', comments='#')
except ValueError as e:
    print(f"loadtxt 抛出异常: {e}")

# 使用 genfromtxt 读取
data_gen = np.genfromtxt('sensor_data.csv', delimiter=',', comments='#')
print("genfromtxt 读取结果:")
print(data_gen)
运行结果分析:
# 控制台输出示例:
loadtxt 抛出异常: could not convert string to float: ''

genfromtxt 读取结果:
[[101.   12.5  33.1   0. ]
 [102.   14.2   nan   1. ]
[103. 11.8 29.4 0. ]]如运行输出所示,loadtxt 面对第 2 行的空字段直接报错终止;而 genfromtxt 能够智能地将空缺的测量值B替换为 np.nan(Not a Number),保证了整张二维矩阵的结构完整性,程序不会中断崩溃。
进阶提醒: 在 genfromtxt 中,你可以通过 filling_values 参数自定义填充规则。例如,设置 filling_values=-999.0,即可将所有空单元格统一替换为业务约定的无效标识码,避免在后续计算中产生 NaN 污染传播。
三、参数与数据结构:纯矩阵 vs 结构化数组
除了缺失值外,现实中的 CSV 文件通常还包含不同类型的列(如整型 ID、字符串名称、浮点型数值)以及首行表头列名。两在组织返回数据类型(dtype)以及结构化支持上有显著不同。
1. 自动表头解析与结构化数组
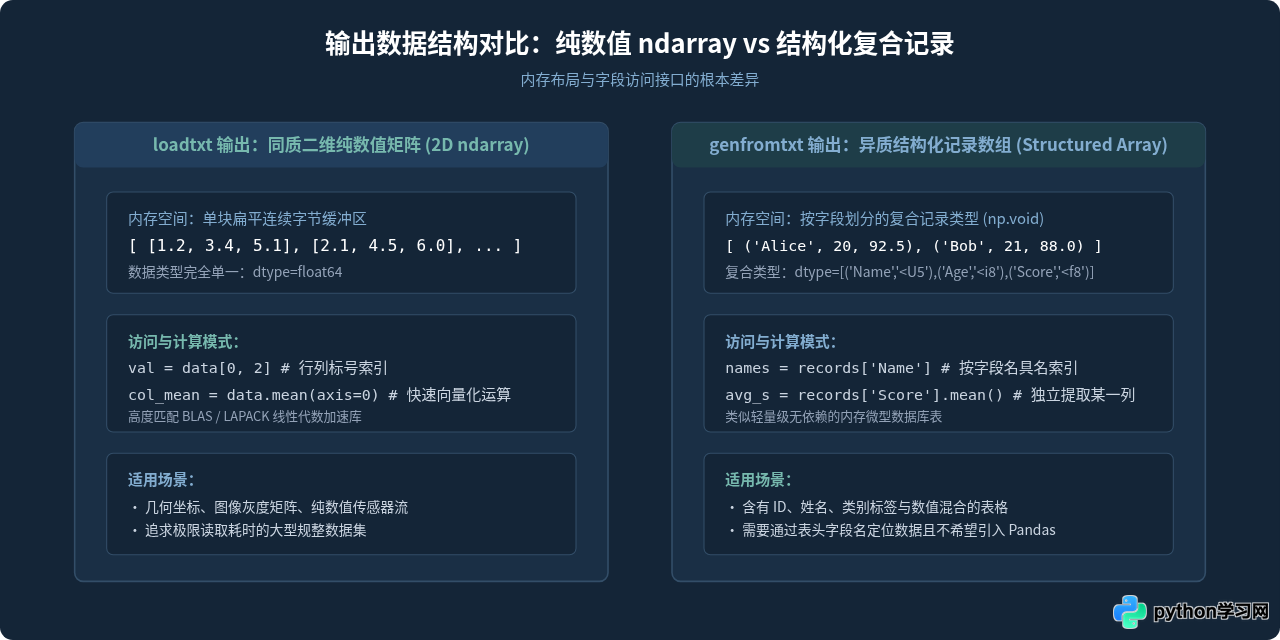
genfromtxt 支持通过设置 names=True 自动将文件的第一行识别为列名,同时设置 dtype=None, encoding='utf-8' 开启各列类型自动推断。此时返回的不再是普通二维数组,而是 NumPy 的结构化数组(Structured Array),可以通过字段名直接索引数据列,如同一个轻量级的 DataFrame。
# 示例:读取包含表头与混合数据类型的 CSV 文件
# 假设 student_scores.csv 内容为:
# Name, Age, Score
# Alice, 20, 92.5
# Bob, 21, 88.0

import numpy as np

# 使用 genfromtxt 一键读取并构建结构化对象
records = np.genfromtxt(
    'student_scores.csv',
    delimiter=',',
    names=True,          # 首行作为列名
    dtype=None,          # 自动推断各列数据类型
    encoding='utf-8'     # 避免字符串被解析为 bytes
)

print("结构化字段定义:", records.dtype)
print("提取所有姓名:", records['Name'])
print("提取所有分数:", records['Score'])
而对于 loadtxt 来说,默认情况下 dtype=float,它期望所有单元格都是浮点数。如果你要在 loadtxt 中读取字符串或混合类型,必须手动预先编写好完整的复合类型元组列表(例如 dtype=[('Name', 'U10'), ('Age', 'i4'), ('Score', 'f8')]),并且还需要手动配置 skiprows=1 避开表头。这极大增加了使用成本。
2. 关键参数横向对比
为了在编写代码时快速查阅,下表列出了两个函数在关键参数支持度上的对照:
| 功能特性 / 参数 | numpy.loadtxt | numpy.genfromtxt | 说明与区别 |
|---|---|---|---|
缺失值处理 (missing_values / filling_values) |
不支持 | 支持 | genfromtxt 可自定义何种字符视为空缺,并指定填充替代值 |
自动提取表头 (names=True) |
仅在预设复合 dtype 时有效 | 完整支持 | genfromtxt 能自动抓取第一行有效文本并清洗为字段名 |
类型自动推断 (dtype=None) |
不支持(默认 float) | 支持 | genfromtxt 会分析各列字符特征自动推导最佳数据类型 |
列自定义转换器 (converters) |
支持 | 支持 | 两者均可通过字典 {列号: 转换函数} 对特定列进行过滤或清洗 |
列选择过滤 (usecols) |
支持 | 支持 | 均可通过元组或列表指定仅加载特定索引列,降低内存占用 |
两端空白去除 (autostrip) |
不支持 | 支持 | genfromtxt 可设置 autostrip=True 自动剥离变量周围的空格 |
| 运行效率 | 高(快 3~10 倍) | 较低 | loadtxt 采用精简循环;genfromtxt 有两遍解析开销 |
四、性能与运行开销:为什么 loadtxt 明显更快
很多开发者会有疑问:既然 genfromtxt 功能如此完备,为什么 NumPy 官方没有直接废弃 loadtxt 呢?答案在于执行性能。
genfromtxt 为了实现“两遍解析”、缺失值捕获、字符串编码转换和类型推断,其底层大量使用了 Python 层面的包装逻辑和动态检查。在处理包含数十万行乃至数百万行的数据文件时,两者的耗时差距非常显著:
- 在 100 万行、5 列的规整浮点数 CSV 基准测试中,
np.loadtxt通常可以在 1~2 秒内完成加载并返回连续内存数组。 - 在相同数据量下,
np.genfromtxt往往需要花费 8~15 秒,并且在两遍扫描的中间阶段会产生较高的临时内存占用。
注意边界: 如果你的文件规模达到数百万行以上,且需要高性能解析混合型 CSV,NumPy 内置的这两个函数实际上都不是最优解。此时更建议使用经过深度 C/Rust 引擎优化的 pandas.read_csv 或 polars.read_csv,它们在速度和容错性上都有明显优势。
五、选型指南与决策路径
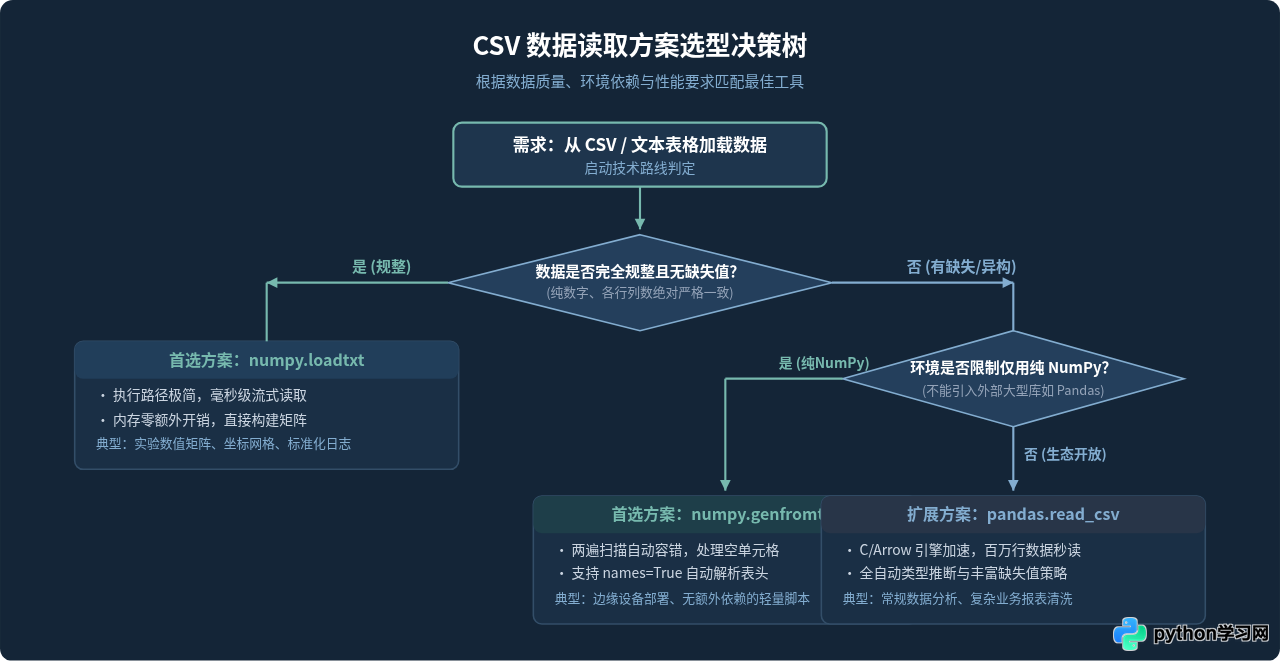
在实际工程开发中,选择哪个函数并不取决于功能有多复杂,而是取决于输入数据的质量以及性能指标要求。可以遵循以下决策树进行选择:
总结
numpy.loadtxt 和 numpy.genfromtxt 各具特色,并不是简单的替代关系:
- 如果你明确知道数据是规整纯粹的数字(例如算法导出的矩阵、传感器等长采集序列),毫不犹豫选择
loadtxt,它简单、紧凑且运行极快。 - 如果数据包含缺失值、注释行、空单元格或表头标签,且项目需要保持轻量纯净、无需引入额外重量级依赖库,选择
genfromtxt可以利用其自适应机制免去繁琐的前置清洗工作。
掌握这两个函数的设计边界与底层机制,能够让你在处理 Python 科学计算中的数据加载环节时更加游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















