


Python截取数据报错IndexError:索引越界原因与解决
详细解析Python在截取或索引列表、元组、字符串等序列数据时抛出IndexError: list index out of range的原因,区分单元素下标与切片截取的机制差异,提供四大典型场景排查与五种安全解决方案。
在 Python 中使用单下标或切片截取列表、元组、字符串等序列数据时,IndexError: list index out of range 是最常见的运行时错误之一。该报错的直接原因是代码尝试访问超出序列当前有效索引边界的位置。解决这一问题的核心在于理清单元素下标访问与切片截取的机制差异,针对循环、空数据、动态修改等常见陷阱实施边界守卫、安全截取或异常兜底方案。
一、IndexError 报错核心机理与操作概念辨析
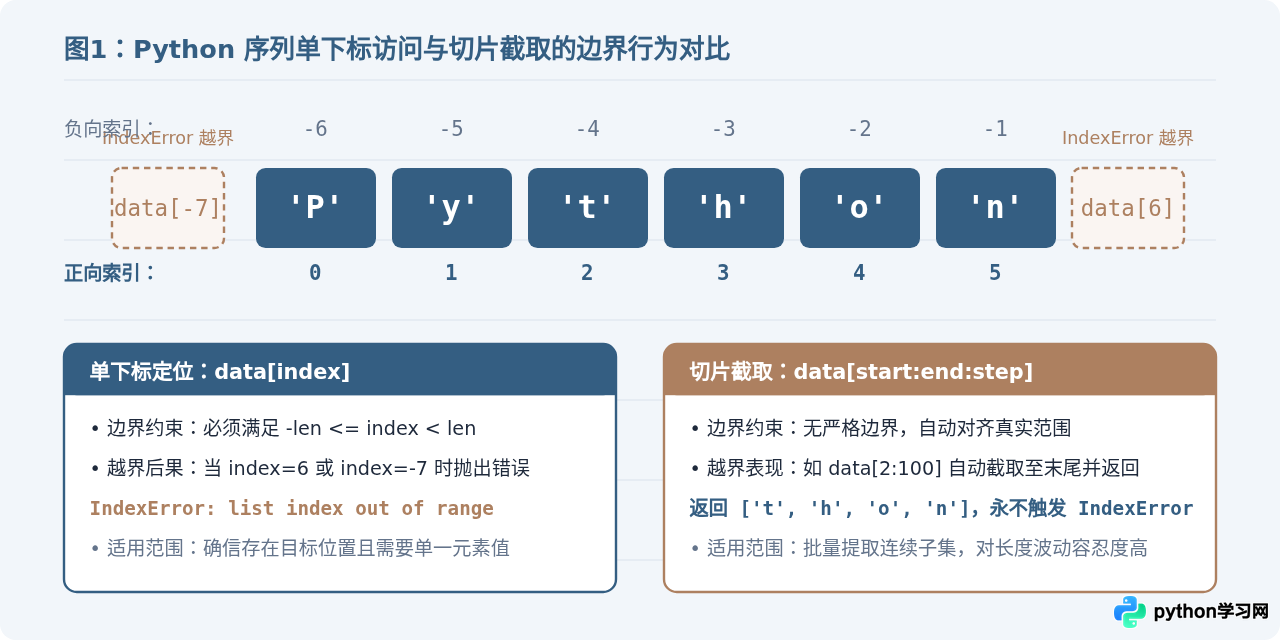
在排查报错前,需要明确 Python 中“截取”这一操作的底层概念分工。许多开发者将单下标取值(Indexing)与切片提取子序列(Slicing)统称为截取,但解释器对这两者的越界处理规则截然不同:
- 单元素下标访问(Indexing,如
data[i]):属于严格寻址操作。Python 序列支持从0到len(data) - 1的正向索引,以及从-len(data)到-1的负向倒序索引。当给定的下标i >= len(data)或i < -len(data)时,底层指针无法映射到有效内存槽位,解释器立即抛出IndexError并中断当前流程。 - 切片截取操作(Slicing,如
data[start:end]):属于容错范围提取操作。Python 切片协议在处理越界边界时,会自动将超出实际长度的起点或终点截断至有效范围边缘,返回包含有效元素的子序列;若整个切片区间均在数据之外,则安全返回对应类型的空序列(如[]或""),绝对不会引发IndexError。
二、导致 IndexError 的四大高频代码场景与根因分析
在实际编码中,引发 IndexError 的情形通常并不复杂,但往往隐藏在循环条件、动态状态变更或不确定的数据加载环节中。以下是四种最常见的场景:
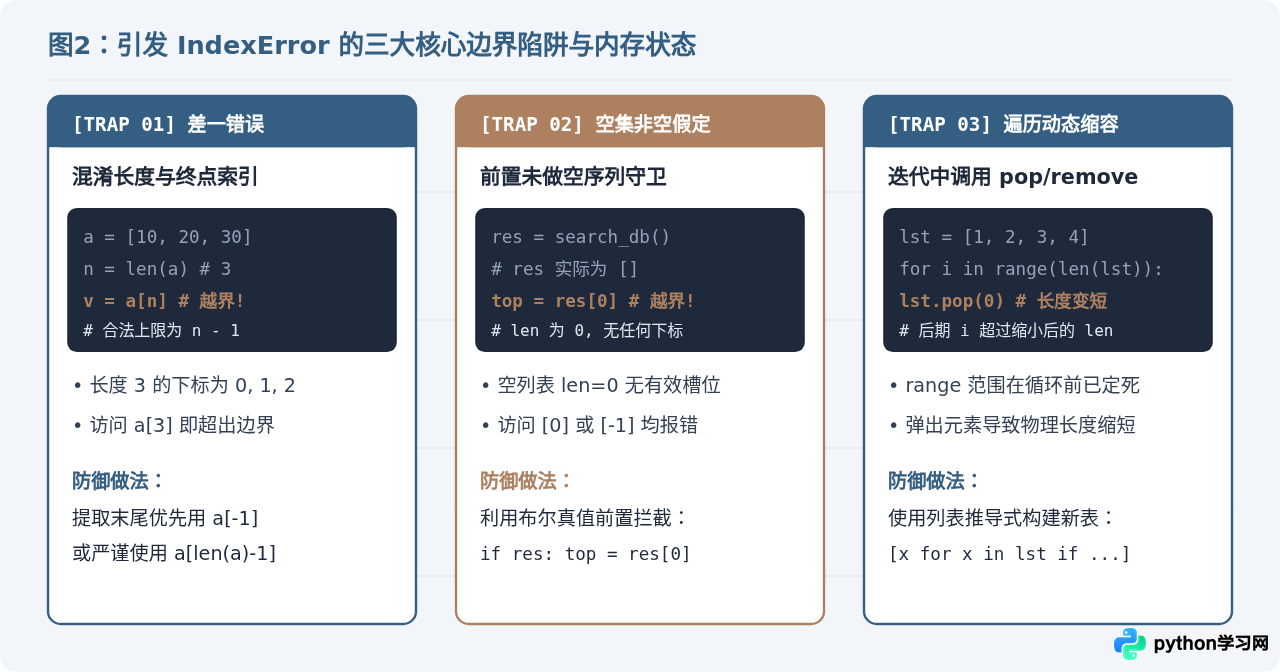
1. 差一错误(Off-by-one):混淆序列长度与末尾索引
初学者容易将序列的实际元素数量(len(seq))直接当作末尾元素的索引下标。由于 Python 索引以 0 为起点,长度为 N 的序列,其最后一个元素的合法下标是 N - 1,直接使用 len(seq) 必然导致越界。
# 错误示例
items = ["apple", "banana", "orange"]
size = len(items)       # size 等于 3
last_item = items[size]  # 触发 IndexError: list index out of range
2. 空序列假定非空:前置过滤或查询返回空集
当程序从网络请求、数据库查询、文件读取或字符串拆分(split)中获取数据时,如果数据源未返回预期内容,变量将是一个空列表 []。空列表的长度为 0,此时不仅下标 0 无法访问,使用倒序索引 [-1] 同样会越界。
# 错误示例:文本拆分后假定必定存在拆分项
log_line = "INFO:"
parts = log_line.split(" ")
# 若 log_line 中没有空格,parts 为 ['INFO:'],此时 parts[1] 即报错
message = parts[1]      # 触发 IndexError: list index out of range
3. 在正向循环中动态删除或截断元素
在通过下标遍历列表时,如果循环体内部调用了 pop()、remove() 或 del,列表的实际物理长度会动态缩短。但 range(len(...)) 在循环初始化时已经固化了迭代范围,导致后续迭代轮次计算的下标超出缩容后的新列表长度。
4. 多维序列或嵌套列表的维度维度越界
处理类似 matrix[row][col] 的二维列表时,外层长度与内层子列表长度通常并不一致。如果内外层索引变量混用,或者某一行存在缺省值(如不规则表格),在访问内层特定列时就会引发越界。
三、故障排查四步法:快速定位错误行与变量状态
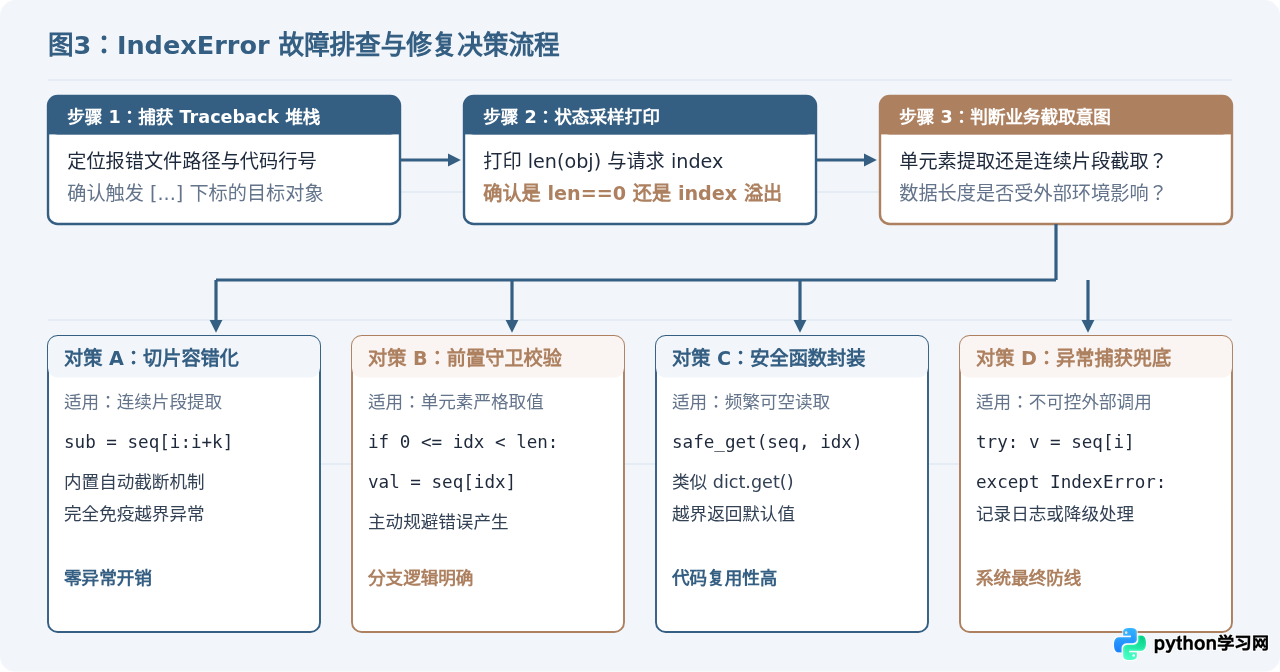
当遇到 IndexError 时,切忌盲目随意加减索引值。建议按照以下四步工程化流程快速定位根本原因:
- 查阅 Traceback 追溯最终发生点:定位报错信息最后一行指明的具体文件路径、行号以及涉及的代码语句。确认是在哪一个变量执行
[...]下标操作时抛错。 - 打印/断点捕获实时长度与请求下标:在报错代码行前插入打印或断点调试,输出当前对象的长度和请求索引:
通过打印即可明确:究竟是print(f"Debug: 序列类型={type(target_list)}, 实时长度={len(target_list)}, 目标下标={target_index}")target_list为空(长度为 0),还是target_index计算溢出。 - 溯源数据流产生阶段:如果数据序列长度异常偏小,回溯其上游数据流:检查文件读取是否提前结束、SQL 查询条件是否过严、正则表达式或
split()是否未能匹配到内容。 - 明确操作意图是“单项选取”还是“范围截取”:若业务意图是提取一段连续数据,应将下标访问立即重构成切片语法;若确实是获取单一位置元素,则进入防御式修复阶段。
四、根治与防御:五种安全截取与索引解决方案
方案 1:改用切片语法替代单索引(推荐用于截取场景)
当需要从序列中截取一段数据,或者提取可能不存在的头部/尾部元素时,优先使用切片。如果需要提取单个元素但希望享受切片的安全性,可以截取长度为 1 的子切片,配合条件表达式解包:
# 传统单索引:存在越界风险
# val = items[0]  # 若 items 为空则崩溃

# 安全切片方式:截取长度为 1 的切片,不抛错
sub_slice = items[:1]  # items 为空时返回 []
val = sub_slice[0] if sub_slice else None

# 安全范围截取:即便 end 远大于实际长度,也能安全获取所有可用元素
page_items = items[0:50]  # 即使只有 5 个元素,也安全返回这 5 个
方案 2:前置显式边界检查(Guard Clause)
对于算法中必须通过数字下标精确定位的场景,在访问前使用链式比较 0 <= index < len(data) 进行守卫拦截,确保不会越界:
def get_element_safely(data_list, target_index):
    # 同时验证非负下标与上边界
    if 0 <= target_index < len(data_list):
        return data_list[target_index]
    # 处理负向合法下标
    if -len(data_list) <= target_index < 0:
        return data_list[target_index]
    return None  # 越界时安全返回空值或业务默认值
方案 3:使用 try...except IndexError 捕获异常
符合 Pythonic 的“请求宽恕比许可更容易”(EAFP)原则。适用于绝大多数情况下下标合法、仅极少数异常输入可能越界的场景:
try:
    target_value = data_list[requested_index]
except IndexError:
    # 捕获后记录日志或赋予默认降级数值
    target_value = "DEFAULT_VALUE"
方案 4:封装通用的 safe_get 工具函数
Python 的字典提供了 dict.get(key, default) 方法,但列表原生没有提供类似的下标安全取值接口。可以在工程中自定义一个通用的安全获取辅助函数:
def safe_get(sequence, index, default=None):
    """
    通用序列安全取值函数:模拟字典 get() 行为
    """
    try:
        return sequence[index]
    except (IndexError, TypeError):
        return default

# 示例调用
user_ids = [101, 102, 103]
first_user = safe_get(user_ids, 0)       # 返回 101
tenth_user = safe_get(user_ids, 9, -1)   # 返回 -1(不报错)
方案 5:重构遍历模式,摆脱 range(len(...))
很多开发者习惯用下标控制循环,这恰恰是 IndexError 的高发地。在 Python 中,绝大多数遍历场景应优先使用迭代器或 enumerate:
# 不推荐:通过下标遍历,极易在维护中因修改列表而越界
for i in range(len(my_list)):
    print(my_list[i])

# 推荐:直接按元素迭代,天生免疫 IndexError
for item in my_list:
    print(item)

# 若同时需要序号与元素值,使用 enumerate()
for i, item in enumerate(my_list):
    print(f"索引 {i} 对应的值是 {item}")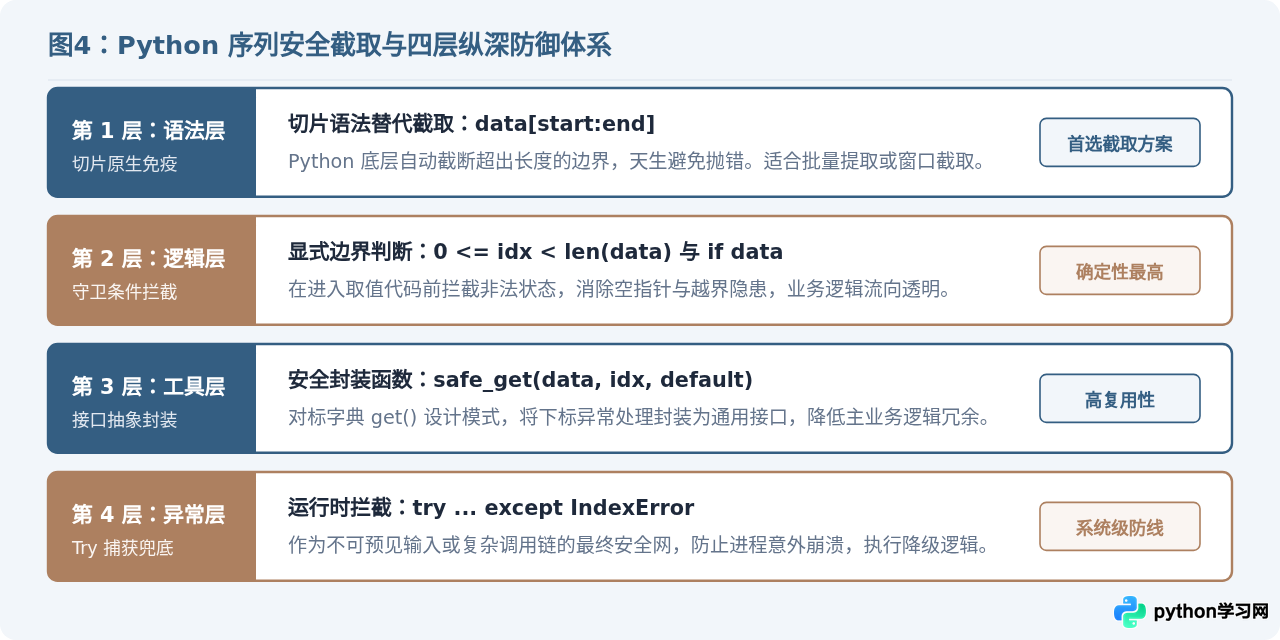
五、各解决方案选型对比与修复验证
为了在工程实践中权衡性能、可读性与安全性,可参考下表的方案选型依据:
| 处理方式 | 越界时表现 | 性能开销 | 适用典型场景 |
|---|---|---|---|
切片截取 [start:end] |
自动截断,返回空或可用子序列 | 极低(C 层面优化) | 提取连续数据段、截取前 N 项或滑动窗口 |
前置边界守卫 if 0 <= i < len |
走预设分支,不抛错 | 极低(单次条件判断) | 必须根据确切数值下标访问单一关键元素 |
try...except IndexError |
捕获异常并转入异常分支 | 正常时零开销,触发异常较慢 | 极少数情况下才可能越界的外部复杂接口调用 |
封装 safe_get(lst, idx) |
返回指定的默认值 | 微小(多一层 Python 函数栈调用) | 多处解析异构数据、缺少字段时允许默认值填充 |
元素迭代 / enumerate |
由迭代协议驱动,根本无越界概念 | 最优 | 所有全量或带序号的序列遍历业务 |
- 空集边界测试:向目标截取函数传入空列表
[],确认程序不再抛出IndexError,并能正确返回默认值或空结果。 - 单元素极限测试:传入只有 1 个元素的列表
[x],分别请求下标0、1、-1、-2,确认边界行为符合预期。 - 超长范围切片测试:传入长度为 3 的列表,执行
[0:100]与[5:10]截取,确认分别返回原全部列表与空列表。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















