


Python修饰器(装饰器)是什么:概念与基本用法
本文系统解析Python修饰器(装饰器)的本质概念与基本用法。从函数一等公民特性出发,详解@语法糖原理、参数转发规范与functools.wraps元数据保留实践。
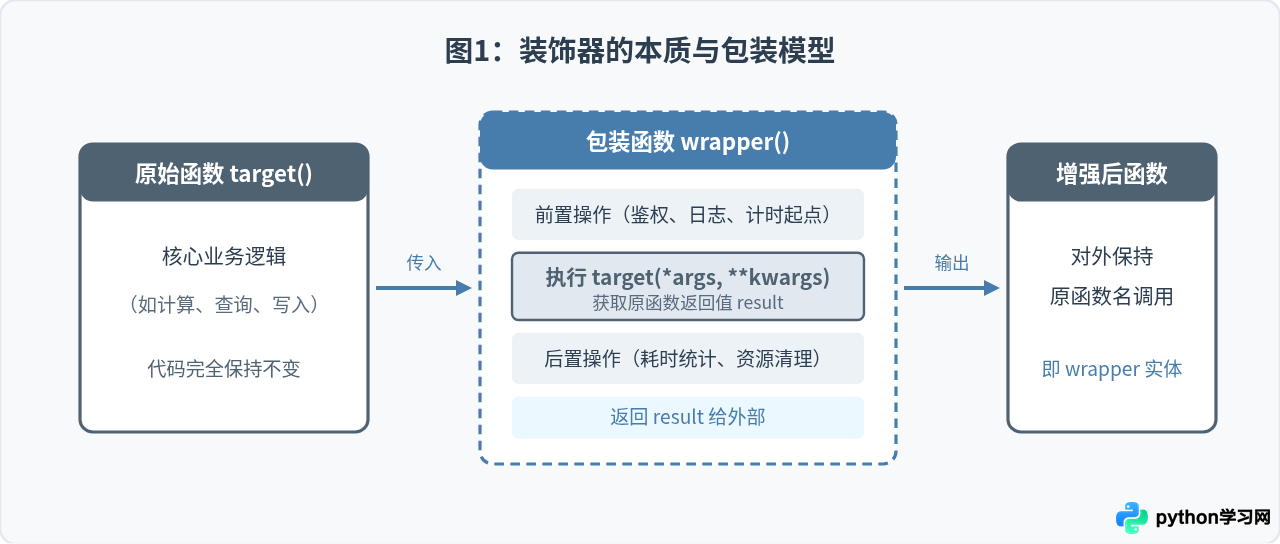
在 Python 开发中,修饰器(又称装饰器,Decorator)本质上是一种接收函数作为输入、并返回一个增强版新函数的可调用对象。它最直接的价值在于:在不修改原函数内部代码、也不改变原函数调用方式的前提下,给函数动态增加日志记录、执行计时、权限鉴权等通用附加功能。
一、为什么需要装饰器:核心概念拆解
在日常业务开发中,我们常常需要对某些已有函数补充通用的外围逻辑。例如,我们想知道某个数据导出函数运行了多久,最直接的做法是在函数内部开头记录开始时间,末尾记录结束时间并做差值。但如果项目中有十几个甚至上百个函数都需要统计耗时,直接修改每个函数的源代码不仅繁琐易错,还会让核心业务逻辑被大量重复的代码污染。
装饰器的设计就是为了解决这种横切关注点的问题。它像给礼物包上一层精美的礼品纸:里面的礼物(核心函数逻辑)完全不变,但外表多了一层包装纸(前置与后置增强逻辑)。外部调用者拿到的依然是一个可以直接调用的对象,使用习惯完全保留。
二、理解装饰器的基石:Python 函数的三大特性
要真正写出并理解装饰器,必须先清楚 Python 中“函数是一等公民”(First-class Object)的具体含义。这意味着函数和普通的字符串、整数一样,具有完整的实体属性:
- 函数可以赋值给变量:如
greet = say_hello,之后greet()与say_hello()执行相同的逻辑。 - 函数可以作为参数传入另一个函数:一个函数能够接收其他函数名,并在自己内部触发执行。
- 函数内部可以嵌套定义新函数,并将其作为返回值返回:这就是构成“闭包”(Closure)的基础。
正是这三项特性的组合,让 Python 具备了在运行时用一个函数包裹另一个函数的能力。
三、手写基础装饰器与 @ 语法糖的本质
我们先抛开 @ 这个特殊符号,用最纯粹的函数嵌套来实现一个最简单的执行日志装饰器:
# 1. 定义装饰器函数,接收被装饰的目标函数 func
def my_logger(func):
    # 2. 在内部定义包装函数 wrapper
    def wrapper():
        print("[Log] 函数开始执行...")
        func()  # 调用原函数
        print("[Log] 函数执行结束.")
    # 3. 将包装好的新函数作为对象返回
    return wrapper

# 定义业务函数
def say_hi():
    print("你好,欢迎学习 Python 装饰器!")

# 手动执行装饰:将原函数交给装饰器,重新赋值给 say_hi
say_hi = my_logger(say_hi)

# 触发调用
say_hi()
运行上述代码,控制台会输出:
[Log] 函数开始执行...
你好,欢迎学习 Python 装饰器!
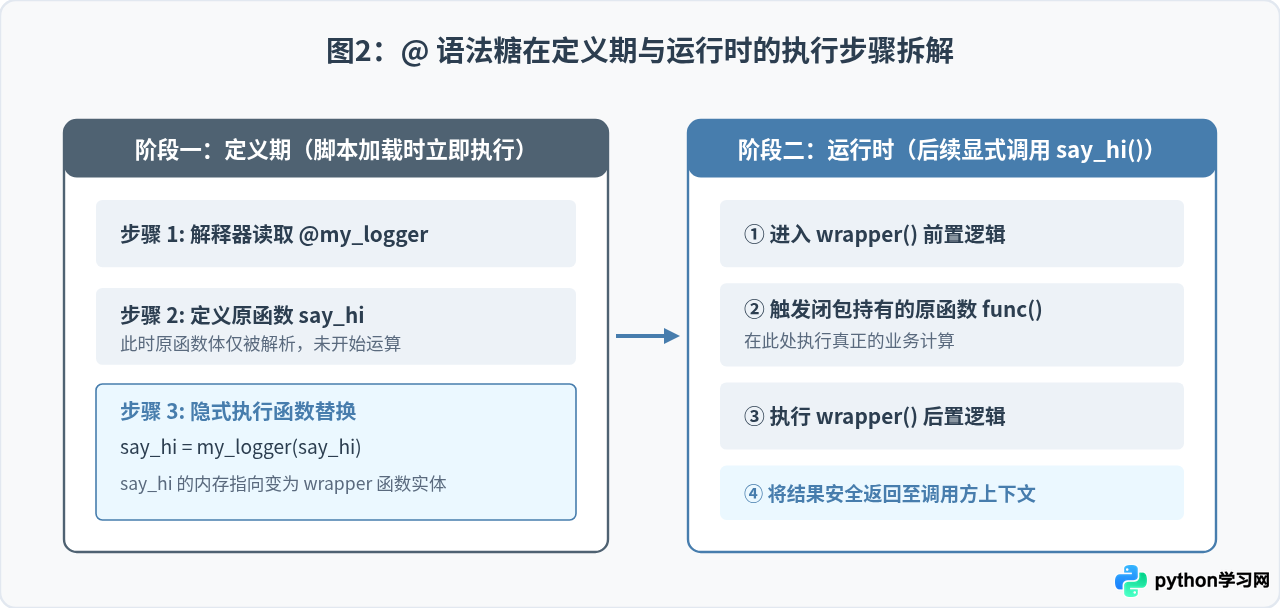
[Log] 函数执行结束.这个过程清晰展示了装饰器的运作过程:say_hi = my_logger(say_hi) 将原先指向基础打印逻辑的 say_hi 变量,重新指向了装饰器返回的 wrapper 函数。
而 Python 提供的 @ 符号,纯粹是上述赋值操作的语法糖(Syntactic Sugar)。以下两段写法在 Python 解释器眼里是完全等价的:
# 写法 A:使用 @ 语法糖
@my_logger
def say_hi():
    print("你好,欢迎学习 Python 装饰器!")

# 写法 B:底层等价执行逻辑
def say_hi():
    print("你好,欢迎学习 Python 装饰器!")
say_hi = my_logger(say_hi)
四、通用基本用法:处理任意参数与返回值
真实项目中的函数通常带有各种形式的入参,并且往往需要向外返回执行结果。初学者在写装饰器时,最常见的两个失误是:入参固定导致不通用以及忘记返回原函数计算结果。
为了让装饰器能够安全套用在任意签名的函数上,内部的 wrapper 必须接收 *args, **kwargs 进行变长参数打包,并在调用原函数时原样解包;同时必须显式使用变量接收原函数的返回值并将其 return 输出。
import time

# 通用函数执行耗时统计装饰器
def timer(func):
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        # 1. 完整透传位置参数和关键字参数,并接收返回值
        result = func(*args, **kwargs)
        end_time = time.perf_counter()
        cost = end_time - start_time
        print(f"[耗时统计] 函数 {func.__name__} 执行耗时: {cost:.6f} 秒")
        # 2. 务必将原函数的结果返回出去,否则外部调用将得到 None
        return result
    return wrapper

# 示例:被装饰的带参和带返回值函数
@timer
def calculate_sum(n):
    total = 0
    for i in range(1, n + 1):
        total += i
    return total

# 测试调用
ans = calculate_sum(1000000)
print(f"计算结果为: {ans}")
输出示例:
[耗时统计] 函数 calculate_sum 执行耗时: 0.041829 秒
计算结果为: 500000500000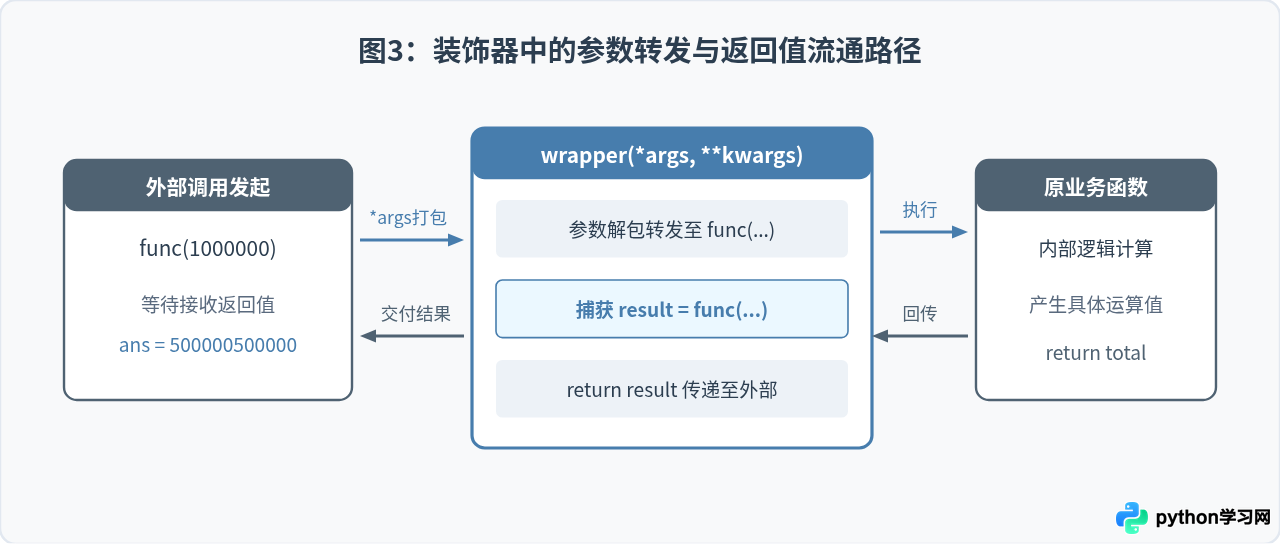
五、生产必加规范:使用 functools.wraps 保护函数元信息
虽然经过装饰后的函数运行正常,但如果我们在控制台检查该函数的属性,会发现一个隐蔽问题:
print(calculate_sum.__name__)  # 输出: wrapper
print(calculate_sum.__doc__)   # 输出: None(或者 wrapper 的文档说明)
这是因为此时 calculate_sum 的实际对象已经变成了装饰器内部的 wrapper,原函数的名称、文档注释(Docstring)、参数签名等元信息都被 wrapper 掩盖了。这会导致自动化文档生成工具、反射机制以及调试时的堆栈回溯变得十分混乱。
Python 官方标准库 functools 提供了专门解决该问题的装饰器 @wraps。它的用法非常简单,只需在内部定义 wrapper 时,加上 @functools.wraps(func) 即可:
import functools
import time

def standard_timer(func):
    # 使用 @functools.wraps 拷贝原函数的元信息到 wrapper 上
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        """计时器包装内部函数"""
        start = time.perf_counter()
        res = func(*args, **kwargs)
        cost = time.perf_counter() - start
        print(f"[{func.__name__}] 耗时 {cost:.4f}s")
        return res
    return wrapper

@standard_timer
def fetch_user_data(user_id: int):
    """根据用户ID读取数据"""
    time.sleep(0.1)
    return {"id": user_id, "status": "active"}

# 验证元信息保留状态
print(fetch_user_data.__name__)  # 正确输出: fetch_user_data
print(fetch_user_data.__doc__)   # 正确输出: 根据用户ID读取数据
在所有实际业务与开源组件开发中,编写自定义装饰器时,始终将 @functools.wraps(func) 放在 wrapper 定义上方是必须遵守的标准工程规范。
六、知识总结与避坑检查清单
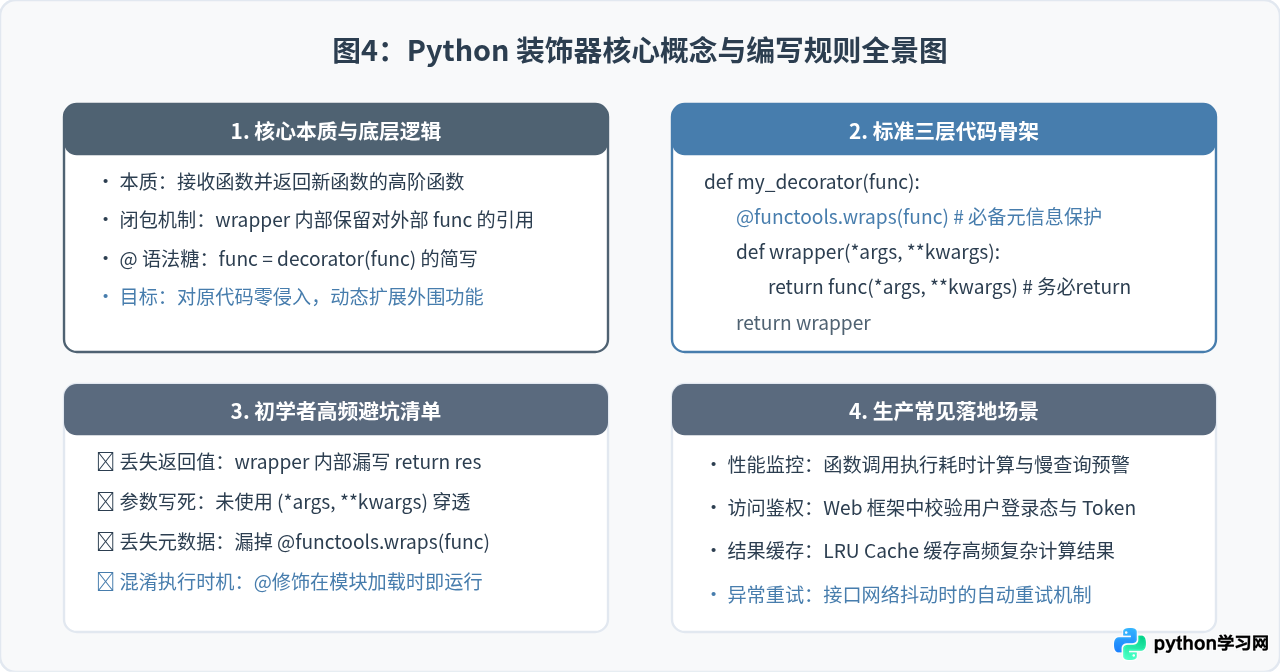
总结来说,Python 修饰器(装饰器)是函数式编程思维与 Python 动态特性的经典结合。掌握装饰器能够让代码的职责划分更为清晰,把纯粹的业务计算与外围的日志、计时、重试、鉴权彻底解耦。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















