


通过实战项目巩固Python技能:爬虫、Web与数据分析案例
通过网络爬虫、轻量Web服务与数据分析三个典型实战案例,深入讲解如何将Python语法与核心库转化为解决实际问题的工程能力。
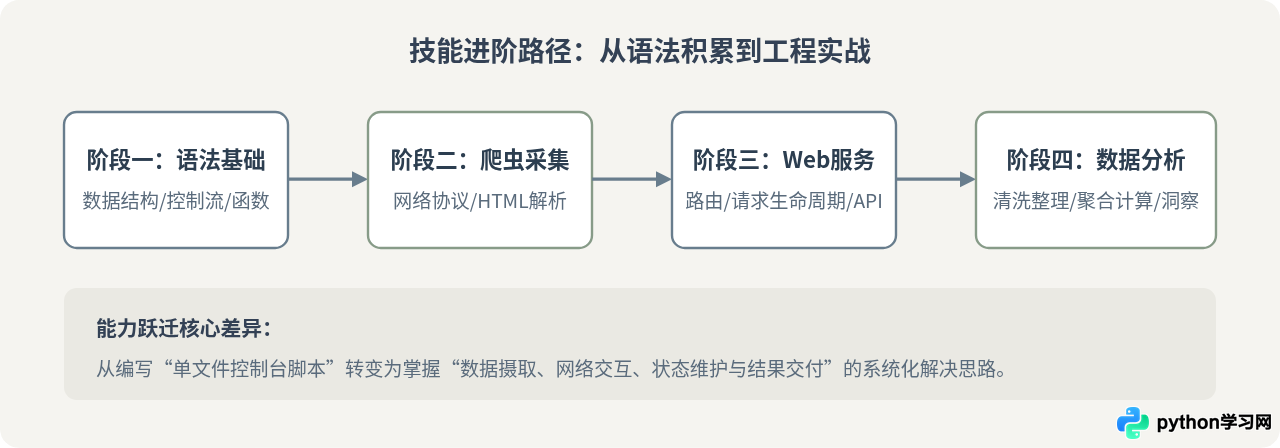
掌握了变量、循环、函数与面向对象等基础语法后,很多学习者会遇到“语法都会,但面对需求不知如何下手”的瓶颈。解决这一问题的有效路径不是重复阅读语法手册,而是通过目标明确的实战项目,将零散知识点串联进完整的工程链路。本文选取网络爬虫、轻量Web服务以及数据分析三个经典方向,通过具体案例说明从环境搭建、代码实现到边界处理的完整过程,帮助读者建立端到端的工程实现能力。
一、实战前置:构建统一的工程环境
进行实战前,推荐为每个项目创建独立的虚拟环境,以避免不同第三方库版本间的冲突。以下为标准配置流程:
# 1. 创建并激活虚拟环境(macOS/Linux)
python3 -m venv venv
source venv/bin/activate

# 2. 安装案例所需的依赖库
pip install requests beautifulsoup4 flask pandas
完成依赖安装后,可分别通过模块导入确认环境正常。接下来,我们将按“数据获取-服务发布-分析洞察”的逻辑依次展开。
二、爬虫实战:结构化数据采集与异常处理
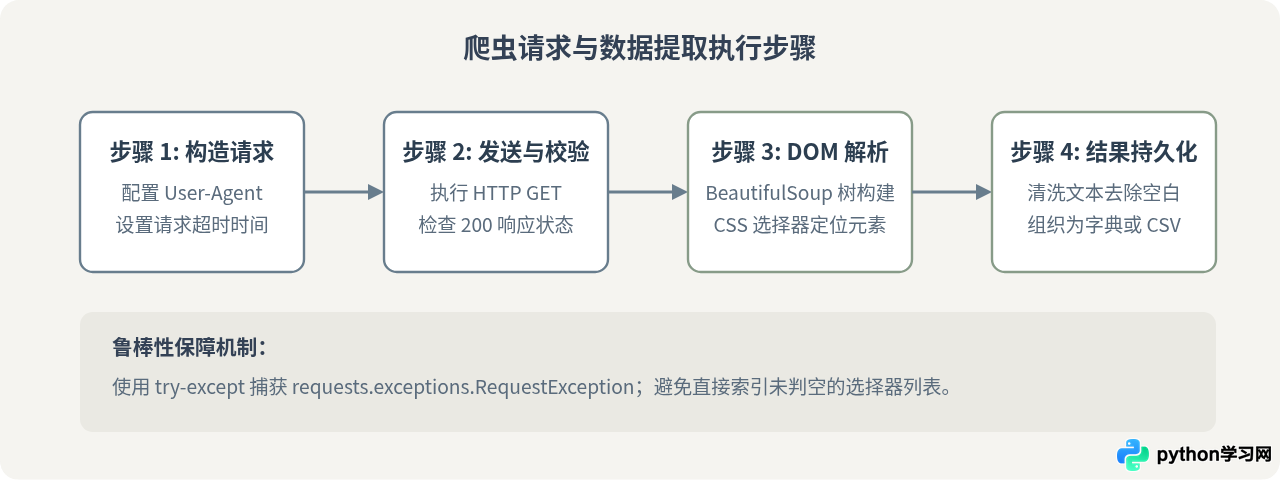
爬虫项目的核心目标是掌握 HTTP 请求机制、状态码处理以及 DOM 树的结构化解析。初学者常犯的错误是忽略网络波动与异常保护,导致单次请求失败中断整个采集任务。
案例代码:采集技术文章列表
import requests
from bs4 import BeautifulSoup
import csv

def scrape_articles(target_url):
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
    }
    results = []

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status()
    except requests.exceptions.RequestException as e:
        print(f"网络请求失败: {e}")
        return results

    soup = BeautifulSoup(response.text, "html.parser")
    # 定位文章卡片
    cards = soup.select(".article-card")
    for card in cards:
        title_el = card.select_one(".title")
        author_el = card.select_one(".author")

        # 边界保护:确保关键标签存在
        title = title_el.get_text(strip=True) if title_el else "无标题"
        author = author_el.get_text(strip=True) if author_el else "未知作者"
        results.append({"title": title, "author": author})

    return results

if __name__ == "__main__":
    url = "https://quotes.toscrape.com/"
    data = scrape_articles(url)
print(f"成功采集到 {len(data)} 条记录")robots.txt 协议,合理设置请求间隔时间(例如 time.sleep(1)),避免因并发过高对目标服务器造成压力。
三、Web 实战:构建轻量级 RESTful API 服务
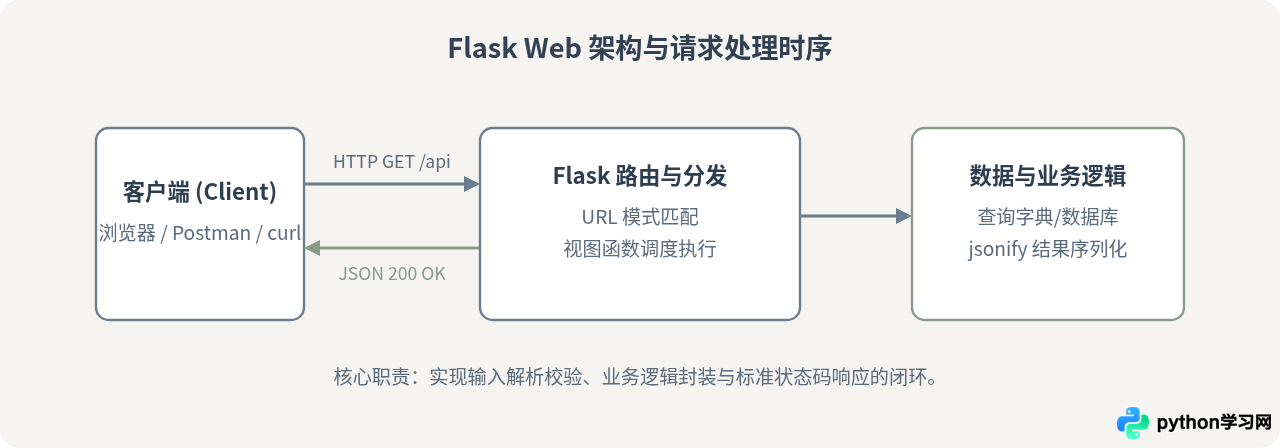
掌握爬虫后,数据通常需要呈现或提供给下游使用。Web 开发能够让开发者深入理解客户端-服务端交互模型、路由机制、HTTP 方法(GET/POST)以及 JSON 数据的序列化与反序列化。
案例代码:书籍资源管理微服务
from flask import Flask, jsonify, request

app = Flask(__name__)

# 内存模拟数据源
BOOKS = [
    {"id": 1, "title": "Python 编程:从入门到实践", "category": "编程", "price": 89.0},
    {"id": 2, "title": "流畅的 Python", "category": "编程", "price": 139.0},
    {"id": 3, "title": "统计学习方法", "category": "数据科学", "price": 98.0}
]

@app.route("/api/books", methods=["GET"])
def get_books():
    category = request.args.get("category")
    if category:
        filtered = [b for b in BOOKS if b["category"] == category]
        return jsonify({"code": 200, "data": filtered})
    return jsonify({"code": 200, "data": BOOKS})

@app.route("/api/books", methods=["POST"])
def add_book():
    data = request.get_json()
    if not data or "title" not in data or "price" not in data:
        return jsonify({"code": 400, "error": "缺少必要字段"}), 400

    new_book = {
        "id": len(BOOKS) + 1,
        "title": str(data["title"]).strip(),
        "category": str(data.get("category", "默认")),
        "price": float(data["price"])
    }
    BOOKS.append(new_book)
    return jsonify({"code": 201, "data": new_book}), 201

if __name__ == "__main__":
    # 本地调试运行
    app.run(host="127.0.0.1", port=5000, debug=True)
在终端启动该服务后,可通过浏览器或 curl -X GET "http://127.0.0.1:5000/api/books" 验证返回结果,直观理解路由与参数过滤的对应关系。
四、数据分析实战:从脏数据清洗到统计建模
数据分析关注的是如何从原始、不规则的数据集中提炼有效信息。相较于爬虫获取数据和 Web 传输数据,数据分析考验的是批量数据操作思维。核心库 Pandas 提供了高效的向量化操作,避免了低效的纯 Python 循环。
两类数据处理模式的关键差异对比
| 对比维度 | 标准循环模式 (原生 Python) | 向量化操作模式 (Pandas / NumPy) |
|---|---|---|
| 执行机制 | 按行遍历解释执行,反复创建临时对象 | C语言底层连续内存批量计算 |
| 空值处理 | 需在循环体内嵌套多个 if-else 判定 | 内置 fillna、dropna 或向量化判断方法 |
| 适用场景 | 简单单次规则判断、少于万条的小型数据 | 大规模结构化表格、多列交叉运算与聚合统计 |
案例代码:销售数据清洗与聚合计算
import pandas as pd
import numpy as np

# 1. 模拟含有缺失值与异常格式的原始数据
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005],
    "item": ["笔记本电脑", "无线鼠标", "机械键盘", "4K显示器", "Type-C拓展坞"],
    "category": ["数码", "外设", "外设", "数码", np.nan],
    "amount": ["¥6999", "¥129", "¥399", "¥2499", "¥199"],
    "quantity": [2, 10, None, 1, 5]
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗过程
# 处理文本货币符号并转化为浮点型
df["amount_clean"] = df["amount"].str.replace("¥", "").astype(float)

# 缺失值填充
df["category"] = df["category"].fillna("其他")
df["quantity"] = df["quantity"].fillna(1).astype(int)

# 计算订单总额
df["total_cost"] = df["amount_clean"] * df["quantity"]

# 3. 按类别分组聚合分析
summary = df.groupby("category").agg(
    total_sales=("total_cost", "sum"),
    order_count=("order_id", "count"),
    avg_price=("amount_clean", "mean")
).reset_index()

print("清洗后数据表:\n", df[["order_id", "item", "category", "total_cost"]])
print("\n类别汇总报表:\n", summary)
五、实战总结:三大领域的技能融合
网络爬虫、Web 开发与数据分析并非互不相关的技能孤岛。在真实的业务场景中,这三者往往构成了一条完整的数据闭环:通过爬虫获取网络信息,交由 Pandas 进行清洗聚合与指标提取,最后通过 Flask 或 Django 以可视化报表或 RESTful API 的形式对外分发。
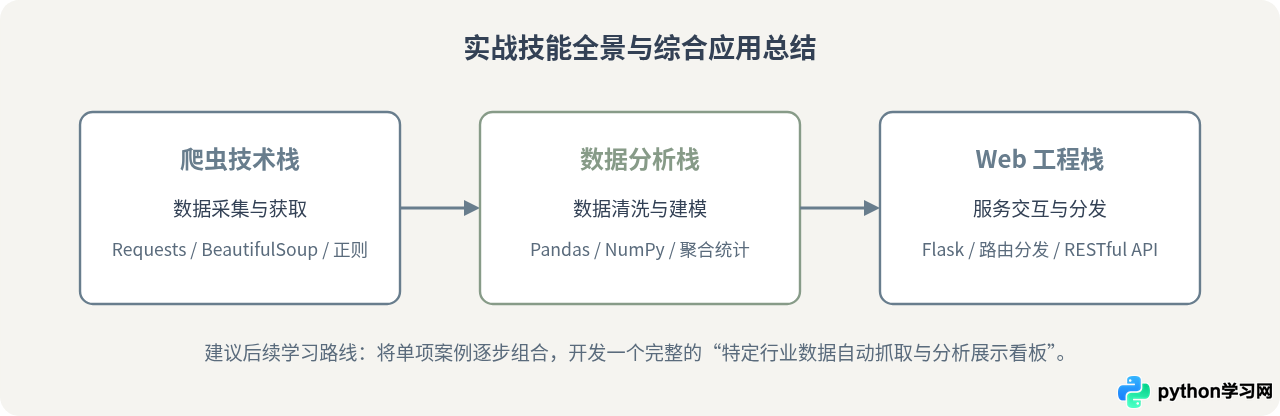
通过这三个针对性案例的练习,可以帮助开发者彻底跳出基础语法的机械记忆,学会站在“输入、转换、输出”的系统视角思考问题,从而真正将 Python 转化为可用的工程生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















