


数据科学和机器学习项目,Python版本选新还是选旧?
在数据科学与机器学习项目中,Python版本选新还是选旧直接决定了环境配置的成败。本文详解底层二进制轮子兼容机制、框架生态支持周期以及明确的选型决策方法。
在数据科学和机器学习项目中,Python版本的选择遵循一个明确的标准:选次新不选最新,选主流不选过旧。常规推荐选择已发布1到2年、生态支持最充分的“黄金版本”(目前主流推荐为 Python 3.10 或 3.11),而不是刚推出的最新次版本(例如刚发布的 3.13 早期阶段),更不能停留在已停止安全维护或被主流库弃用的旧版本(如 3.8 或更早)。做出这一判断的核心原因,在于数据科学技术栈的高度特殊性——核心算法库依赖大量预编译的底底二进制轮子(C/C++ 与 CUDA 扩展),版本的选择本质上是在“语言新特性”与“底层驱动及预编译库兼容性”之间寻找平衡点。
一、底层逻辑:为什么数据科学项目不能盲目追新?
对于纯 Web 开发或自动化脚本,升级 Python 版本通常意味着免费获得官方解释器的性能提升与语法甜头。但在数据科学与机器学习领域,盲目追新是导致项目在环境初始化阶段直接崩溃的首要诱因。
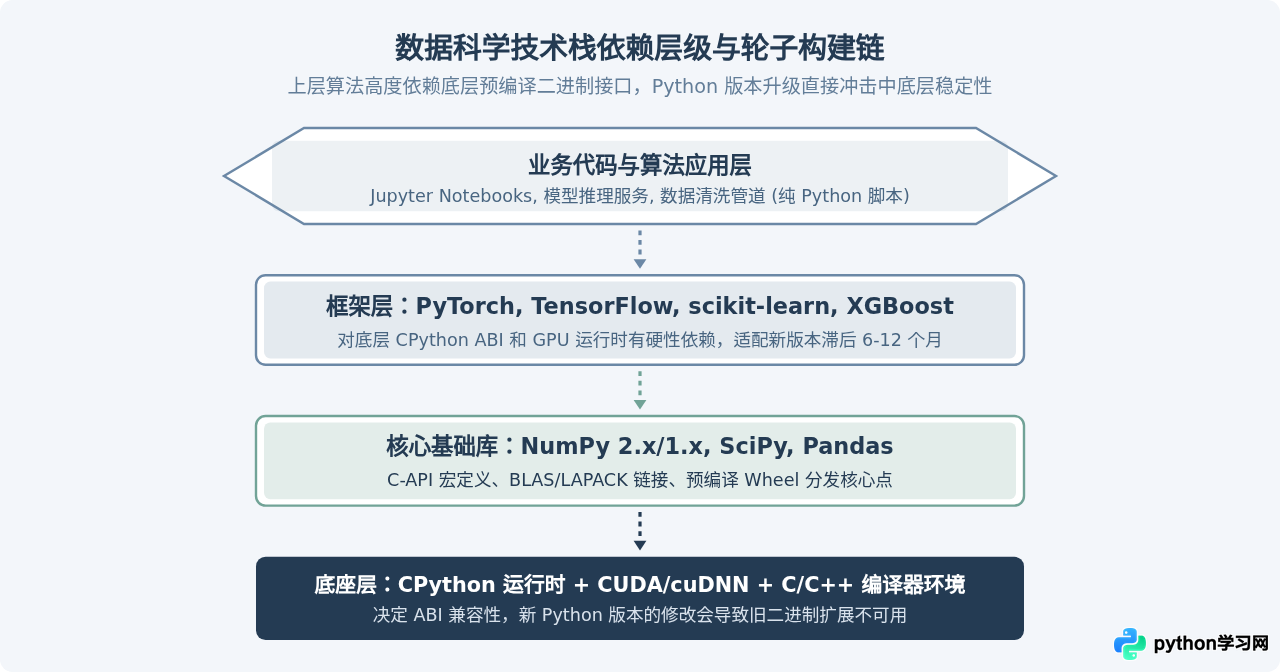
与纯 Python 代码包不同,NumPy、SciPy、PyTorch、TensorFlow、XGBoost 和 LightGBM 等核心库的主干计算模块均由 C、C++、Fortran 或 CUDA 编写。这些模块必须通过 CPython 的 C-API 编译为针对特定平台和特定 Python 小版本的二进制扩展包(即 .whl 轮子文件)。当 Python 推出一个全新的次版本时,底层生态面临以下客观门槛:
- 预编译轮子(Pre-built Wheels)的时滞: 官方与社区需要时间更新持续集成(CI)流水线,为主流操作系统构建并测试预编译 Wheel。新版本刚发布的数月内,PyPI 上往往缺乏对应版本的轮子。
- 本地源码编译的报错陷阱: 当通过
pip安装某个库且找不到现成 Wheel 时,pip 会退回源码编译模式。这要求开发者本地配备与库要求完全吻合的 C/C++ 编译器、Fortran 工具链以及对应版本的 CUDA Toolkit。绝大多数开发环境缺乏这些配置,最终导致诸如Failed to build wheel或fatal error: Python.h: No such file or directory的繁重报错。 - CUDA 与深度学习框架的刚性绑定: PyTorch 和 TensorFlow 等大型框架对 Python、CUDA 驱动版本及底层 C++ ABI 有严格的兼容性矩阵。通常一个新 Python 版本发布后,深度学习框架需要半年甚至更长时间才会发布提供稳定 GPU 加速支持的官方生产级轮子。
二、技术债务:为什么不能长久固守旧版本?
既然追新有风险,那么“长期保留在旧版本(如 Python 3.7 或 3.8)上不升级”是否可行?答案同样是否定的。固守旧版本会带来严重的技术停滞与安全隐患:
- NEP 29 与社区弃用周期: 科学计算生态遵循 NEP 29(NumPy 增强提案)及相关演化规则。该标准规定核心科学计算库在特定时间点后,将正式终止对过去 42 个月以前发布的 Python 版本的支持。目前,NumPy、Pandas、SciPy 与 scikit-learn 均已全面放弃对 Python 3.8 及更早版本的支持。
- NumPy 2.0 带来的 ABI 断代分水岭: 2024 年推出的 NumPy 2.0 重新梳理了底层 C API。旧版本的 Python 无法安装包含现代安全补丁与新算法特性的现代库版本,导致项目陷入依赖锁死状态。
- 官方安全维护终止(EOL): Python 官方对每个主要次版本提供 5 年支持(前 1.5 年功能迭代,后 3.5 年安全补丁)。Python 3.8 已于 2024 年 10 月正式到达生命终点(End-of-Life),任何已知安全漏洞均不再接收修复,无法满足企业安全合规要求。
三、具体场景下的版本选择决策路径
在面对一个新启动或维护中的机器学习项目时,可以通过以下具体的决策树来明确应该选择哪一个 Python 版本:
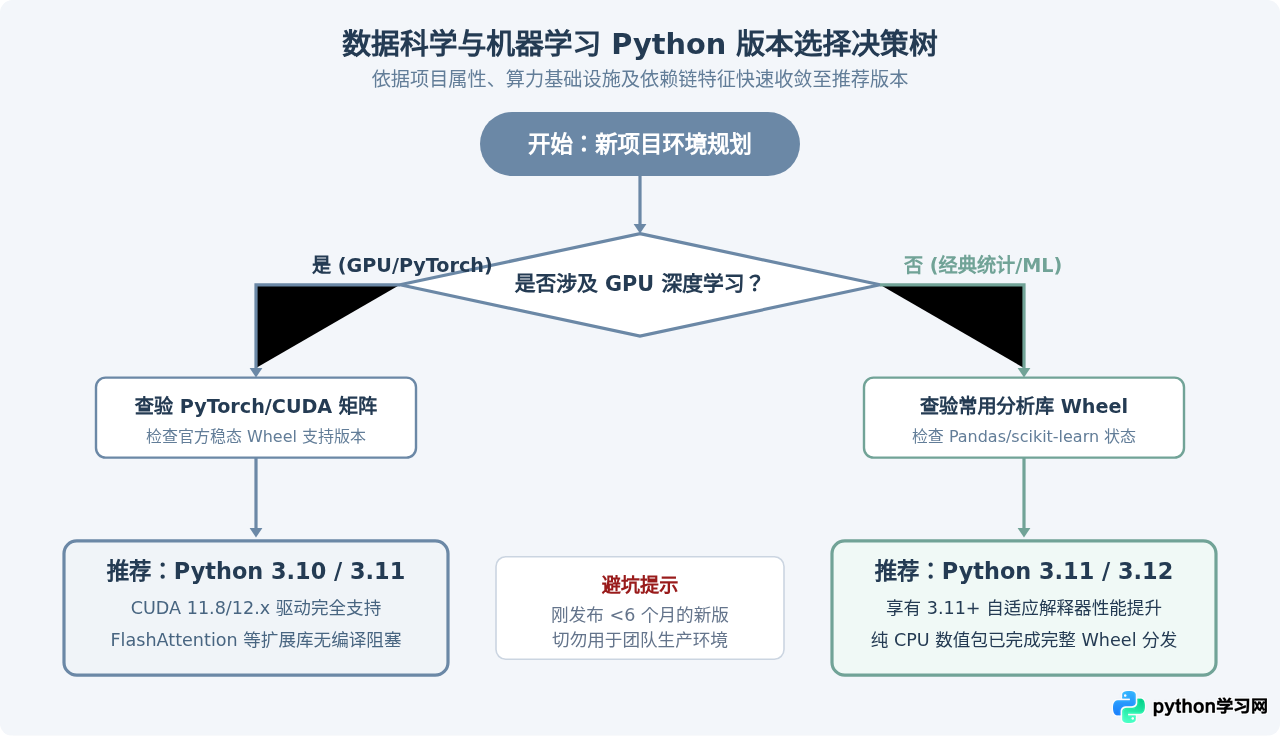
具体来看,项目通常落入以下三种典型场景之一:
- 深度学习与大模型训练项目: 该类项目对英伟达 CUDA 工具包、NCCL 通信库以及 PyTorch 版本的匹配度要求极高。推荐锁定 Python 3.10 或 Python 3.11。过新的 Python 3.12/3.13 往往缺少针对对应 CUDA 构建版本的官方 Wheel,极易导致 FlashAttention、vLLM 或 TensorRT 等辅助加速库安装失败。
- 经典机器学习与传统数据分析: 以 Pandas、NumPy、Scikit-learn、LightGBM 为核心的项目,对 GPU 底层依赖较小。推荐采用 Python 3.11 或 3.12。Python 3.11 引入的专业化自适应解释器带来了显著的基础性能提升,对于高频循环与 Python 层面的逻辑处理有明显的加速效果。
- 学术论文代码复现: 复现学术开源仓库时,切忌自行升级到新版 Python。必须严格按照作者声明的
requirements.txt或environment.yml中的版本号配置环境,必要时哪怕是 Python 3.8 也应单独在独立虚拟环境中运行,以避免随机数生成器实现或底层数学函数微小差异带来的实验结果不可复现。
四、标准实操流程:如何安全管理与验证版本兼容性
在确认了目标版本后,建立清晰的隔离环境与依赖验证流程是保证开发稳定性的核心。以下是执行版本落地与依赖锁定的规范步骤:
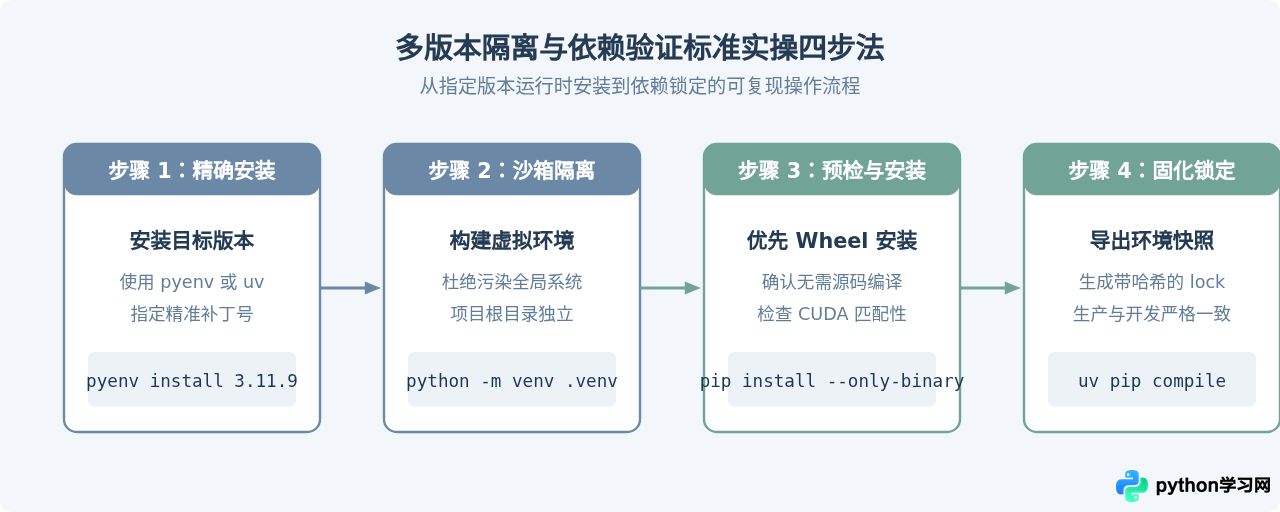
步骤一:使用版本管理工具安装稳定版 Python
避免直接覆盖系统自带的 Python 解释器。建议使用 pyenv 或现代高性能工具 uv 安装独立的次版本:
# 示例:通过 uv 安装指定的稳定版本 Python 3.11
uv python install 3.11

# 查看当前环境所有已安装的 Python 运行时
uv python list
步骤二:创建专用虚拟隔离环境
在项目根目录下创建专用的虚拟环境,确保该环境与其它项目的依赖库完全物理隔离:
# 基于 Python 3.11 创建项目虚拟环境 .venv
uv venv .venv --python 3.11

# 激活虚拟环境 (Linux/macOS)
source .venv/bin/activate

# 激活虚拟环境 (Windows PowerShell)
.venv\Scripts\Activate.ps1
步骤三:执行预编译轮子预检与核心库安装
在安装大型算法库时,可以通过 pip 验证是否可以直接下载到对应当前 Python 版本的轮子文件。对于深度学习项目,直接指定官方适配源:
# 针对 PyTorch 安装匹配当前系统的官方预编译 Wheel (以 CUDA 12.1 为例)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121

# 验证核心库安装成功及底层 CUDA 是否正常就绪
python -c "import torch; print('PyTorch Version:', torch.__version__); print('CUDA Available:', torch.cuda.is_available())"
如果输出显示 CUDA Available: True,说明底层 C-API、轮子与硬件驱动链条完全打通。
pip install 期间终端输出类似 Building wheels for collected packages... 并在数分钟后抛出长串 C++ 编译警告,说明该库对当前 Python 版本尚无预编译 Wheel,通常意味着你的 Python 版本选得过新,应果断退回前一个次版本。
五、总结:Python 版本定位与权衡全景
综合来看,不同生命周期的 Python 版本在数据科学项目中的表现可以总结为以下对照矩阵:
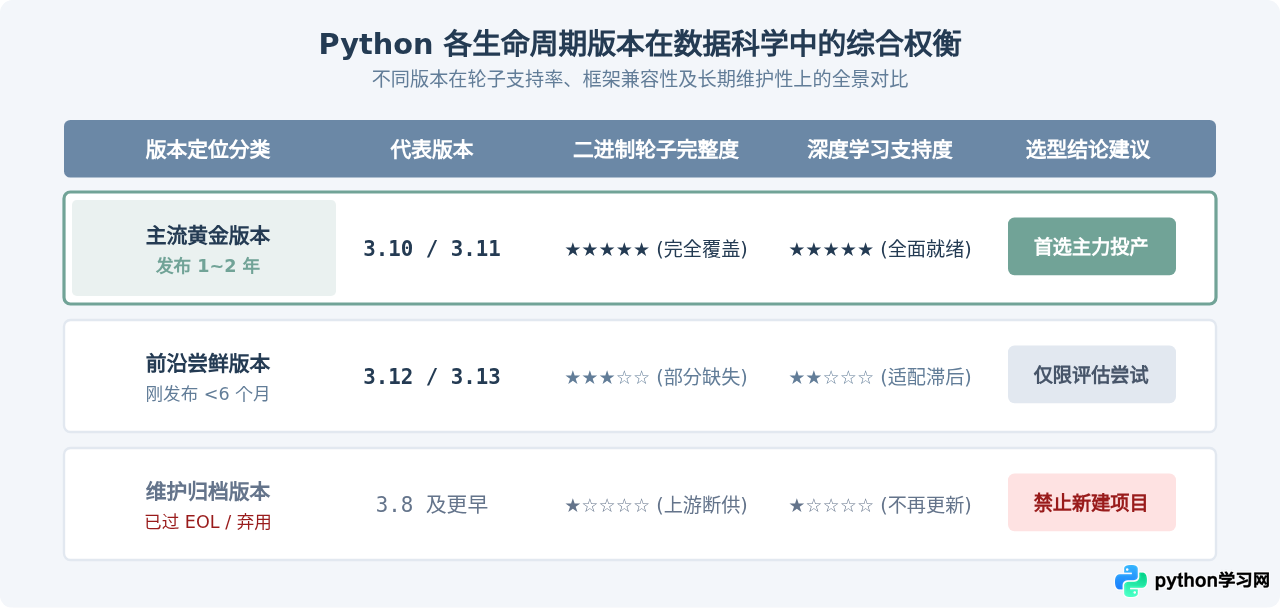
综上所述,数据科学项目的生产力核心并不在于追求第一天发布的语言新特性,而在于计算管线的确定性与可复现性。优先选择处于生态稳态期、预编译 Wheel 全面覆盖的次新版本(如 Python 3.10 或 3.11),配合虚拟环境隔离工具,能够最大程度消除因底层编译失败带来的时间损耗,让精力聚焦于核心算法与模型本身的迭代。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















