


Python读取非逗号分隔CSV并生成新文件的方法
本文详细讲解在Python中使用内置csv模块与pandas库读取制表符、分号、竖线等非逗号分隔符CSV文件,进行清洗转换并输出为新文件的完整方法与注意事项。
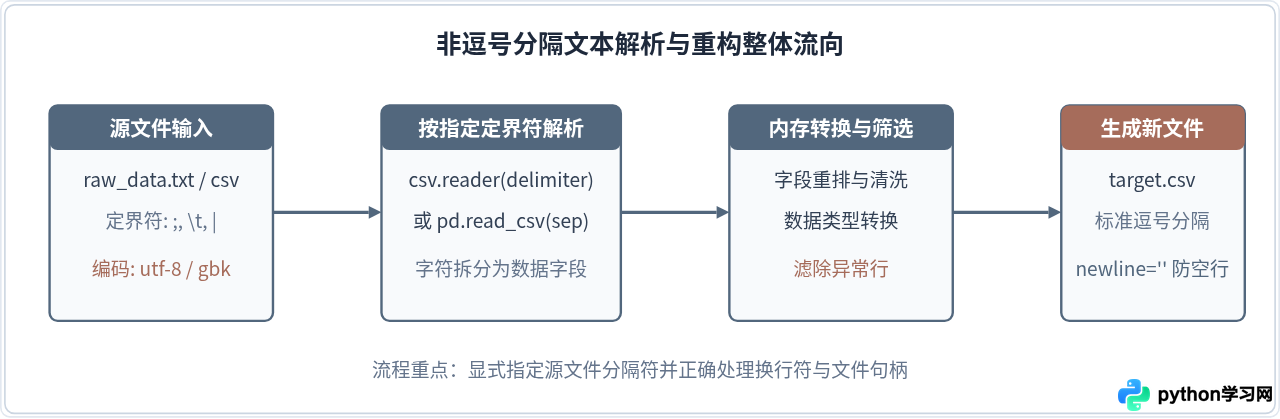
处理外部导出的表格文件时,虽然文件后缀标为 .csv 或 .txt,但字段间却常以制表符(\t)、分号(;)或竖线(|)进行分割。在 Python 中解决这一需求,核心路径非常明确:一是使用内置的 csv 模块并通过 delimiter 参数指定自定义定界符;二是利用数据分析库 pandas 的 read_csv(sep=...) 快速解析。随后在内存中完成过滤、重组或计算,再将处理后的数据以指定的分隔格式(如标准逗号分隔)写入新文件。
一、认识非逗号分隔文件的常见形态
标准 CSV(Comma-Separated Values)按规范以逗号分隔字段,但在欧洲区域系统或特定数据库导出日志中,由于逗号常被用作小数分隔符(例如 3,14),系统往往会改用分号(;)作为列分隔符。在数据仓库卸载或日志存储场景下,制表符(Tab,\t)或竖线(Pipe,|)则更为常见,能有效避免字段文本本身包含逗号时引发解析错乱。
假设我们有一个以竖线(|)分隔的原始文本文件 source_pipe.txt,其内容如下:
user_id|username|login_count|status
1001|alice|24|active
1002|bob|3|inactive
1003|charlie|18|active
若直接用普通的 csv.reader(f) 读取,Python 会默认以逗号切分,导致整行文本被识别成单一字段。因此,核心就是向解析器明确传入分隔字符。
二、使用内置 csv 模块读取并写入新文件
对于无需复杂统计转换的任务,直接使用 Python 标准库中的 csv 模块是最轻量的方案。csv.reader 和 csv.writer 均支持 delimiter 关键字参数。
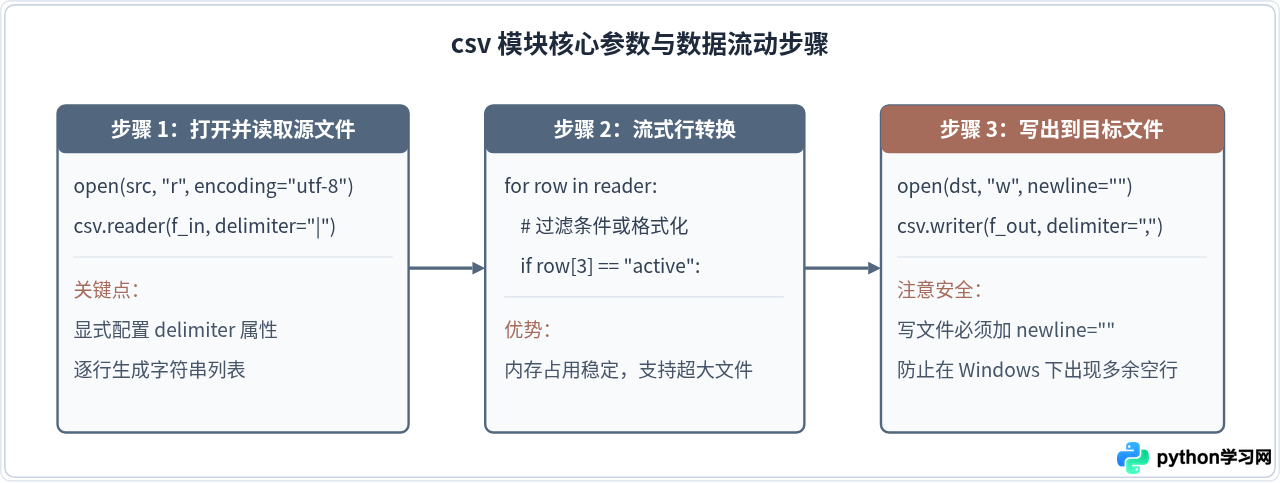
完整示例代码:转换竖线分隔文件为标准逗号 CSV
import csv

source_file = "source_pipe.txt"
output_file = "output_clean.csv"

# 1. 打开源文件与目标文件
with open(source_file, mode="r", encoding="utf-8") as f_in, \
     open(output_file, mode="w", encoding="utf-8", newline="") as f_out:

    # 指定读入分隔符为 '|'
    reader = csv.reader(f_in, delimiter="|")

    # 指定写出分隔符为 ','(默认即为逗号)
    writer = csv.writer(f_out, delimiter=",")

    # 逐行读取、处理并写入
    for row in reader:
        # 去除每个字段两侧多余的空格
        cleaned_row = [field.strip() for field in row]
        writer.writerow(cleaned_row)

print("新文件生成完成:", output_file)newline=""。如果不指定,Python 内置的 csv.writer 在 Windows 平台下写入时会额外追加 \r\r\n,导致生成的文件每行之间都夹带一个空白行。
三、使用 pandas 进行批量转换与高级筛选
当涉及列筛选、类型转换、聚合计算或批量数据清洗时,使用 pandas 库更为高效快捷。pandas.read_csv() 提供了 sep 参数,用以设定任意字符作为分隔符。
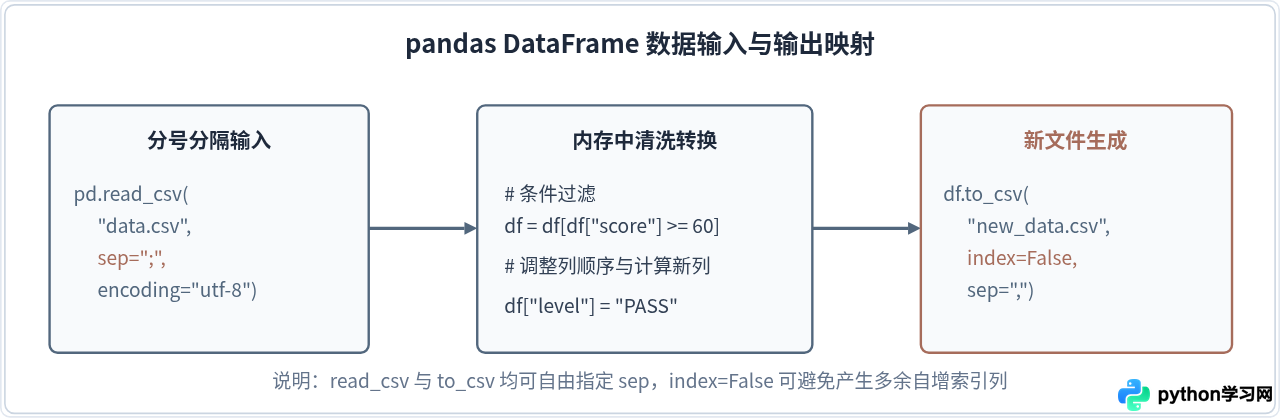
代码示例:读取分号分隔数据并生成新 CSV 文件
import pandas as pd

# 读取以分号分隔的原始数据文件
df = pd.read_csv("input_semicolon.csv", sep=";", encoding="utf-8")

# 针对数据进行清洗与转换(例如过滤出状态为 active 的用户)
filtered_df = df[df["status"] == "active"].copy()

# 重命名字段或新增计算列
filtered_df["processed"] = True

# 将清洗后的数据写为新的逗号分隔 CSV 文件,并忽略默认自增索引
filtered_df.to_csv("output_active_users.csv", sep=",", index=False, encoding="utf-8")

print("处理完毕,新文件已保存。")
四、技术方案对比与选型依据
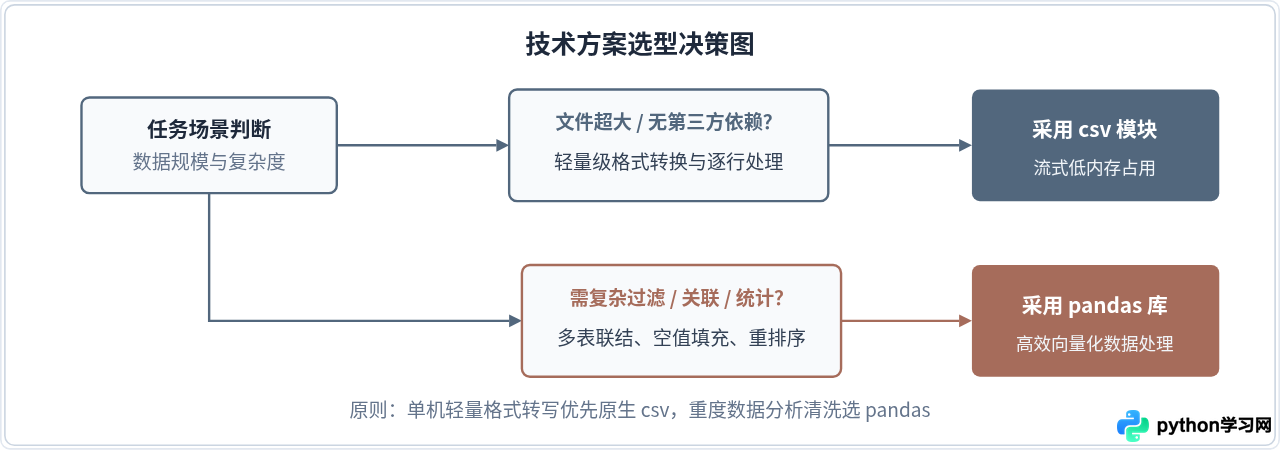
面对不同体量的数据与开发环境,开发者应根据以下维度合理选择实现方案:
| 评估维度 | 标准库 csv 模块 | 第三方库 pandas |
|---|---|---|
| 外部依赖 | 无依赖,纯 Python 原生环境可用 | 需安装 pandas 及相关依赖 |
| 内存占用 | 采用流式逐行迭代,支持 GB 级超大文件 | 默认全量载入内存,大文件易触发 OOM |
| 语法简洁度 | 需要嵌套上下文管理器与循环控制 | 单行调用即可完成读写与切片 |
| 复杂计算支持 | 弱,需手写列表推导或原生逻辑 | 极强,支持矢量化计算、分组聚合与重构 |
五、常见问题排查与注意事项
在实际执行转换时,经常会遇到编码报错或格式错位,可按以下几点进行针对性排查:
1. 分隔符自动检测机制:如果不确定原始文件的定界符到底是什么,可以使用 csv.Sniffer() 进行推断:
import csv

with open("unknown_data.txt", "r", encoding="utf-8") as f:
    sample = f.read(2048)
    dialect = csv.Sniffer().sniff(sample)
    print("推断定界符为:", repr(dialect.delimiter))
Sniffer 会基于前若干字符分析各标点符号的分布频率,自动得出当前文件最可能使用的 delimiter。
2. 文本中包含分隔字符本身的转义:如果字段文本本身包含了作为分隔符的字符(例如文本中包含了分号),上游系统通常会使用双引号将该字段包裹。此时 csv.reader 和 pandas.read_csv 默认都能通过引用机制(quotechar='"')正确识别,避免将字段内部的内容误切开。
3. 编码问题:如果在读取时遭遇 UnicodeDecodeError,说明原始文件并非以 utf-8 保存,特别是在 Windows 环境下导出的中文文件,常采用 gbk 或 utf-8-sig(带 BOM 头)。此时在打开文件或调用 read_csv 时应明确设置 encoding="gbk"。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















