



很多人第一次改 SQL 触发器时,都会先去找 ALTER TRIGGER,但一到跨数据库环境,这条路很快就走不通了:有的数据库只能改注释,有的根本没有这条语法,还有的表面支持替换,底层依然是删除再重建。真正能做到“业务无感”的关键,不是找到某条万能语句,而是把触发器更新当成一次可验证、可回滚、尽量无间隙的替换操作来设计。
这篇文章按“为什么不能直接改、怎样安全替换、替换后怎么验证”的顺序展开,并补上不同数据库下容易忽略的限制条件。读完后,你可以更快判断当前库该用事务、锁表还是低峰窗口来处理,也能提前避开权限、依赖和复制环境里的常见问题。
为什么不能直接用 ALTER TRIGGER 改逻辑?
触发器看上去像普通数据库对象,但在不同数据库里,它的“可修改性”差异很大。
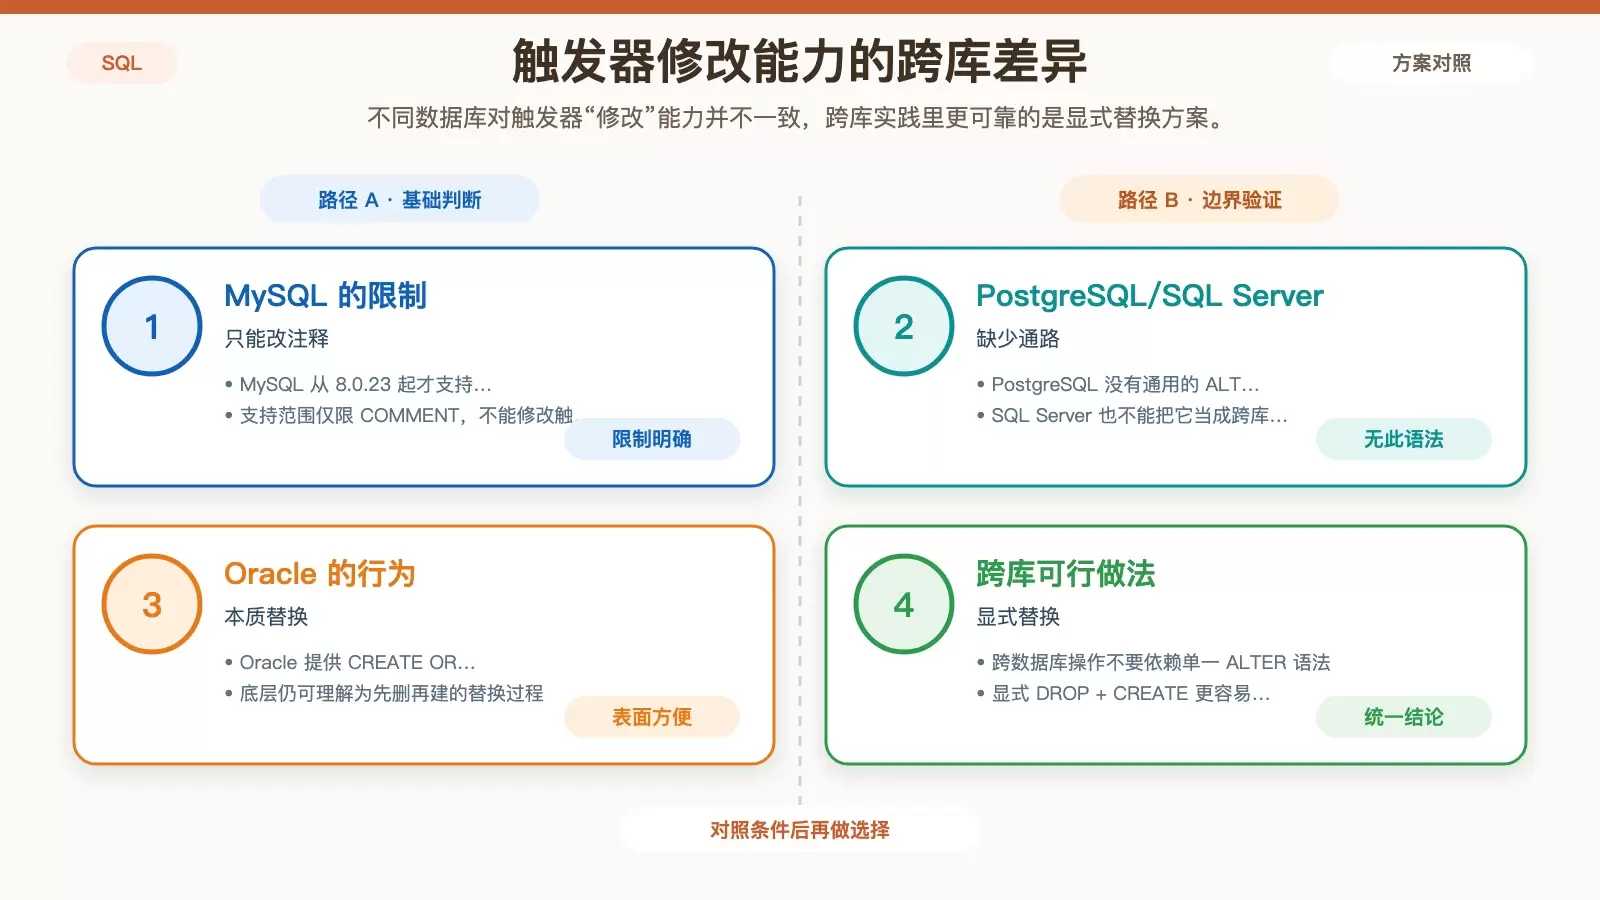
MySQL:8.0.23 起支持 ALTER TRIGGER,但不能改逻辑
MySQL 从 8.0.23 版本起才支持 ALTER TRIGGER,而且范围非常有限,只能修改 COMMENT,不能直接改触发器执行逻辑。这意味着只要你要调整 BEGIN...END 里的业务代码,本质上还是得重建触发器。
PostgreSQL 和 SQL Server:没有 ALTER TRIGGER 这条通用出路
PostgreSQL 和 SQL Server 并没有这里讨论意义上的通用 ALTER TRIGGER 方案来直接修改逻辑,因此不能把“在线修改”寄托在一条 DDL 上。要更新逻辑,实际操作仍然会落回删除旧定义、创建新定义。
Oracle:CREATE OR REPLACE 看似方便,底层仍是替换
Oracle 虽然提供 CREATE OR REPLACE TRIGGER,但底层行为依然可以理解为先删除旧对象,再创建新对象。也就是说,跨库操作时不能因为 Oracle 语法更顺手,就误以为它天然避免了切换窗口。
因此,跨数据库要追求稳定一致,最可靠的思路仍然是显式原子替换:把触发器修改看成一次受控的 DROP + CREATE。
不停机替换触发器的安全做法
不能直接“修改”触发器而不中断其生效逻辑,但可以原子性地替换它。操作目标只有一个:让新旧逻辑切换尽量无间隙、无竞态,避免在中间空窗期发生写入。
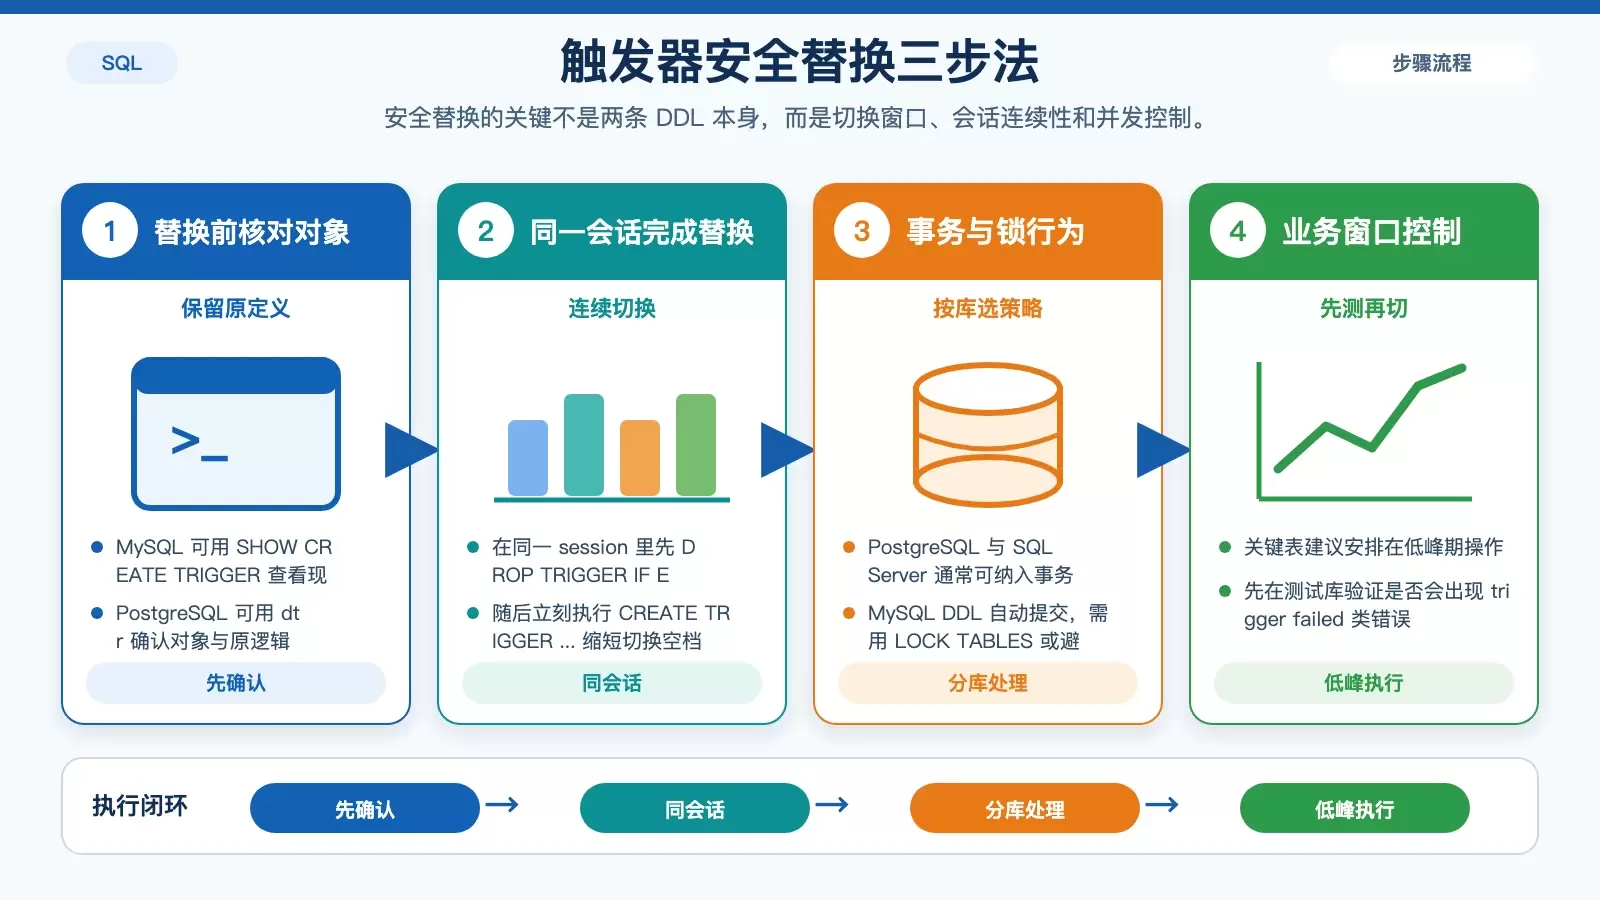
第一步:先确认原定义,避免误删误建
替换前先把当前触发器定义确认清楚,不要凭记忆操作。
- MySQL 可先执行
SHOW CREATE TRIGGER - PostgreSQL 可用
dtr(psql)查看定义
这一步的作用很直接:一是确认你删的是正确对象,二是保留现有定义,出问题时便于快速恢复。
第二步:用同一会话完成 DROP 和 CREATE
核心操作是:在同一 session 中执行 DROP TRIGGER IF EXISTS trigger_name,随后立刻执行 CREATE TRIGGER ...。这样可以尽量缩短旧逻辑消失到新逻辑生效之间的时间,避免其他写入在中间命中空档或旧路径。
DROP TRIGGER IF EXISTS trigger_name;
CREATE TRIGGER ...
如果环境支持事务,这组操作最好纳入同一事务边界中处理;如果数据库 DDL 会隐式提交,就要额外考虑锁和业务窗口。
第三步:按数据库特性选择事务、锁表或低峰窗口
这一步决定你能否真正做到“业务无感”。
- PostgreSQL、SQL Server:通常可以在事务中执行,利用事务边界减少切换风险
- MySQL:DDL 会自动提交,不能简单套用同样做法,通常需要用
LOCK TABLES,或者明确避开高并发窗口 - 关键业务表:建议放在低峰期执行,并提前在测试库验证新触发器是否会抛出类似
ERROR: cannot insert into table "xxx" because trigger "yyy" failed的错误
这里最需要警惕的是“以为自己在线修改,实际上只是把风险换了个位置”。如果没有结合库的 DDL 锁行为和并发写入特征来安排窗口,理论上的原子替换也可能在实战中暴露空隙。
替换触发器时最容易踩的 4 个坑
从语法上看,替换触发器往往只有两行 DDL,但真正出问题的地方通常在环境细节。
权限不完整,DROP 成功但 CREATE 失败
执行用户通常需要同时拥有 TRIGGER 和 ALTER(或 CREATE)权限。尤其在 MySQL 中,仅有 TRIGGER 权限并不足以创建新触发器。最坏情况是旧触发器已经删除,新触发器却没有成功建回来。
依赖对象未同步,新定义无法创建
如果新触发器引用了刚重命名的列、尚未发布的函数,或者其他依赖对象版本不一致,CREATE TRIGGER 会直接失败,例如报出 function xxx() does not exist。这类问题在多环境发布时尤其常见。
PostgreSQL 中 NOW() 与长事务的时间陷阱
在 PostgreSQL 触发器里,NOW() 取的是事务启动时间,而不是代码执行到这一行时的实时系统时间。如果替换过程中存在长事务未提交,新触发器可能读到“过期”的 OLD 值,排查起来会很绕。
MySQL 复制环境里的 DEFINER 问题
在主从或复制环境里,如果新触发器没有显式声明 DEFINER = 'user'@'host',可能会因为默认 definer 在从库权限不足而报 Trigger execution error。这种问题经常不是在主库替换时暴露,而是在复制回放阶段才出现。
替换后怎么确认已经生效,而且没有漏触发?
只查元数据还不够。确认触发器是否真正切换成功,重点要看“行为”而不只是“定义存在”。
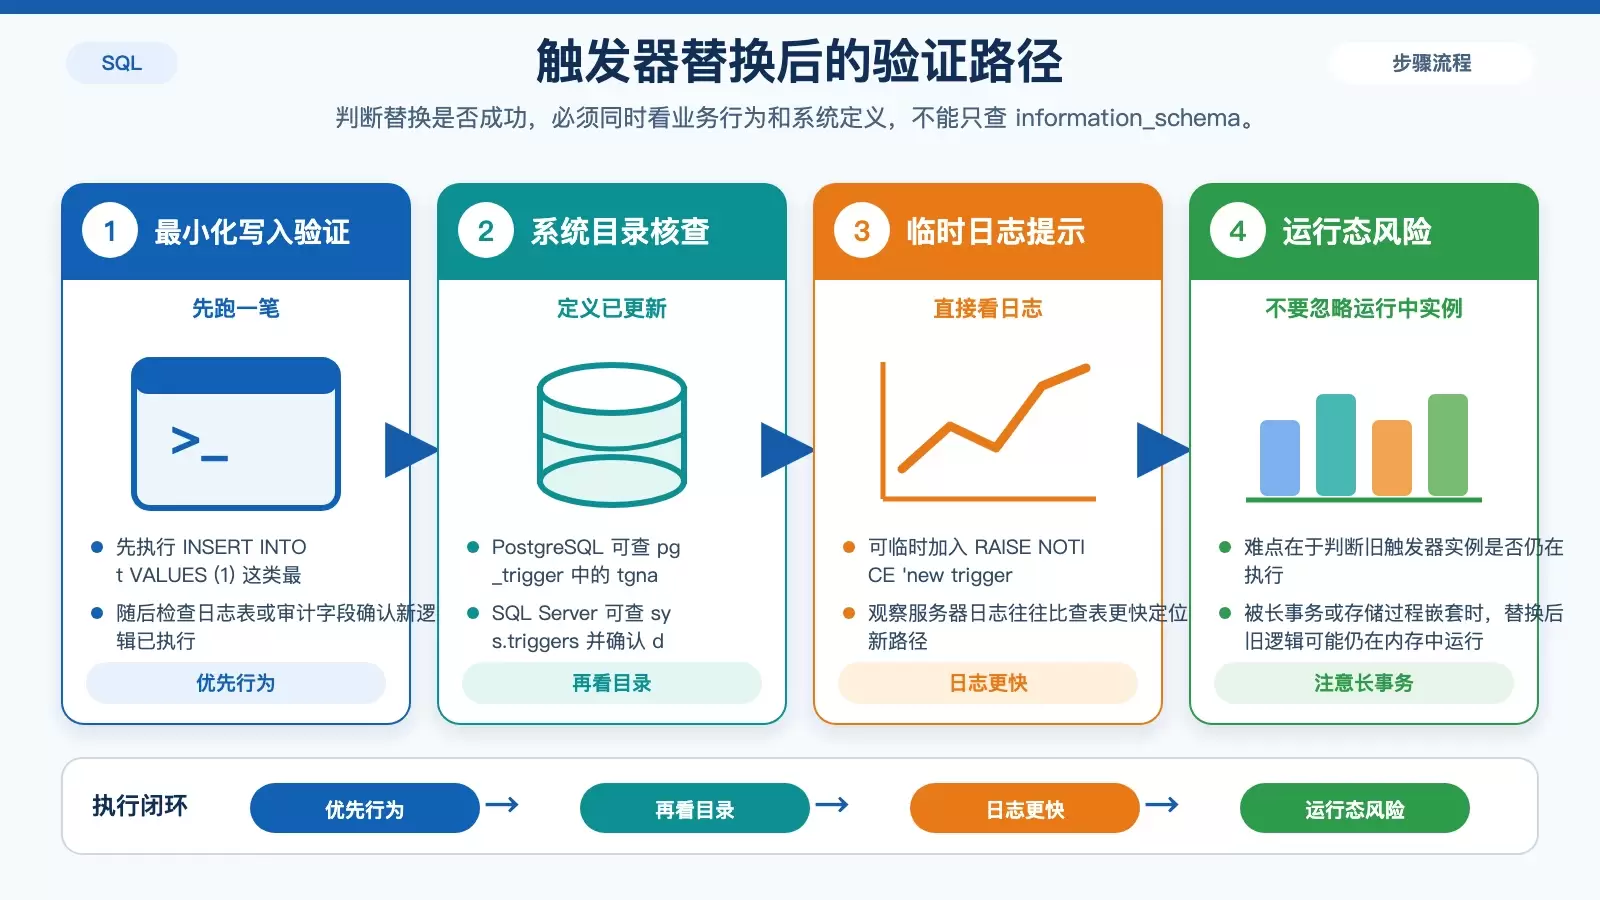
先做一次最小化写入测试
最直接的办法,是对目标表做一次最小化测试写入,例如:
INSERT INTO t VALUES (1);随后立即查询日志表、审计字段或联动结果,确认执行的已经是新逻辑。这一步比单查系统表更接近真实业务路径。
再查系统目录,确认定义确实更新
行为验证之后,再回到系统视图补一层确认:
- PostgreSQL:
SELECT COUNT(*) FROM pg_trigger WHERE tgname = 'trigger_name' - SQL Server:
SELECT * FROM sys.triggers WHERE name = 'trigger_name'
重点不是只看“有没有这条触发器”,还要确认 tgproc 或 definition 等关联字段已经指向新版本定义。
必要时临时打日志,比查表更快
如果触发器里本身包含 RAISE EXCEPTION 或 SIGNAL 这类控制语句,可以临时加入一条可识别日志,例如:
RAISE NOTICE 'new trigger fired';再观察服务器日志,通常比绕到业务表里查结果更快定位是否已经走到新路径。尤其在联动逻辑复杂、触发表不直接存结果时,这个办法很省时间。
真正难的不是语法,而是“旧触发器有没有还在执行”
触发器替换最棘手的地方,往往不在 DDL 本身,而在运行时状态判断。比如某个触发器被嵌套在另一个存储过程中,而那个过程已经跑了十几秒;这时你即使完成了替换,旧逻辑也可能还在内存里继续执行。
所以,稳妥做法通常不是一次性强切,而是按风险分层处理:先灰度,再切全量,最后清理残留逻辑。对于关键链路,这比单纯追求“语法上能成功执行”更重要。















