RAGFlow部署启动失败怎么办?常见依赖冲突与报错排查
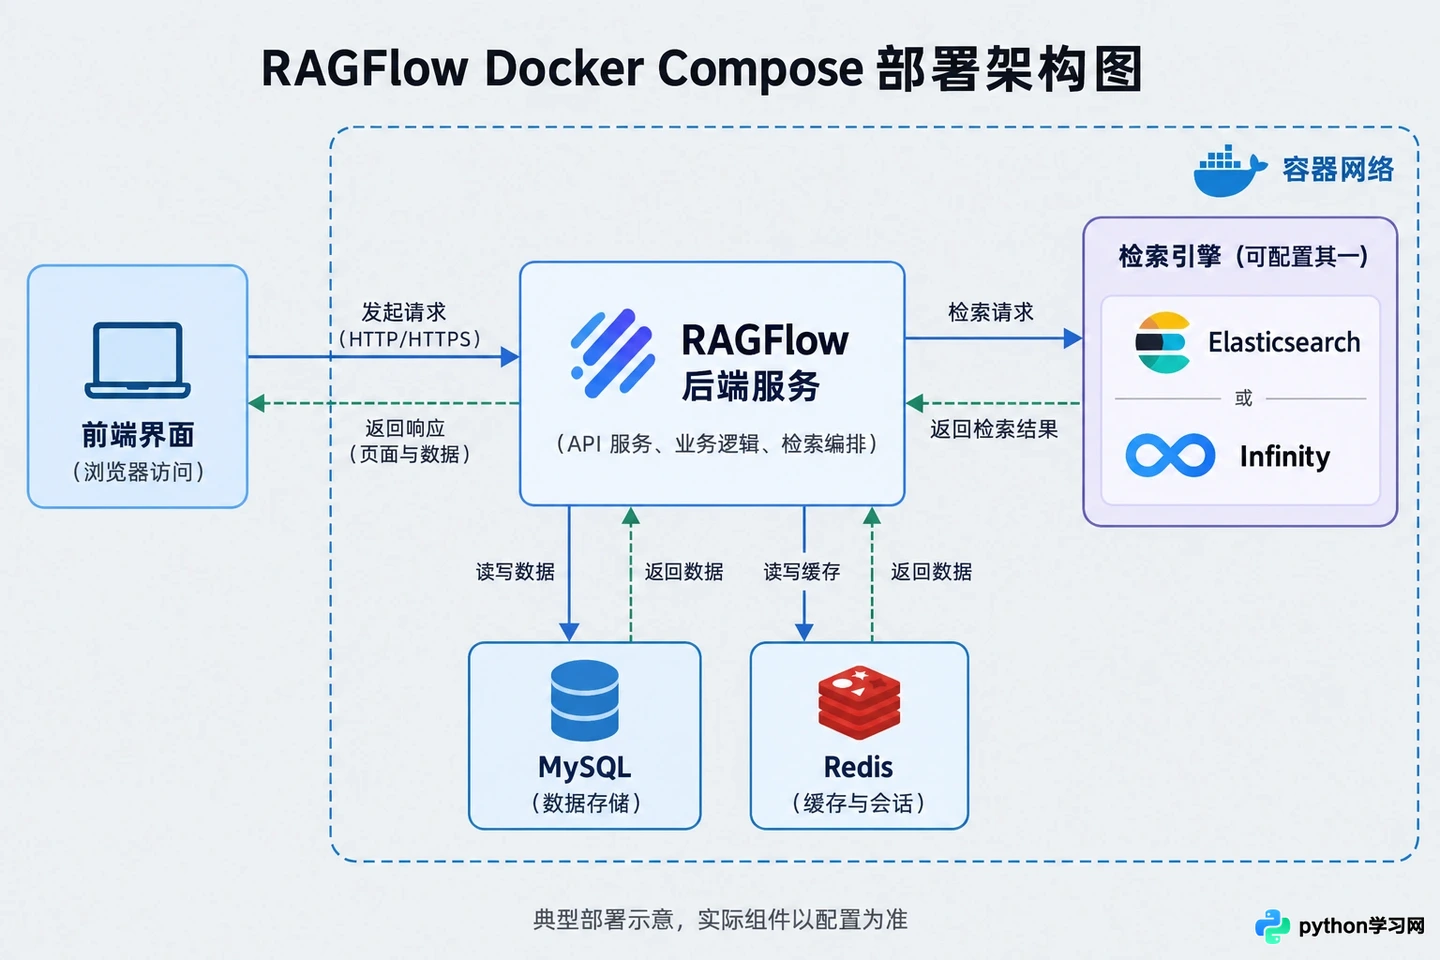
本文针对RAGFlow在Docker环境部署时常见的启动失败问题,提供基于日志分析的排查思路。重点解析端口占用、环境变量缺失、数据库连接超时及依赖版本冲突等典型错误,帮助开发者快速定位并解决启动障碍。
10-20
45




本文针对RAGFlow在Docker环境部署时常见的启动失败问题,提供基于日志分析的排查思路。重点解析端口占用、环境变量缺失、数据库连接超时及依赖版本冲突等典型错误,帮助开发者快速定位并解决启动障碍。
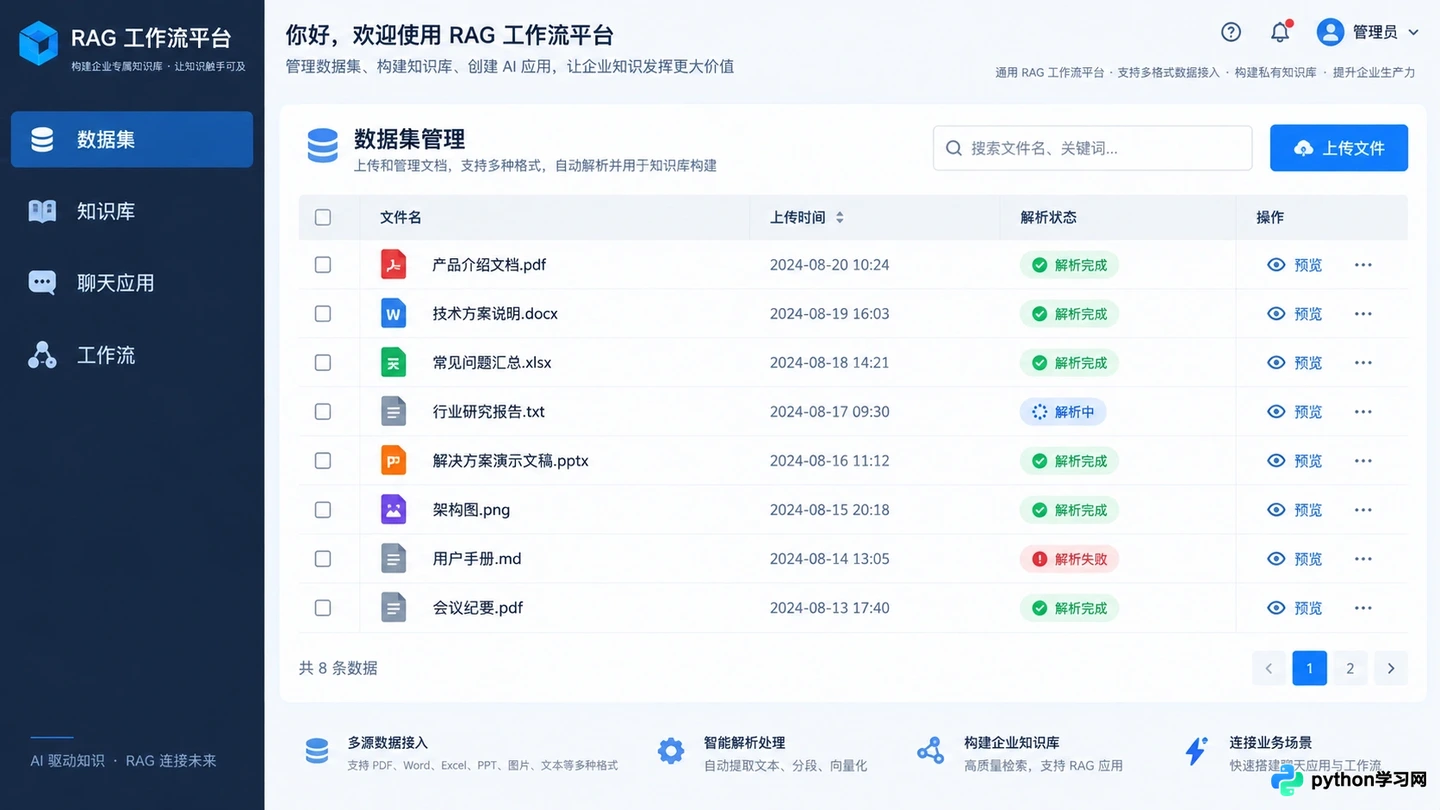
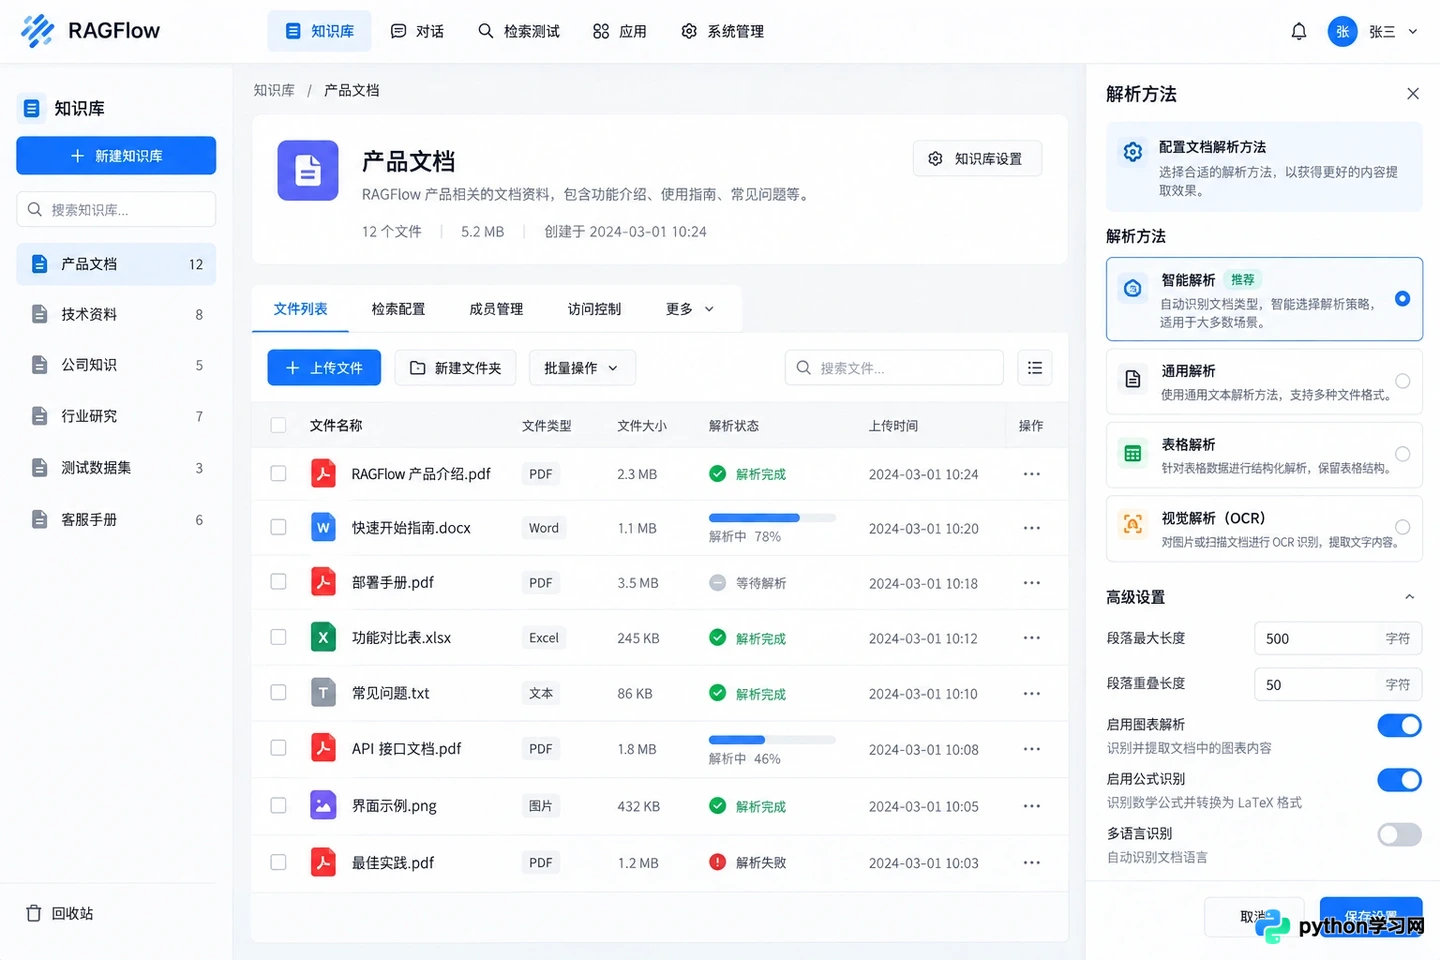
本文介绍RAGFlow的核心概念,重点解析其基于深度学习的文档处理能力与可视化编排工作流,帮助用户理解其在复杂非结构化数据场景下的应用价值。
本文深入解析如何利用RAGFlow的可视化工作流编排功能,解决传统RAG系统在复杂文档处理和多路召回中的痛点。通过拆解数据解析、混合检索与重排序等关键节点,展示如何构建高精度、可解释的企业级知识库,避免盲目堆砌参数,实现从“能搜到”到“搜得准”的体验跃升。
本文介绍如何在RAGFlow中通过调整文档切片策略和重排序参数来提升检索准确率。重点解析智能切片、父子索引以及重排序模型的选择与阈值设置,帮助用户优化问答效果。
本文基于官方推荐方式,详解如何通过Docker Compose在本地或服务器环境中部署RAGFlow。涵盖环境检查、配置文件修改、服务启动及初始化登录等关键步骤,帮助用户快速搭建私有化知识库问答系统。
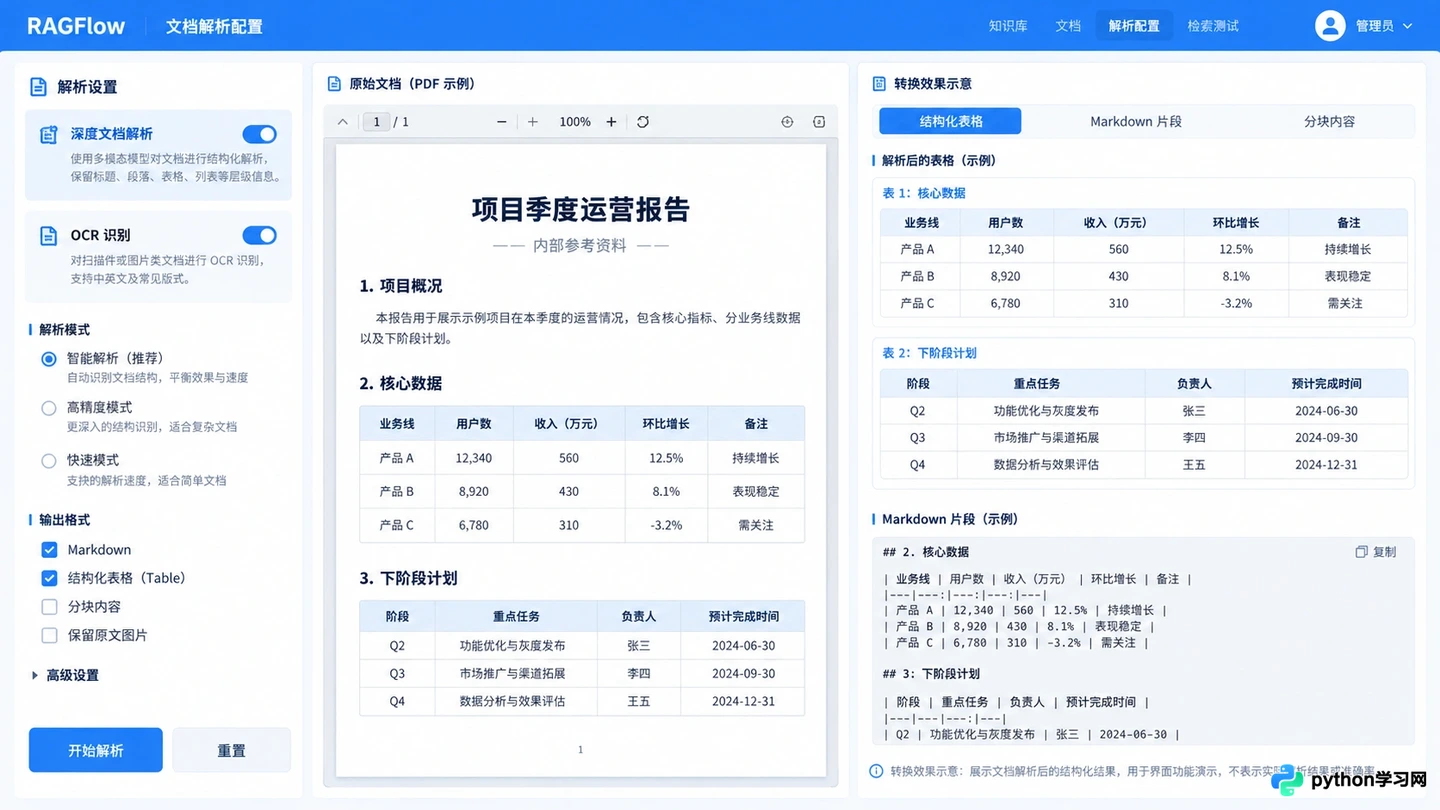
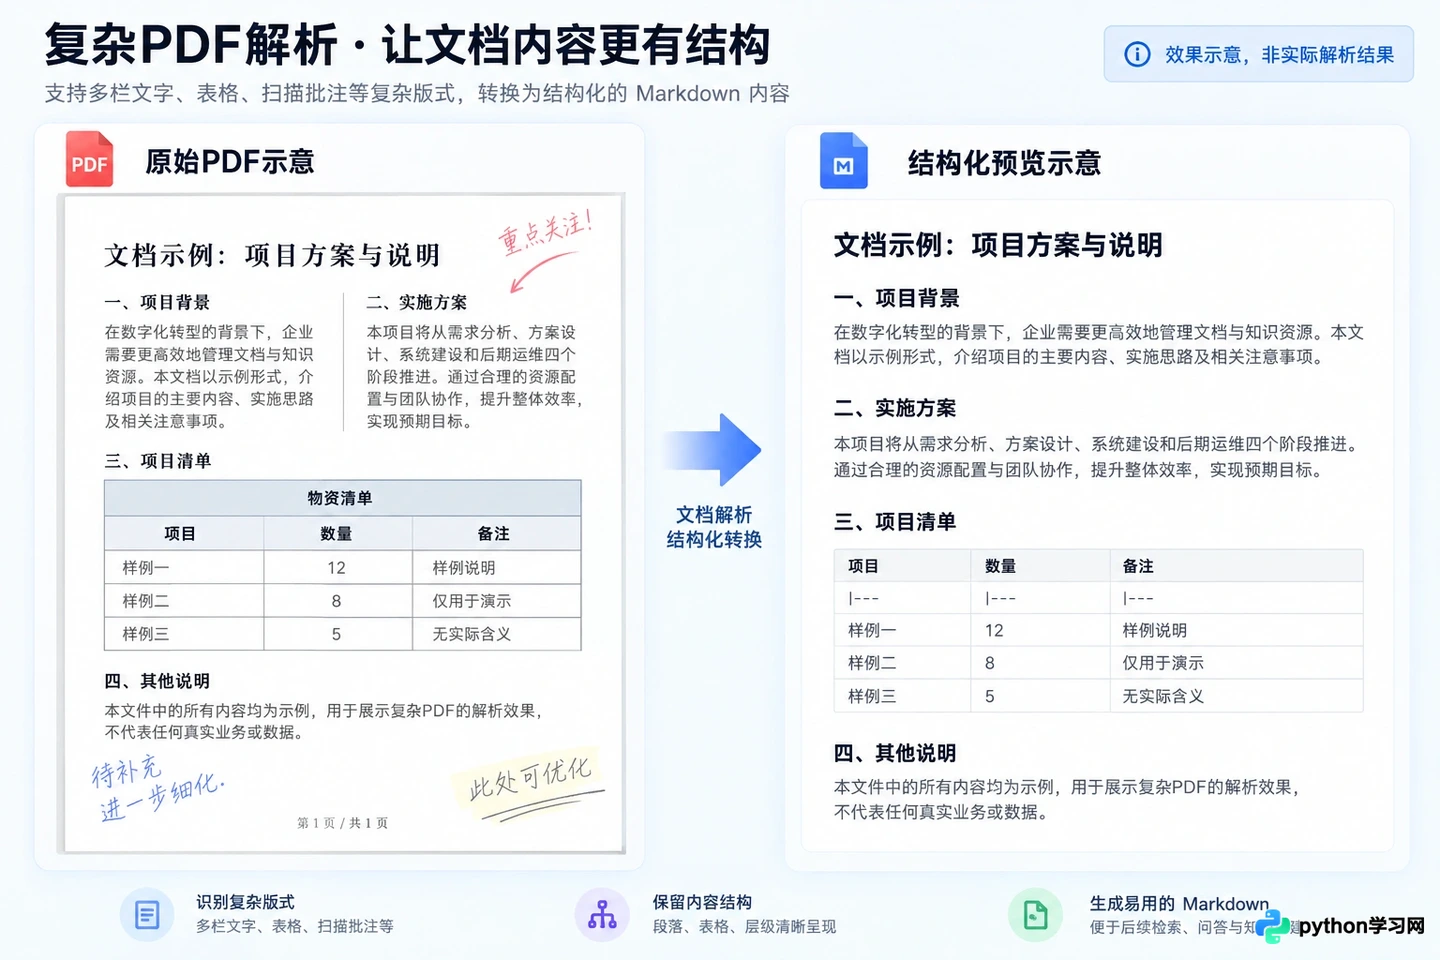
本文详解RAGFlow如何通过深度文档理解模型处理PDF中的复杂表格和扫描件。通过配置视觉模型与OCR引擎,实现从图片到结构化数据的精准提取,解决传统RAG工具在非结构化文档解析上的痛点,提升知识库检索准确率。
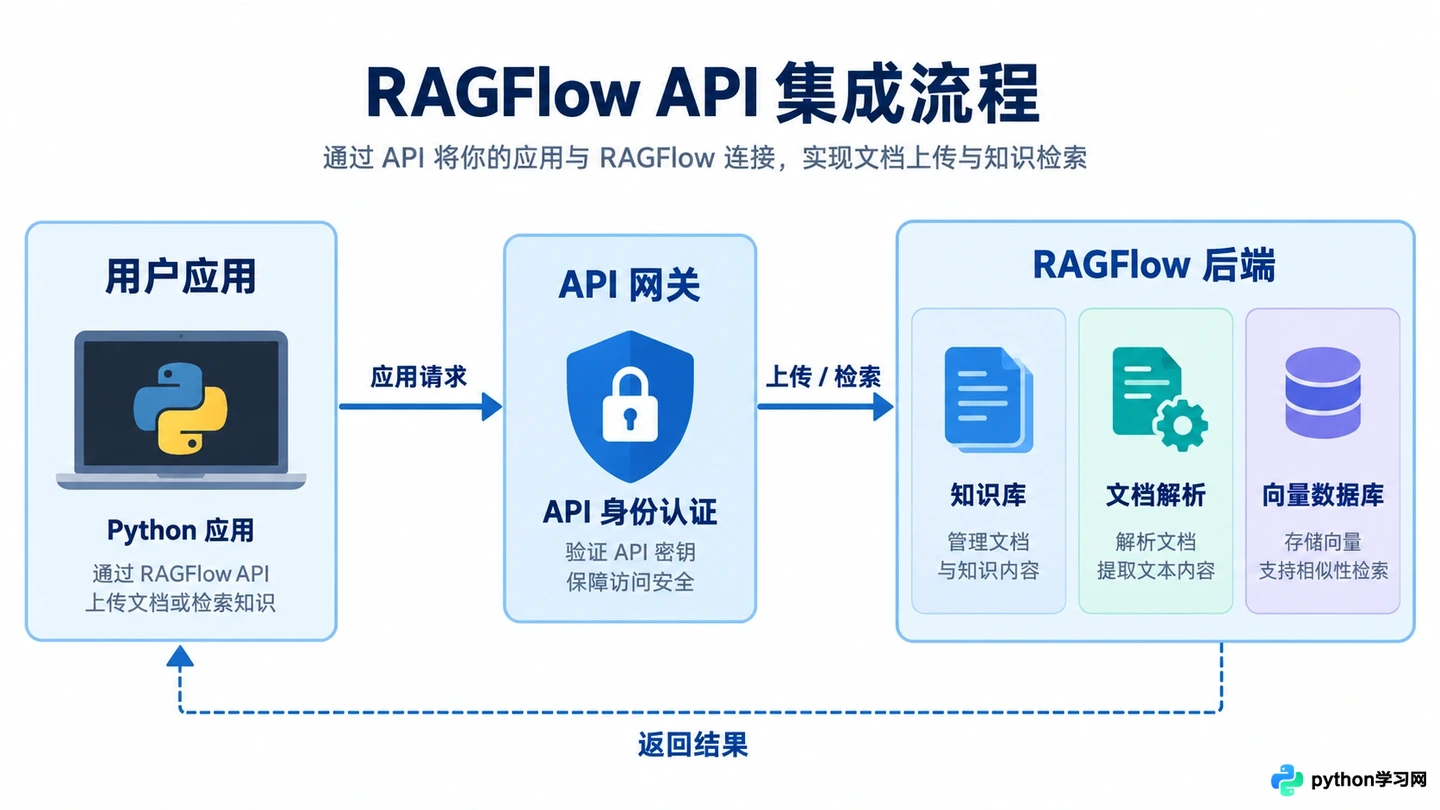
本文介绍如何通过 RAGFlow API 将知识库检索能力集成到业务系统中。涵盖获取 API Key、创建数据集、上传文档、解析配置及执行检索问答的完整流程,帮助开发者快速实现基于私有数据的智能问答功能。
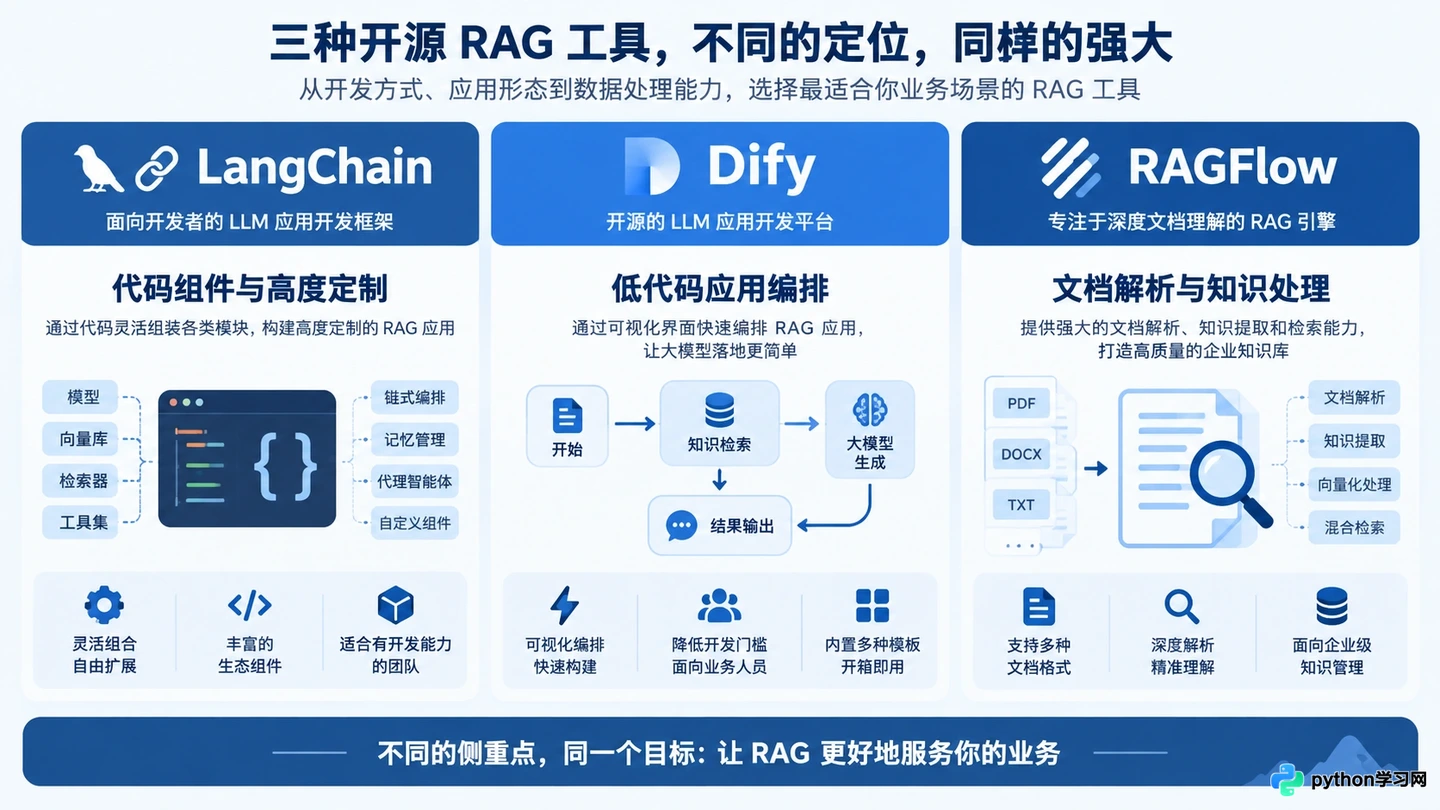
本文从架构定位、数据处理能力、开发门槛和适用场景四个维度,深度对比RAGFlow、Dify和LangChain。帮助开发者根据项目需求(是重文档解析、重应用编排还是重代码控制)选择最合适的RAG基础设施。