
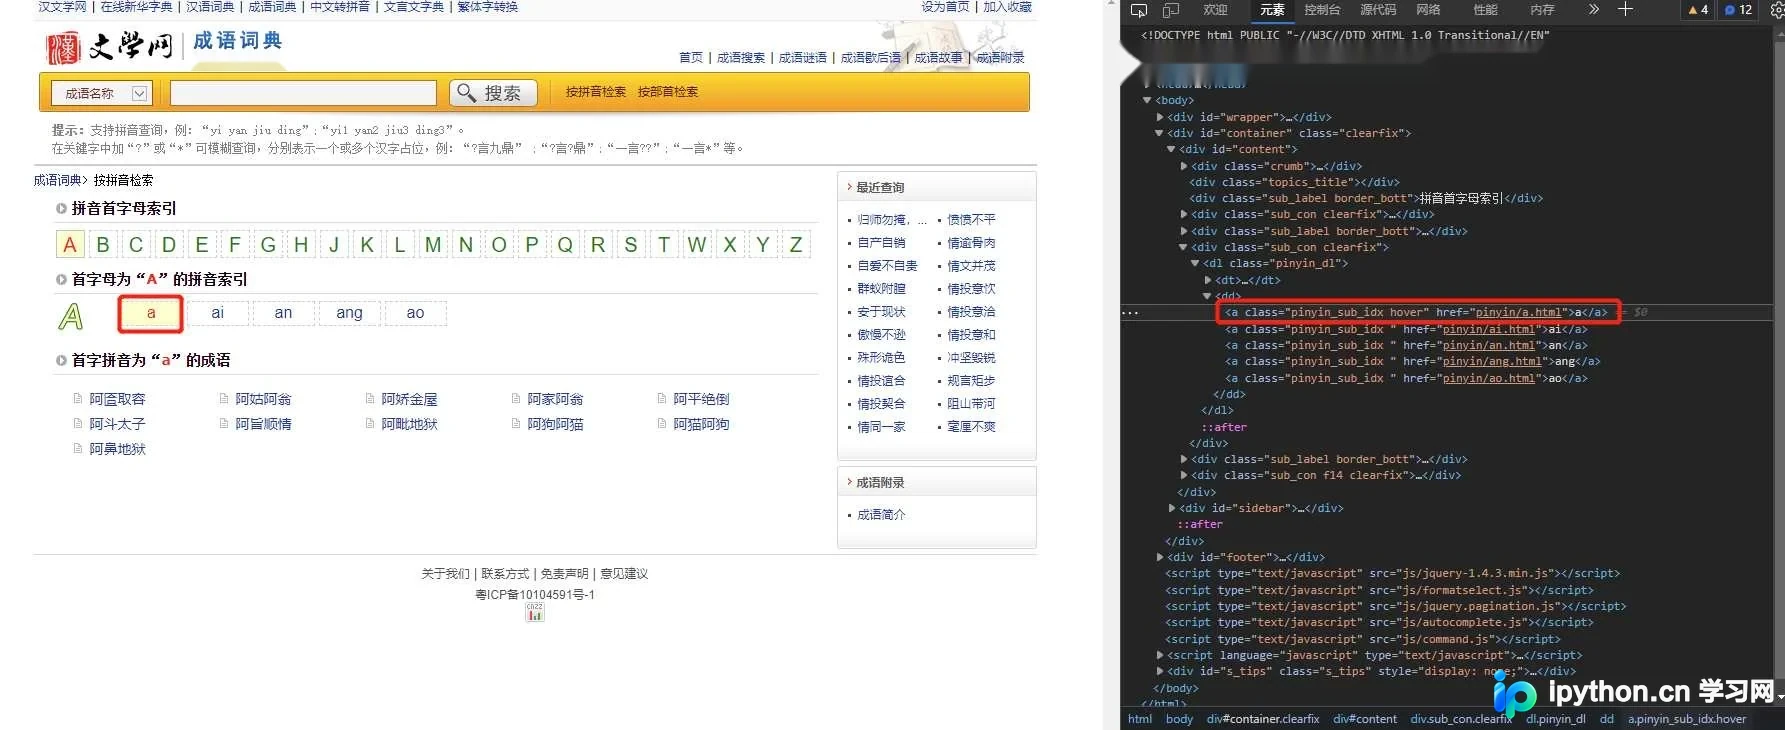
基于Python实现西西成语接龙小助手
本文介绍如何使用Python开发一个成语接龙小助手。通过爬虫模块获取包含拼音、释义等详细属性的成语数据,并利用前缀树(Trie Tree)构建高效搜索提示功能。程序支持简单与困难两种模式,提供逐步提示、成语详情查看及错误处理,适合Python初学者学习爬虫与数据结构应用。



本文介绍如何使用Python开发一个成语接龙小助手。通过爬虫模块获取包含拼音、释义等详细属性的成语数据,并利用前缀树(Trie Tree)构建高效搜索提示功能。程序支持简单与困难两种模式,提供逐步提示、成语详情查看及错误处理,适合Python初学者学习爬虫与数据结构应用。
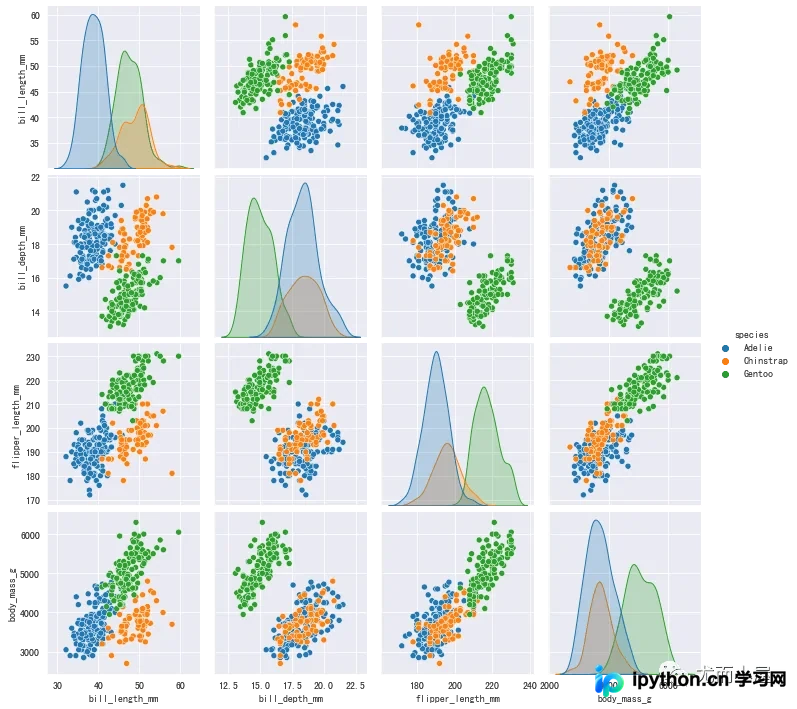
本文详细解析Seaborn库中pairplot函数的核心参数与用法。通过导入默认数据集,演示了kind、hue、diag_kind、palette等关键参数的配置方法,涵盖散点、KDE、直方图及回归等多种图形类型。文章提供了关于颜色控制、标记样式、尺寸调整、变量筛选及缺失值处理的完整代码示例,帮助用户快速掌握绘制高质量双变量关系图的技术。
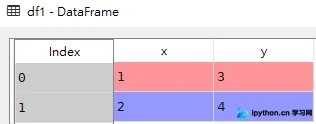
本文详细介绍Pandas中pd.concat函数的用法,涵盖纵向与横向数据连接、关键参数如axis和join的配置,以及处理Series与DataFrame混合连接的示例。通过具体代码演示如何高效合并数据集,适用于数据清洗与分析场景。
本文深入解析 NumPy 数组与 Python 内置列表在计算标准差时的核心区别。通过对比底层数据结构、运算机制及实际计时结果,展示 NumPy 基于 C 语言实现的矢量化操作如何显著提升计算效率。文章包含具体代码示例与性能测试数据,帮助开发者理解为何在大规模数据处理中 NumPy 是更优选择。
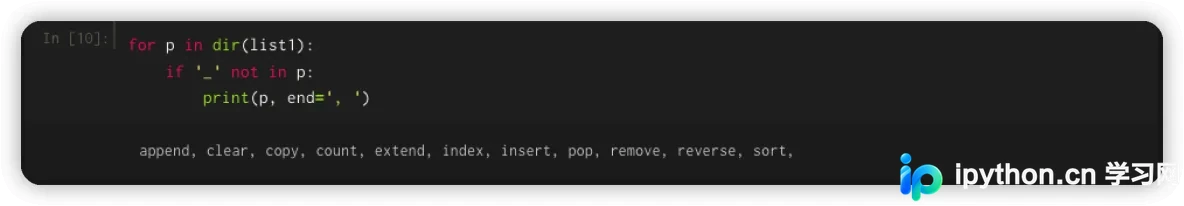
本文详细介绍如何利用Python实现报表自动化流程,涵盖从数据源读取、DataFrame计算、统计指标处理到图表生成的全过程。重点讲解使用Matplotlib和Echarts绘制可视化图表,并通过smtplib与email模块实现报表自动打包及发送至指定邮箱的功能,旨在提升数据分析效率并减少人工操作错误。
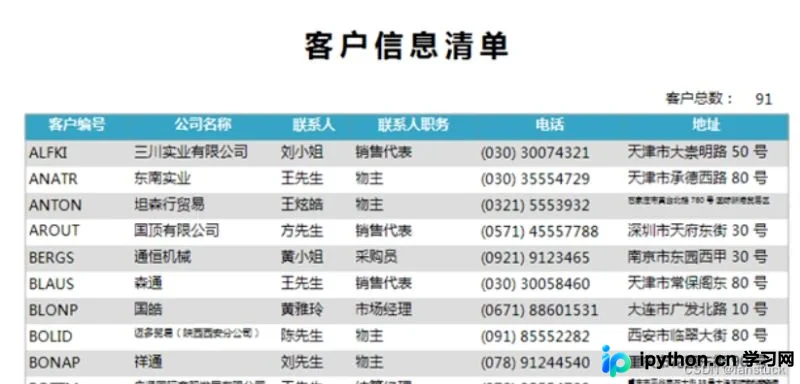
本文详细介绍如何使用Python及Pandas库从日期数据中提取30余种常用信息。涵盖年月日时分秒、星期、周次、季度、闰年判断、时间间隔计算及字符串时段转换等核心功能,通过具体代码示例展示read_excel、dt模块、apply、lambda及getattr等方法的实际应用,助力数据竞赛与日常开发。
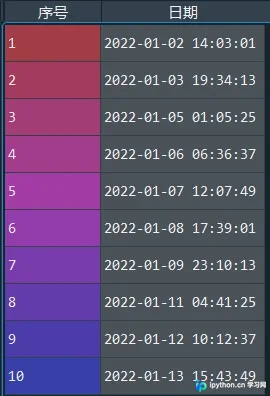
本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
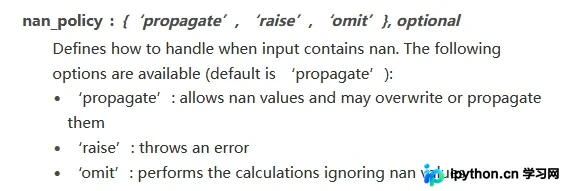
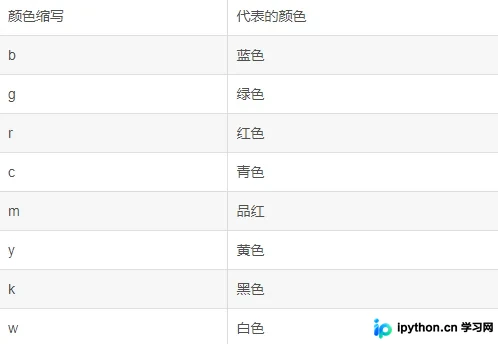
本文详细介绍使用Python Matplotlib库绘制十一种常见数据分析图表的方法,涵盖折线图、散点图、直方图、饼图、箱线图、概率图、雷达图、流向图、极坐标图、词云图及表格嵌入。通过具体代码示例与参数说明,帮助开发者快速掌握各类图表的绘制技巧与核心配置。
本文介绍在Python3中使用Requests库处理HTTP 301或302重定向时,如何获取跳转后的真实URL。通过解析Response Header中的Location字段,或利用Requests默认自动跳转特性访问response.url,可分别实现手动提取与自动获取两种方案。

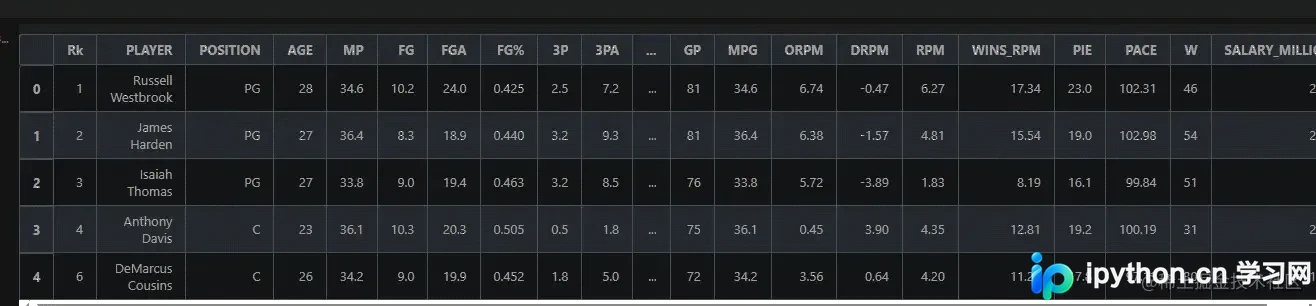
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。
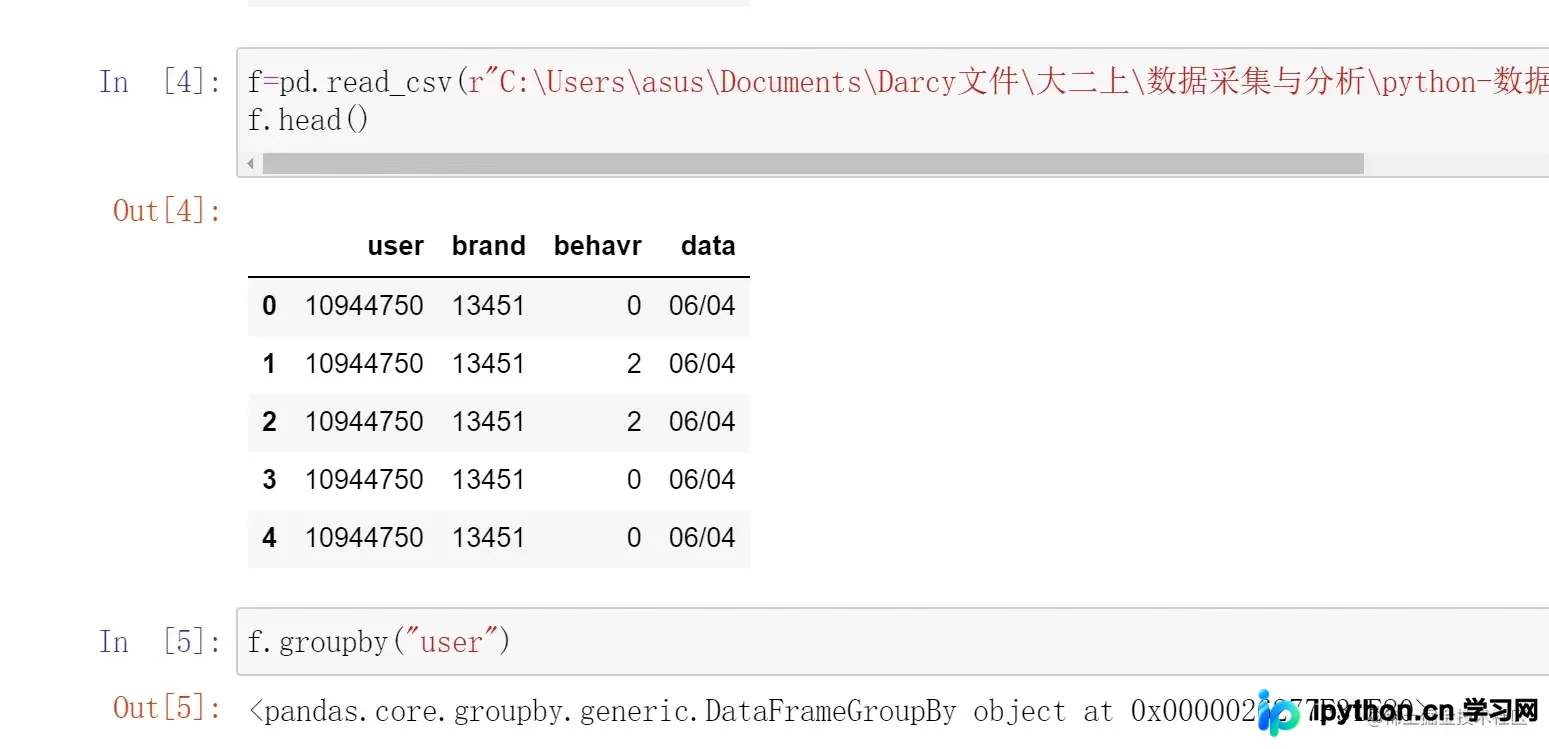
本文详解Pandas中groupby函数的核心用法,通过电商行为数据实例,演示如何按用户或商品分组统计浏览量与购买量。重点讲解利用Series除法计算商品转化率、处理缺失值(NaN)及排序提取Top N商品的方法,帮助读者快速掌握分组聚合技巧。
本文深入解析Python中字符串截取与切片的核心机制,涵盖正向与反向索引规则、切片语法[start:end:step]的具体用法及实例演示。同时提供两种自定义字符串截取函数的实现方案,分别适用于单次提取和批量提取特定标签间内容的场景,助力开发者高效处理XML、JSON等字符串数据。



