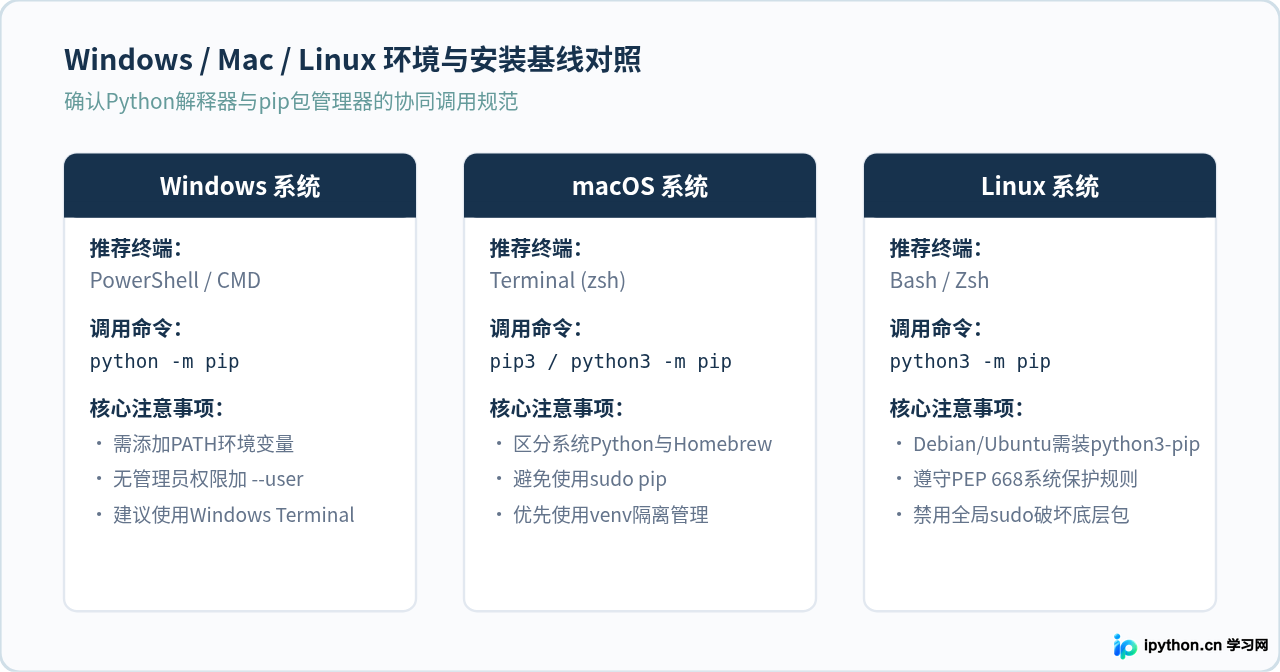
Windows/Mac/Linux下使用pip安装pandas库
本文详细介绍在Windows、macOS和Linux操作系统下使用pip安装pandas数据分析库的完整方法,涵盖环境检查、虚拟环境隔离、镜像源加速与常见报错排查。



本文详细介绍在Windows、macOS和Linux操作系统下使用pip安装pandas数据分析库的完整方法,涵盖环境检查、虚拟环境隔离、镜像源加速与常见报错排查。
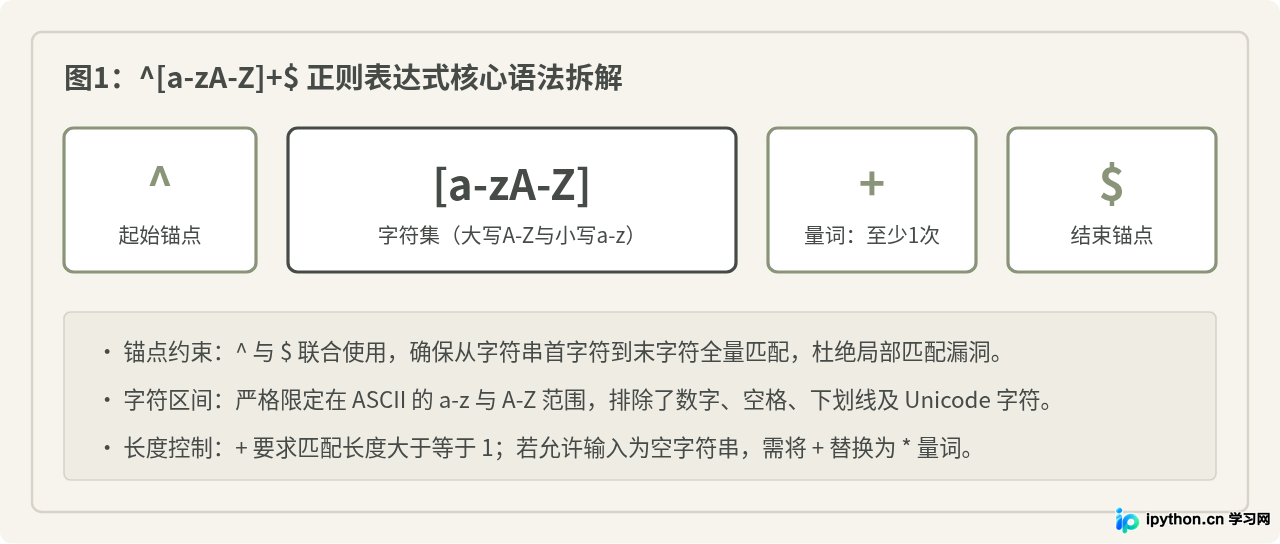
本文介绍在Python中使用正则表达式精确匹配纯字母输入的实现方法,深入剖析正则表达式语法结构、re模块核心函数应用流程及常见误区避坑指南。
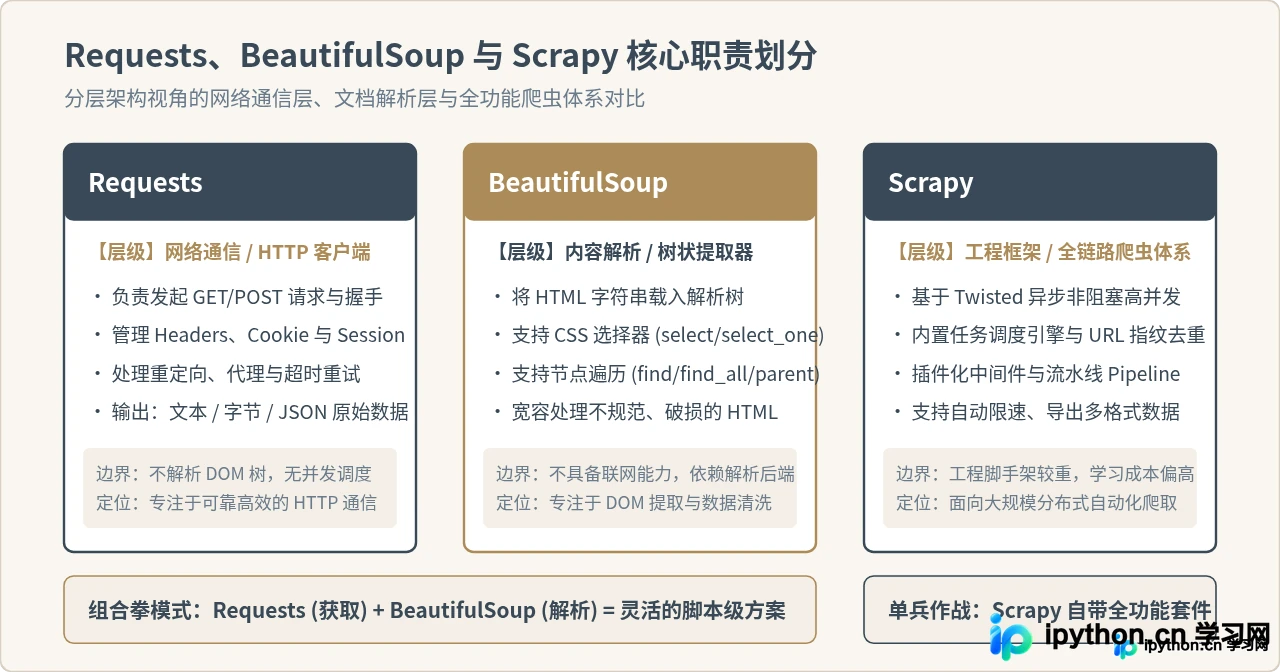
深入对比 Python 爬虫三大主流工具 Requests、BeautifulSoup 与 Scrapy 的定位差异、工作原理与适用场景,提供选型决策树与实践代码。
深入解答小型Python脚本是否需要遵循软件设计原则,权衡一次性抛弃型与演进型脚本的维护成本,提供KISS、YAGNI与SRP原则的轻量落地方法与重构示例。
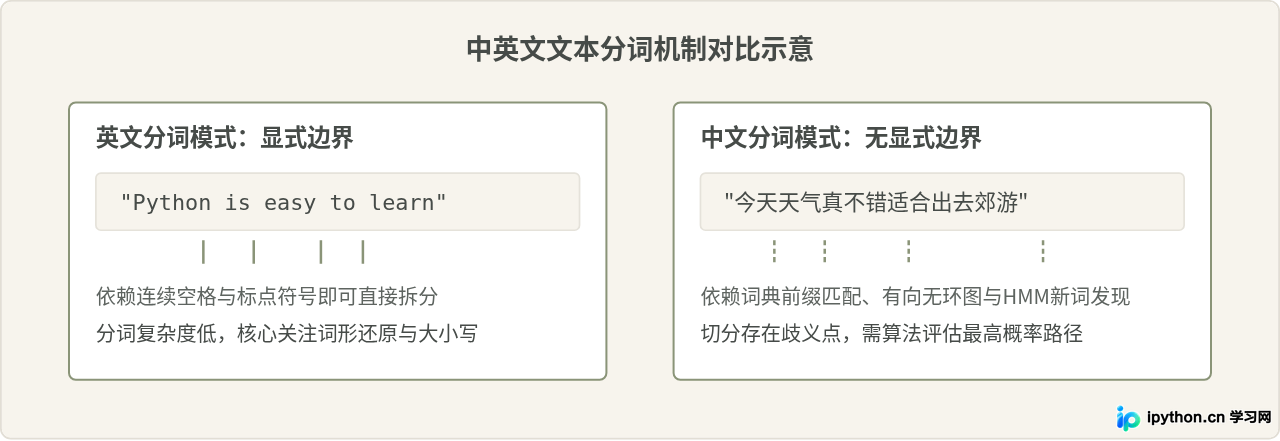
本文详细介绍如何使用Python进行中文文本数据分析,重点讲解中文分词原理、jieba库核心用法、停用词清洗以及基于collections.Counter的高频词统计实战。
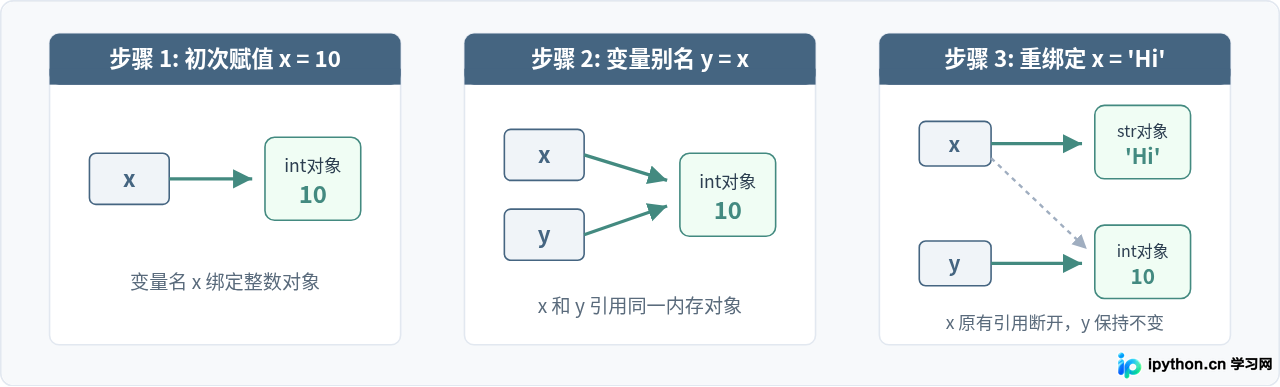
深入详解Python核心基础语法,涵盖变量声明与内存模型、常见基础与容器数据类型特性,以及条件分支与循环控制流结构的实际应用与避坑指南。
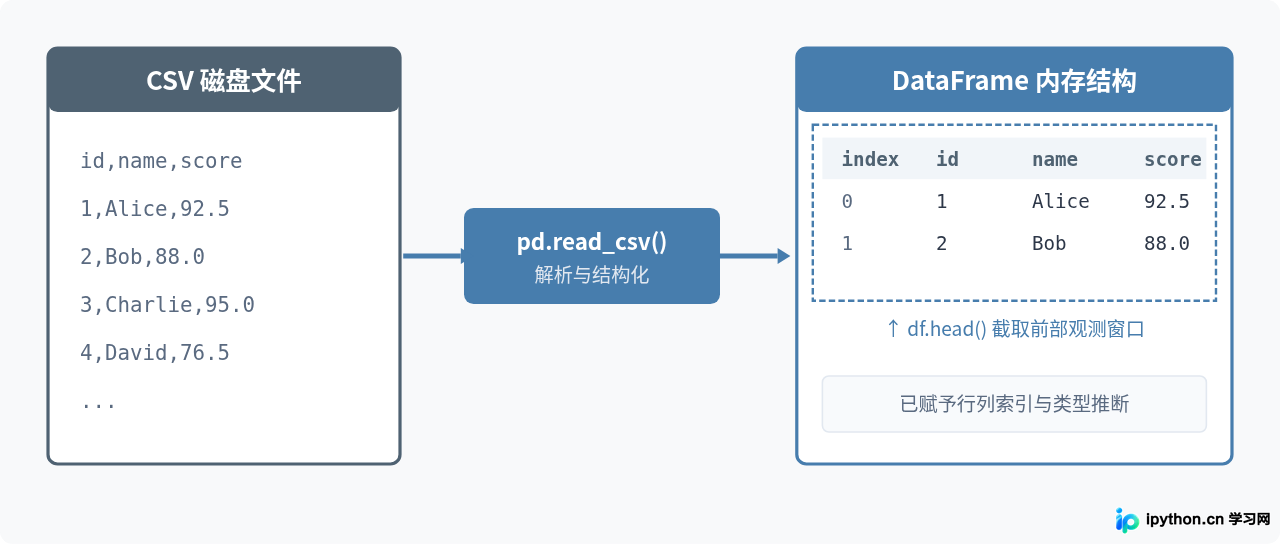
本文详细讲解如何使用Python的pandas库通过read_csv函数读取CSV文件,并使用head()方法高效查看前几行数据,涵盖标准操作流程、参数调整与常见排查方法。
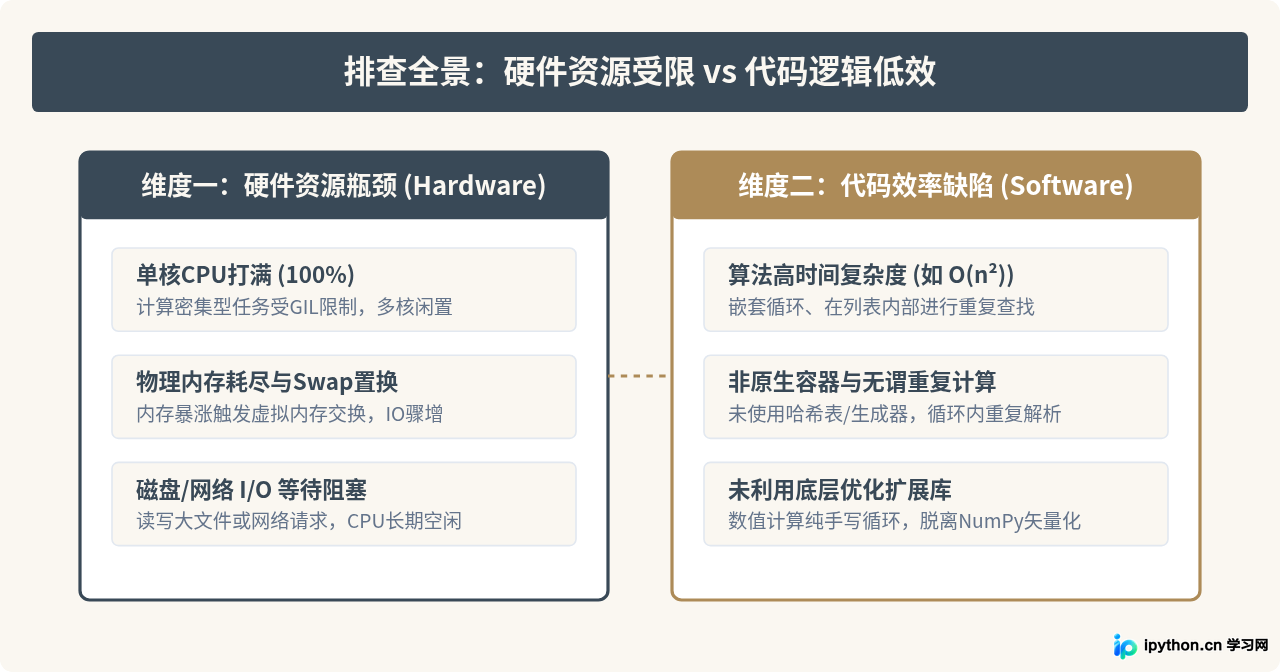
深入排查Python程序运行缓慢的真实原因,区分硬件资源限制与代码执行效率问题,提供系统化排查流程与优化方案。
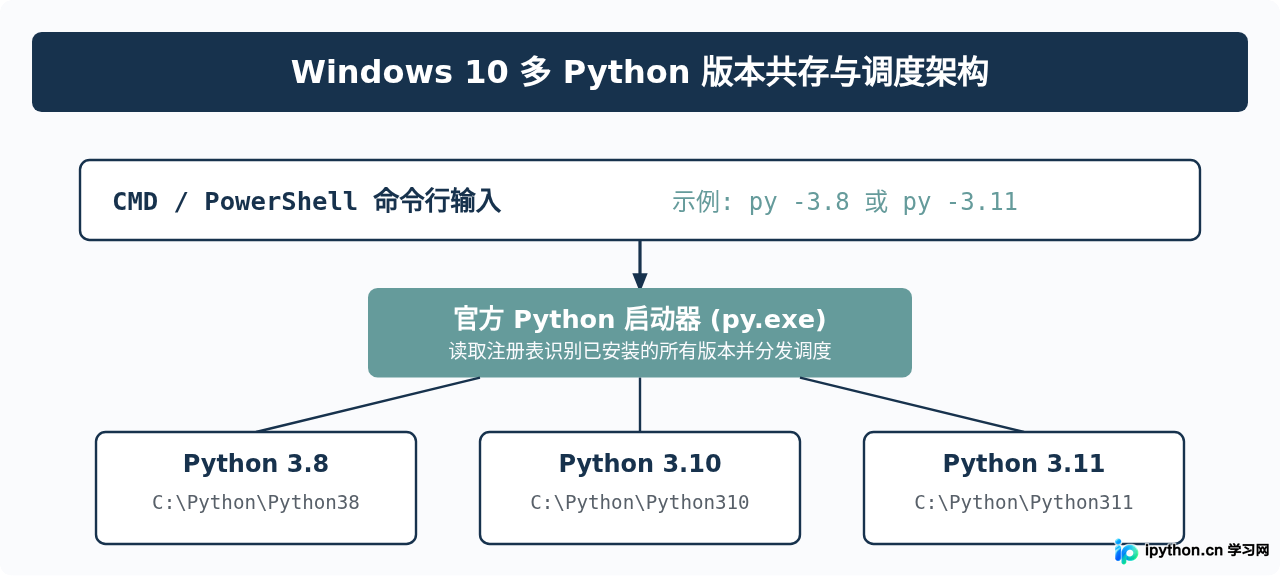
在Windows 10系统中同时安装多个Python版本并自由切换使用的详细教程。讲解自定义安装路径、避免PATH冲突、使用官方py启动器自由切换运行,以及为不同项目创建隔离的虚拟环境。
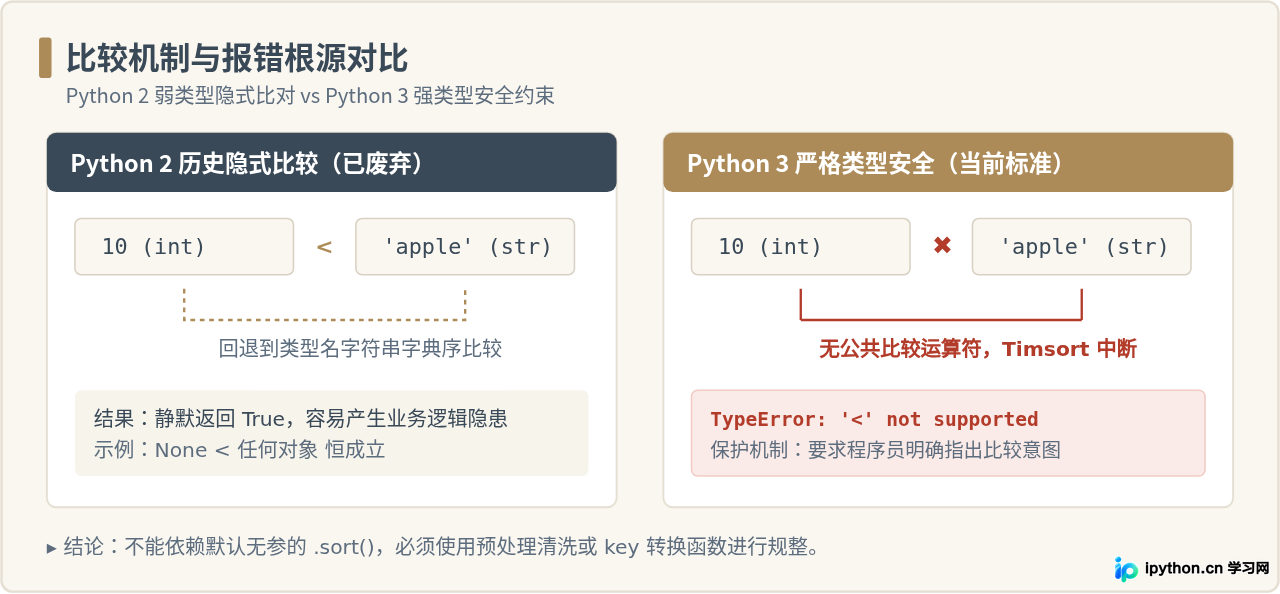
深入解析Python列表排序时抛出TypeError的原因,提供针对字符串与数字混合、包含None值等常见场景的完整解决方案与自定义key排序技巧。
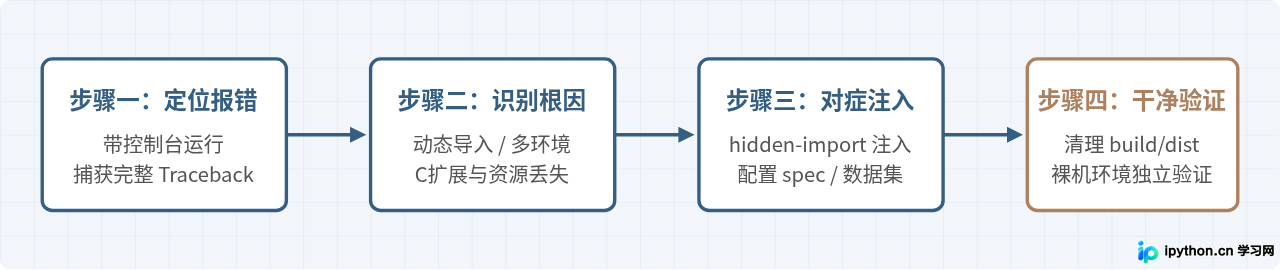
针对Python使用PyInstaller等工具打包为exe可执行文件后,运行提示ModuleNotFoundError或ImportError缺少模块的问题,提供通用的系统化排查路径与有效修复方法。
详细解析 Python f-string(格式化字符串字面值)的核心机制、基础语法、表达式求值、常用格式化控制符(精度、对齐、千分位、百分比、日期)以及调试技巧与避坑指南。