Python查重库对比:fuzzywuzzy、sklearn与textdistance评测
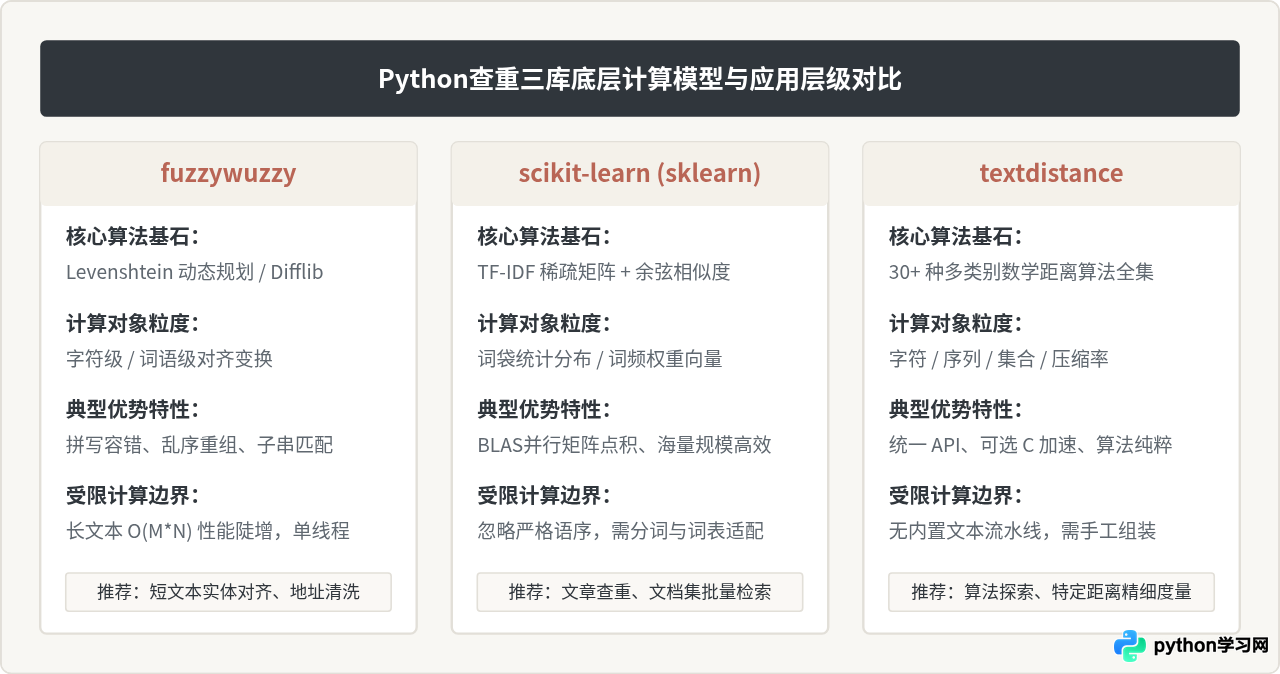
深入对比评测Python主流文本查重与相似度计算库:fuzzywuzzy、scikit-learn与textdistance。从算法原理、代码示例、计算开销到实际工程选型,帮助开发者针对短文本对齐、长文档查重与海量数据比对做出合理技术决策。



深入对比评测Python主流文本查重与相似度计算库:fuzzywuzzy、scikit-learn与textdistance。从算法原理、代码示例、计算开销到实际工程选型,帮助开发者针对短文本对齐、长文档查重与海量数据比对做出合理技术决策。
本文详细介绍如何使用Python的Gensim和Jieba库进行文本相似度分析。通过中文分词、构建词袋模型、计算TF-IDF值及稀疏矩阵相似度,实现测试文档与目标文档的匹配度计算。文章包含完整代码示例及结果解读,适合初学者掌握NLP基础流程。
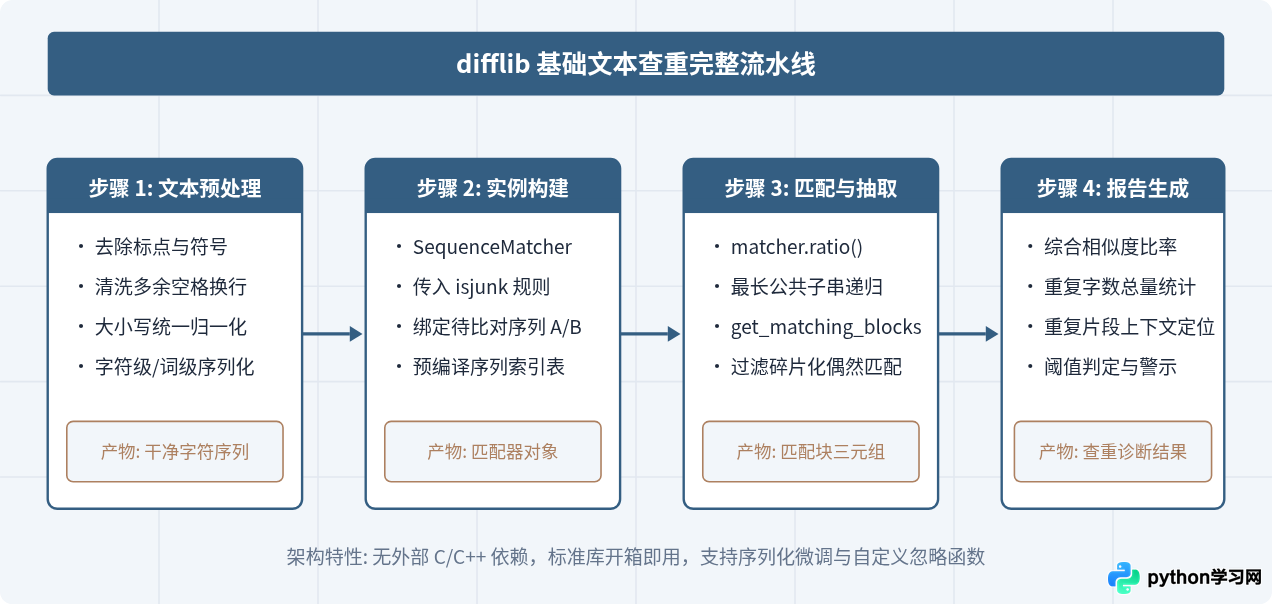
本教程详细讲解如何使用Python内置标准库difflib实现基础文本查重。涵盖SequenceMatcher核心原理、相似度比率计算、重复文本片段精确定位、文本清洗预处理以及长文本性能优化方案。
本文介绍在 Python 中处理不定长序列匹配时,使用 difflib 和 Levenshtein 库进行文本相似性比较的方法。difflib 支持非字符串元素但要求完全匹配,而 Levenshtein 需输入字符串并进行整体匹配。通过实例对比两者的优缺点,帮助开发者根据实际需求选择合适的相似度计算工具。
本教程详细介绍如何使用Python标准库difflib进行字符串模糊匹配,涵盖SequenceMatcher相似度计算原理、get_close_matches候选词检索、文本预处理技巧及性能适用边界。
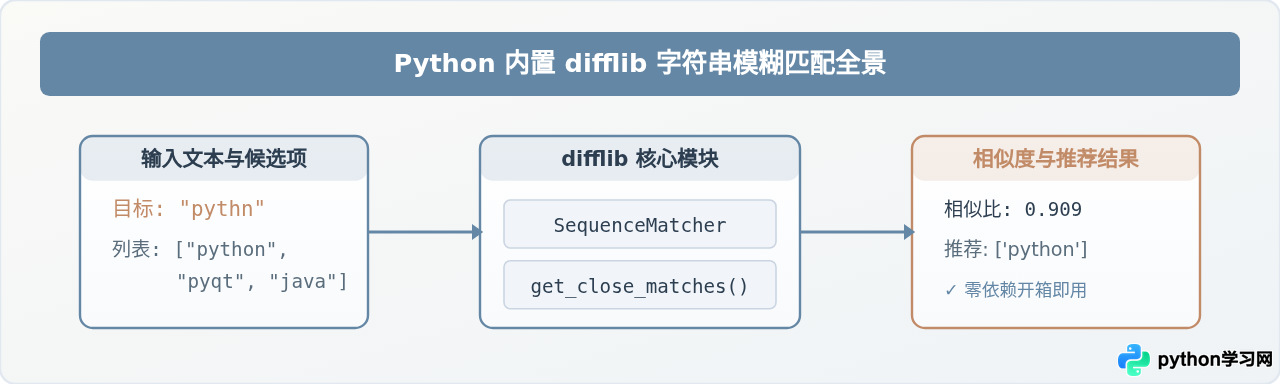
详细解析Python中实现模糊字符串匹配的两种核心工具:标准库difflib与第三方库fuzzywuzzy。深入剖析其计算原理、核心函数用法、典型场景对比以及中文文本与大数据量处理时的工程优化建议。
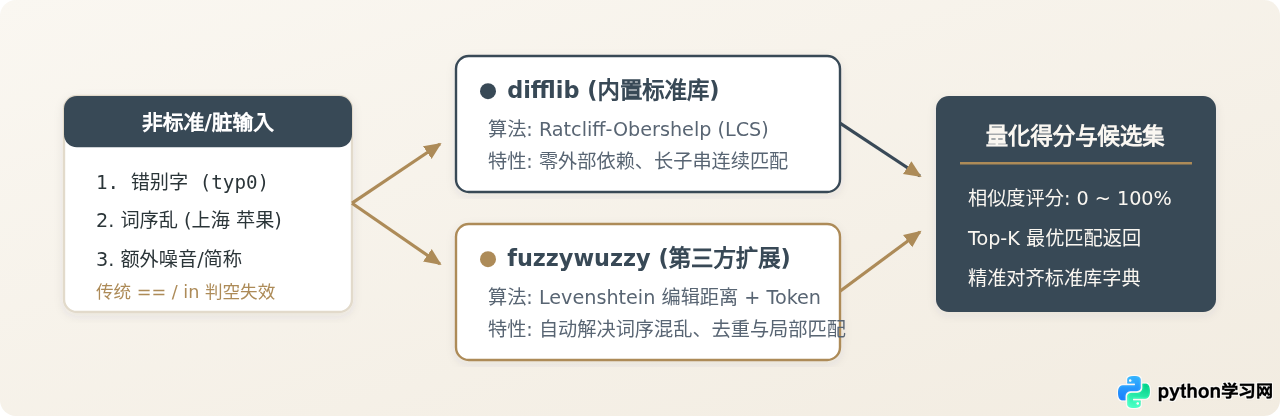
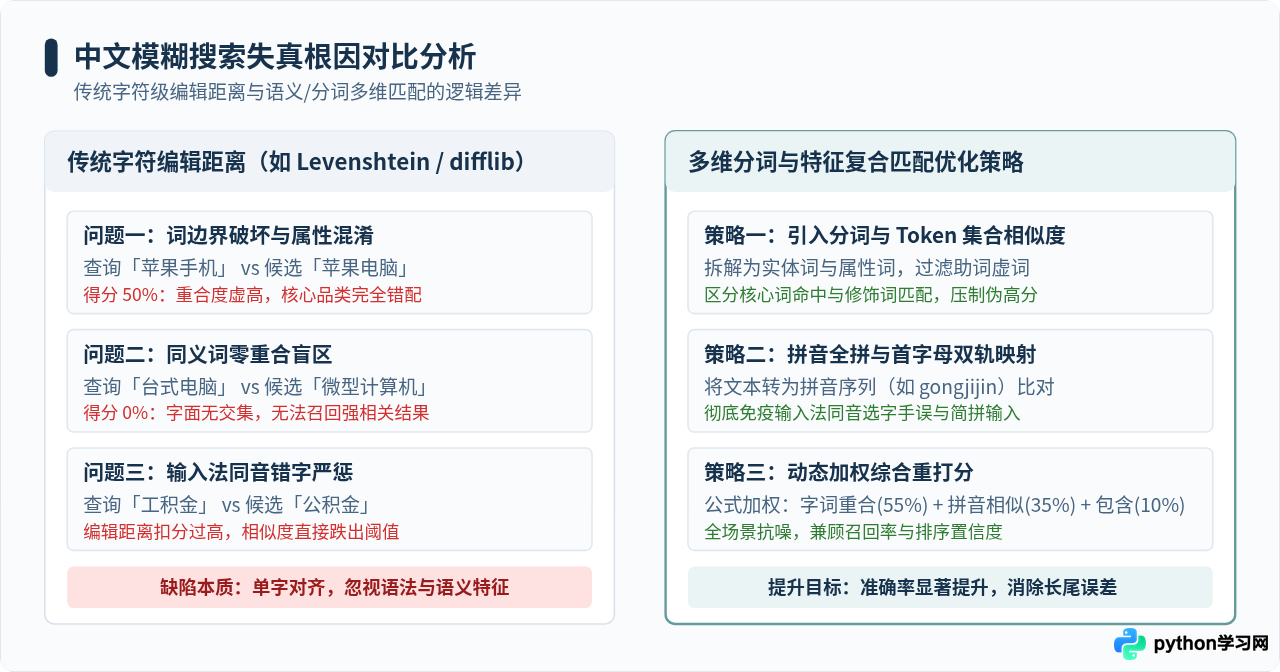
系统剖析在Python中直接使用字符级编辑距离导致中文模糊搜索准确率偏低的根因,提供结合Jieba分词、Pypinyin拼音转写、RapidFuzz多维加权打分及倒排粗筛的完整工程化解决路径与可执行代码。
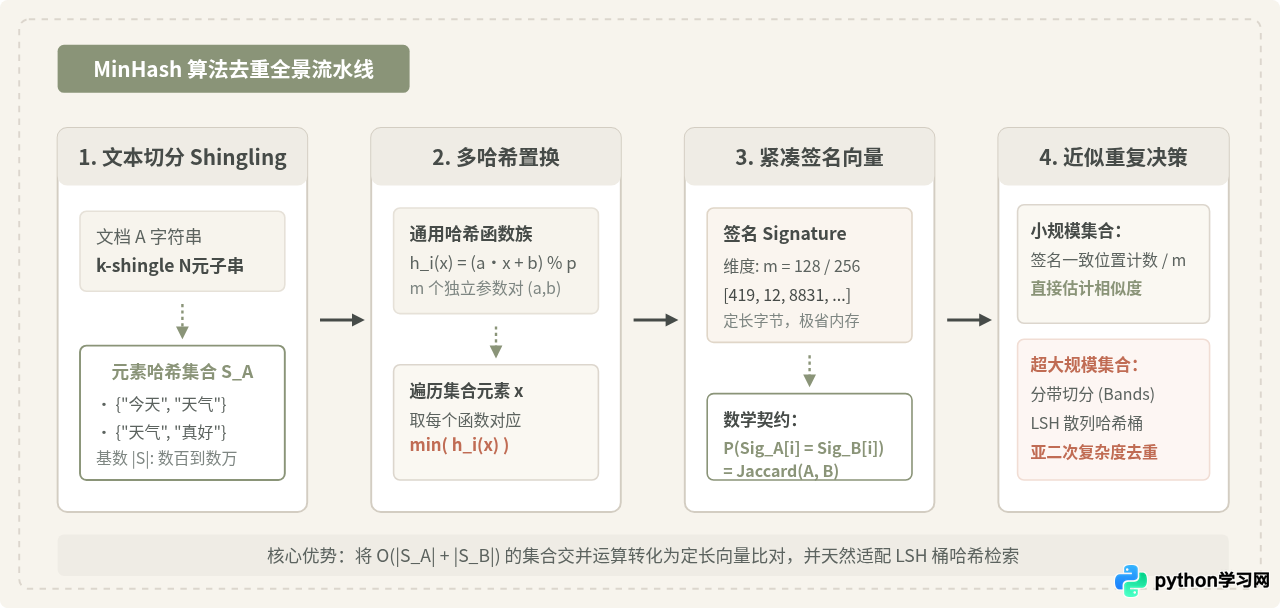
深入讲解如何使用Python从零实现MinHash(最小哈希)算法,用于海量文本近似重复检测。涵盖k-shingle集合构建、多项式随机哈希签名生成、Jaccard相似度无偏估计以及LSH分桶加速方案与完整代码。
本文介绍如何使用Python和SpaCy库,通过预处理标题、生成文本对并计算余弦相似度,递归地过滤掉内容相似的重复文档。该方法适用于归档清理、歌词去重等场景,能有效保留唯一性文档并释放存储空间。
本文详细介绍Python中Fuzzywuzzy模块的使用方法,涵盖fuzz和process两大核心模块。通过fuzz.ratio、partial_ratio、token_sort_ratio及token_set_ratio等函数实现字符串相似度计算,并利用process.extract和extractOne从候选集中快速检索最相似文本,附带完整代码示例与参数说明。
本文详解Python中similarity函数的实现原理,利用列表推导式获取两个列表的公共元素。同时探讨句子语义相似度计算需求,推荐Gensim等库进行文本处理,并对比不同算法在自然语言处理中的应用场景。
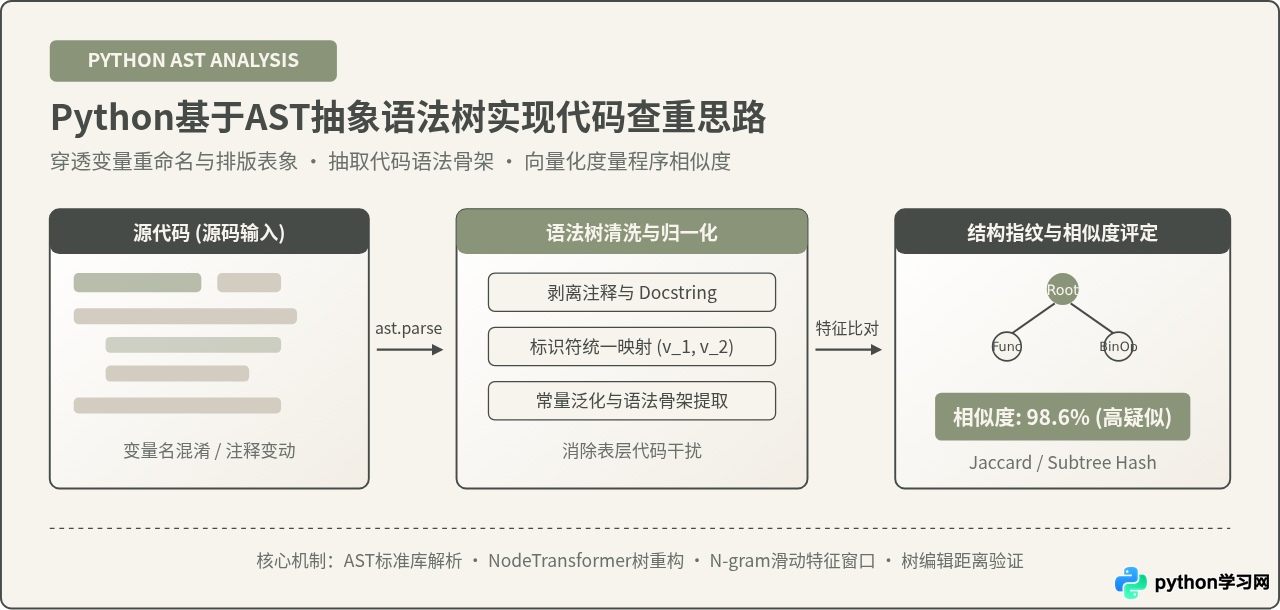
详细讲解如何利用Python内置的ast模块实现代码查重。从文本匹配的缺陷讲起,深入阐明AST语法树解析、树节点清洗与归一化、特征提取及相似度计算的完整思路与工程落地实现。