



很多团队以为“用了 ORM 就不会有 SQL 注入”,但 Sequelize 只会帮你绑定数据值,不会替你兜住列名、表名、排序字段这些 SQL 结构位。判断是否安全,关键不在于有没有用 Sequelize,而在于用户输入最终落到了“值”里,还是直接变成了 SQL 结构的一部分。本文按最常见的四类场景拆开说明,帮助你快速判断哪些写法可以直接用,哪些地方必须加白名单或改写。
模型方法默认安全,但只限“值位”
在日常开发里,Model.findAll()、Model.findOne()、Model.update()、Model.destroy() 这类标准模型方法,本身就会把条件值作为参数绑定处理。只要用户输入出现在 where、attributes 的值部分、limit、offset 这些“数据位置”,通常不需要额外写 replacements 或手动转义。
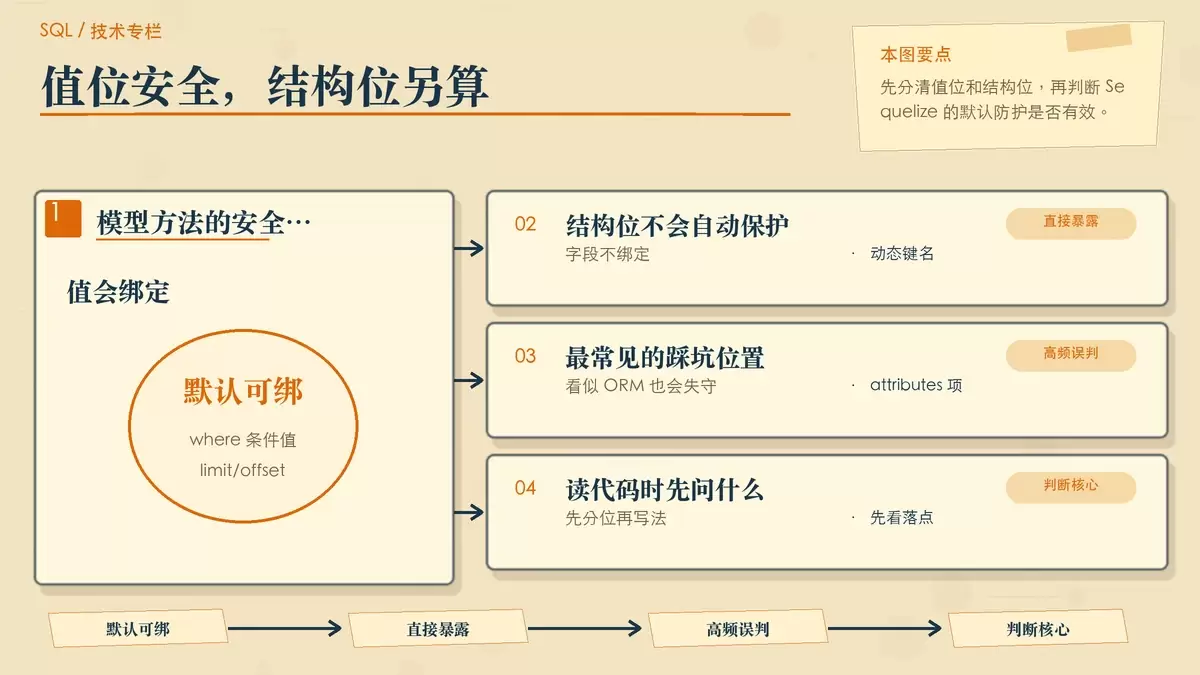
问题在于,很多注入风险并不是出在值,而是出在“结构位”。一旦把用户输入当成字段名、排序字段或属性名使用,ORM 的默认保护就不再生效。
where: { email: req.query.email }:安全,req.query.email会被当作绑定值处理。where: { [req.query.col]: 'value' }:危险,动态键名会让用户输入直接变成列名。attributes: ['id', req.query.include]:危险,数组里的用户输入会被当成列名插入查询。
下面这类写法尤其容易让人误判:
where: { [req.query.field]: req.query.value }
order: [[req.query.sortBy, 'DESC']]
前者的问题是 req.query.field 不再是普通数据,而是裸列名;后者的问题是排序字段本身无法参数化。也就是说,即便 req.query.value 是安全绑定的,只要 field 或 sortBy 可控,整条语句仍然可能被打穿。
实务上可以这样理解:模型方法默认安全,前提是用户输入只作为“值”存在;只要它开始参与 SQL 结构生成,就必须单独审查。
使用 sequelize.query() 时,必须显式写 replacements
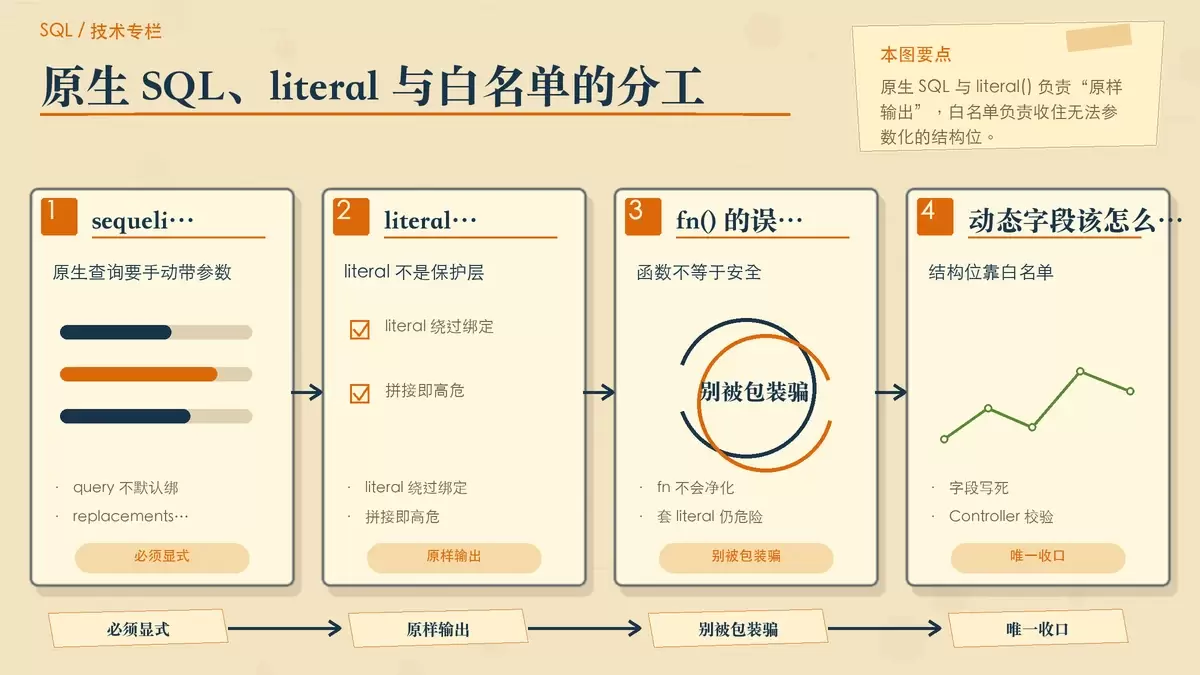
和模型方法不同,sequelize.query() 不会替你自动完成参数化。只要把用户输入直接拼进 SQL 字符串,风险就已经成立。
例如下面这种写法,本质上就是字符串拼接:
sequelize.query(`SELECT * FROM users WHERE id = ${req.query.id}`)正确方式是使用 replacements,并且只把用户输入放进占位符对应的位置。Sequelize 支持数组和对象两种形式:
sequelize.query('SELECT * FROM users WHERE status = ?', {
  replacements: ['active']
})
sequelize.query('SELECT * FROM users WHERE id IN (:ids)', {
replacements: { ids: [1, 2, 3] }
})replacements 的边界也要看清:它只能替换“值”,不能替换表名、列名、函数名这类结构内容。因此下面这种写法即使看起来用了参数机制,也依然不安全:
`SELECT * FROM ${req.query.table}`原因很简单,${req.query.table} 所在的位置根本不是参数位,数据库不会把它当作绑定值处理。换句话说,sequelize.query() 能不能安全,不取决于你有没有用这个 API,而取决于你是否把所有外部输入都放进了真正可绑定的位置。
`literal()` 和 `fn()` 为什么是高危区
Sequelize.literal() 的作用就是把内容原样塞进 SQL。它不是“更灵活的参数绑定”,而是主动绕开参数绑定。因此,只要 literal() 里混入用户输入、模板字符串或字符串拼接,防护就等于失效。
where: { name: { [Op.like]: literal(`%${req.query.q}%`) } }:危险,拼接后的内容会原样进入 SQL。attributes: [[literal('NOW()'), 'ts']]:安全,前提是整段字符串完全静态,没有外部变量。fn('LOWER', literal(req.query.q)):危险,fn()并不会净化literal()里的内容。
比如这段代码:
where: { name: { [Op.like]: literal(`%${req.query.q}%`) } }一旦传入恶意内容,最终就可能变成类似 name LIKE '%admin'-- %' 这样的 SQL 片段。此时 ORM 没有任何机会替你做参数化,因为你已经显式要求它“原样输出”。
fn() 本身并不等于危险,它的问题在于常被误用成“包一层函数就安全了”。实际上,如果它接收的是 literal() 或动态拼出的 SQL 片段,本质上仍然是手写 SQL,只是换了个包装。
所以这里的判断标准很直接:literal() 只适合放完全静态、可审计的 SQL 片段;一旦里面出现 req.*、模板字符串或 + 拼接,就应该当作注入风险处理。
动态字段的正确收口方式:硬编码白名单
排序字段、分组字段、动态列名这类内容无法参数化时,真正可靠的做法不是“尽量过滤”,而是把允许范围提前写死,在 Controller 或路由处理层完成校验。
例如只允许按 id、name、created_at 排序,可以直接这样处理:
const ALLOWED_SORT_FIELDS = ['id', 'name', 'created_at']
const sortField = ALLOWED_SORT_FIELDS.includes(req.query.sort)
  ? req.query.sort
  : 'id'

order: [[sortField, 'ASC']]
这类白名单有两个关键点。第一,列表必须是硬编码、可审计的固定集合;第二,校验要在真正生成查询之前完成,而不是等 SQL 拼出来以后再补救。
有些常见“替代方案”看起来省事,实际上都不够稳:
req.query.sort.replace(/[^a-z_]/g, '')这类正则过滤并不可靠,攻击面并不只限于你预想的字符集合。- 从数据库动态查询字段列表再生成“白名单”也不理想,因为结构会变化,而且这个过程本身可能受外部输入影响。
对这类位置来说,白名单不是“推荐做法”,而是几乎唯一站得住脚的方案。因为数据库参数绑定机制从设计上就不处理列名、表名、排序字段这些结构位,既然不能绑定,就只能限制来源。
最后要问的其实只有一句话
Sequelize 能帮你挡住很多“值位”注入,但它无法替你判断一个变量是不是正在参与 SQL 结构生成。真正值得养成的习惯,是每次接入新参数时先问一句:这个变量最后进入的是值位,还是结构位?
如果是值位,优先使用模型方法或 replacements;如果是结构位,就不要幻想靠转义或正则兜底,而是回到固定枚举和硬编码白名单。这个判断一旦做错,前面所有参数化措施都可能被绕过去。















