



很多 SQL 查询问题,表面上像是“语法写错了”,本质却是没有分清 WHERE 和 HAVING 分别在什么阶段生效。本文把两者放回 SQL 执行顺序里讲清楚,再结合常见误写、合法写法和性能差异,帮助你判断条件到底该落在行过滤还是分组过滤这一步。
WHERE 和 HAVING 的核心区别
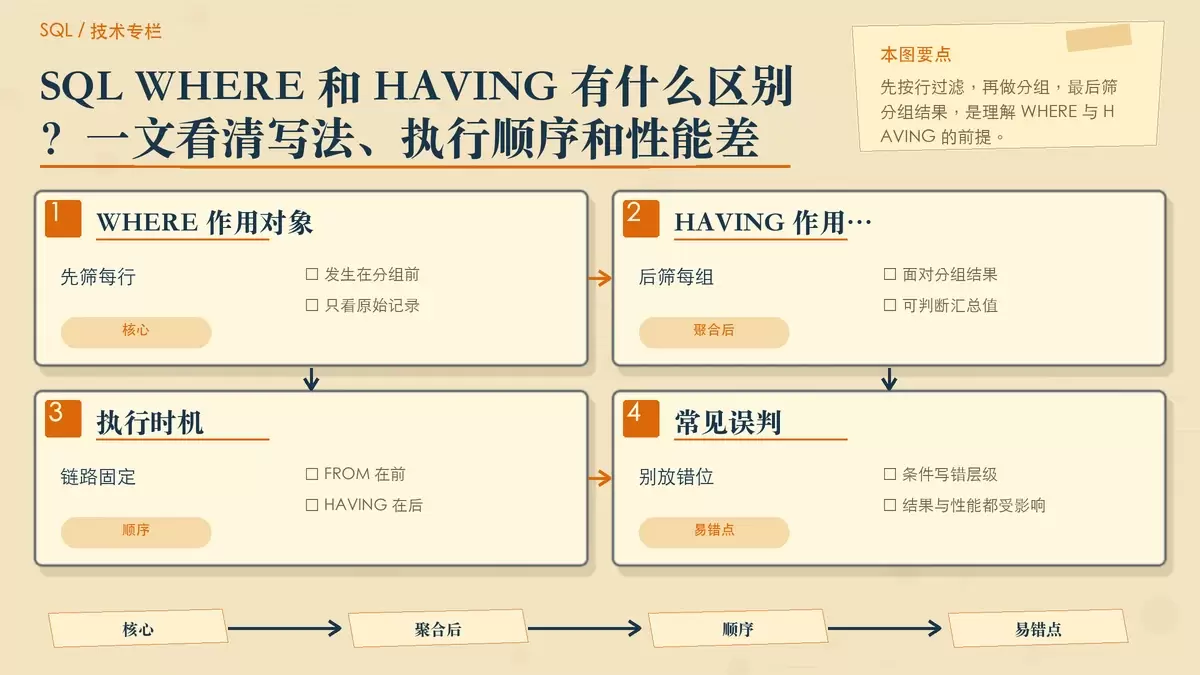
WHERE 过滤的是原始数据行,HAVING 过滤的是 GROUP BY 之后生成的分组结果。两者最关键的区别,不只是“写法不同”,而是处理对象和执行时机不同。
可以把 SQL 查询理解成一条有先后顺序的处理链:先从表里取数据,再按条件筛掉无关行,然后再分组、计算聚合值,最后才决定哪些分组要保留。因此:
WHERE发生在GROUP BY之前,只能判断单行字段条件。HAVING发生在GROUP BY之后,适合判断COUNT()、SUM()、AVG()这类聚合结果。
一句话记忆:WHERE 筛行,HAVING 筛组。
为什么 WHERE 不能直接写聚合函数
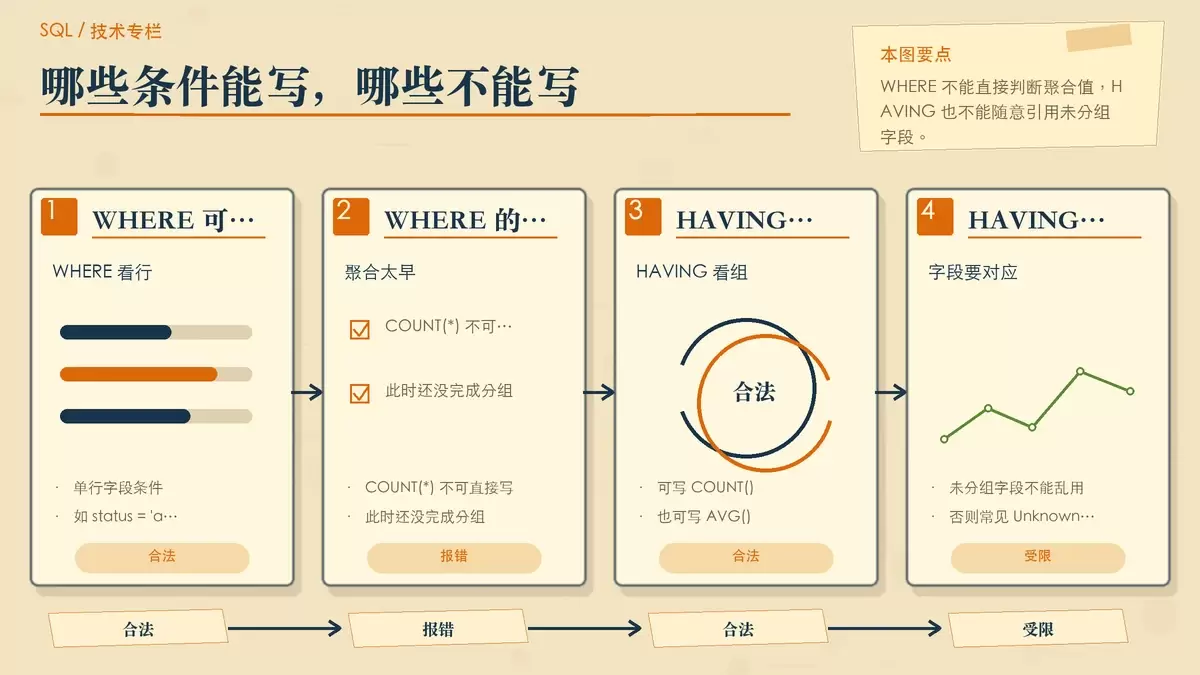
很多初学者第一次遇到报错,往往就是把聚合条件直接写进了 WHERE。原因不复杂:执行到 WHERE 时,数据库还没有完成分组,更没有算出每组的计数、求和或平均值。
这时如果写 COUNT(*) > 5,数据库并不知道这个计数应该基于哪一个分组来算,因此多数数据库会直接拒绝执行。
- ✅ 正确:
WHERE status = 'active' - ❌ 报错:
WHERE COUNT(*) > 5 - ⚠️ 常见误写:
SELECT user_id FROM orders GROUP BY user_id WHERE SUM(amount) > 1000
上面这类写法有两个问题:一是 WHERE 的位置错了,二是它试图在行过滤阶段使用聚合结果,因此必然失败。
如果需求是“统计每个用户的订单金额,再找出总金额超过 1000 的用户”,正确思路应该是先分组,再用 HAVING 判断聚合值。
SELECT user_id
FROM orders
GROUP BY user_id
HAVING SUM(amount) > 1000;
HAVING 能做什么,字段为什么也有限制
HAVING 的优势在于它面对的是“分组后的结果集”,所以可以合法使用聚合函数:
- ✅ 正确:
HAVING COUNT(*) > 5 - ✅ 正确:
HAVING AVG(price) > 100
但这并不意味着 HAVING 可以随便引用原表中的任意字段。分组完成后,查询看到的已经不再是原始明细行,而是每个分组汇总后的结果。因此,HAVING 里通常只能安全引用两类内容:
- 分组字段,也就是出现在
GROUP BY中的列; - 聚合计算结果,例如
COUNT(*)、SUM(amount)、AVG(price)。
例如下面这句,在很多数据库里都会报错:
- ❌
HAVING product_id = 123
原因是 product_id 如果既不在 GROUP BY 中,也不是聚合结果,数据库无法判断这个字段在一个分组里到底该取哪一行的值,于是会提示类似 Unknown column 的错误。
如果业务确实要求按这个字段过滤分组,就要先把它纳入分组键,例如:
GROUP BY category, product_id
HAVING product_id = 123
不过这里也要留意语义是否合理。只要条件本质上是对原始行做限定,通常仍应优先放在 WHERE,而不是拖到 HAVING 才处理。
性能差距为什么会很明显
在真实业务库里,WHERE 和 HAVING 最大的实际差别,往往不是“能不能跑”,而是“跑得有多慢”。
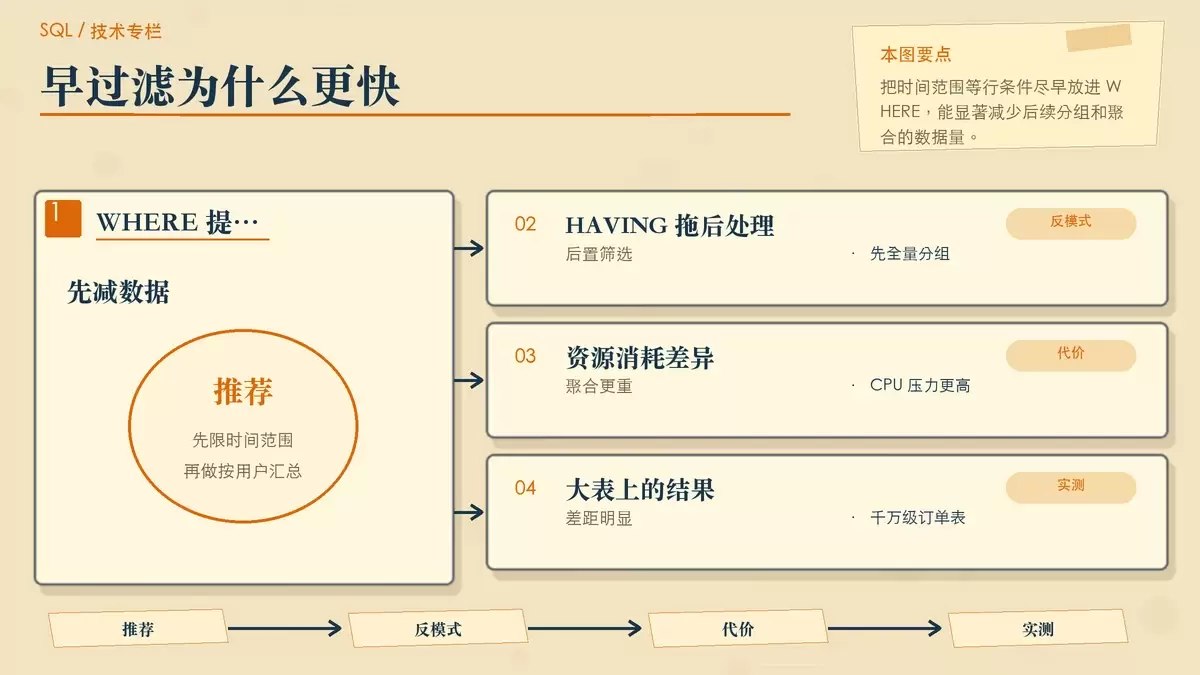
WHERE 会先把无关行剔除掉,后面的分组和聚合只处理剩下的数据;而 HAVING 要等所有候选数据都完成分组和计算之后,才开始筛结果。前者是在入口做减法,后者是在尾部做清理,代价通常完全不同。
例如这类写法就更合理:
WHERE created_at >= '2025-01-01'
GROUP BY user_id
HAVING SUM(amount) > 5000
它的含义是:先把 2025 年以后的订单拿出来,再按用户汇总,最后只保留累计金额大于 5000 的用户。这样后续参与分组的数据量会明显减少。
相反,下面这种写法通常属于反模式:
GROUP BY user_id
HAVING created_at >= '2025-01-01' AND SUM(amount) > 5000
问题在于:
created_at不在分组字段里,多数数据库会直接报错;- 即便某些数据库勉强支持,也往往意味着先对更大范围的数据做分组,再在结果阶段过滤,代价更高。
在千万级订单表上,先用 WHERE 缩小时间范围,再做聚合,往往会比把逻辑拖到 HAVING 快 4 到 7 倍,尤其在聚合字段缺少合适索引时,差距会更明显。
WHERE 和 HAVING 一起用时,顺序怎么写
很多业务查询并不是二选一,而是同时需要这两层过滤:
- 先从原始行里挑出符合条件的数据;
- 再从这些数据形成的分组中,筛出满足聚合要求的结果。
这时应当严格按照 SQL 的执行顺序组织语句:
FROM → WHERE → GROUP BY → HAVING
例如:
SELECT department, COUNT(*)
FROM employees
WHERE hire_date > '2024-01-01'
GROUP BY department
HAVING COUNT(*) >= 3;
这条语句的逻辑很清楚:
WHERE hire_date > '2024-01-01'先过滤员工表中的每一行;GROUP BY department再把剩余记录按部门分组;HAVING COUNT(*) >= 3最后只保留人数不少于 3 的部门。
这里最容易犯的错,是把本应属于行条件的内容塞进 HAVING,或者以为数据库会自动把条件“挪到更优的位置”。通常不会。条件写在哪一层,数据库就按那一层去执行。
HAVING 单独出现时要注意什么
有些数据库允许在没有 GROUP BY 的情况下单独写 HAVING,语法上看似可行,但可读性和可移植性都比较差。
这种情况下,整张表往往会被当成一个组处理。虽然某些简单查询也许能跑通,但语义容易引起误解,换数据库或做 SQL 迁移时也可能出现兼容性问题。
用于生产环境时,更稳妥的做法是显式写出 GROUP BY,让查询意图清楚可见,避免团队成员误读,也减少后续维护成本。















