



很多人第一次用 LEFT JOIN 做“包含 0 的统计”,都会遇到一个反直觉结果:明明右表没有匹配记录,COUNT(*) 却还是算出 1。问题通常不在 SQL 语法本身,而在于对聚合口径、分组键以及过滤位置的理解出现了偏差。下面就用订单与商品的例子,把这类查询里最容易踩的三处坑拆开说明,并给出可直接套用的写法和性能判断标准。
为什么 LEFT JOIN 之后,COUNT(*) 统计不出 0
LEFT JOIN 的核心语义是:即使右表没有匹配到数据,左表这一行也要保留,只是右表字段会被补成 NULL。这也是为什么很多人写出聚合后,结果总是至少为 1。
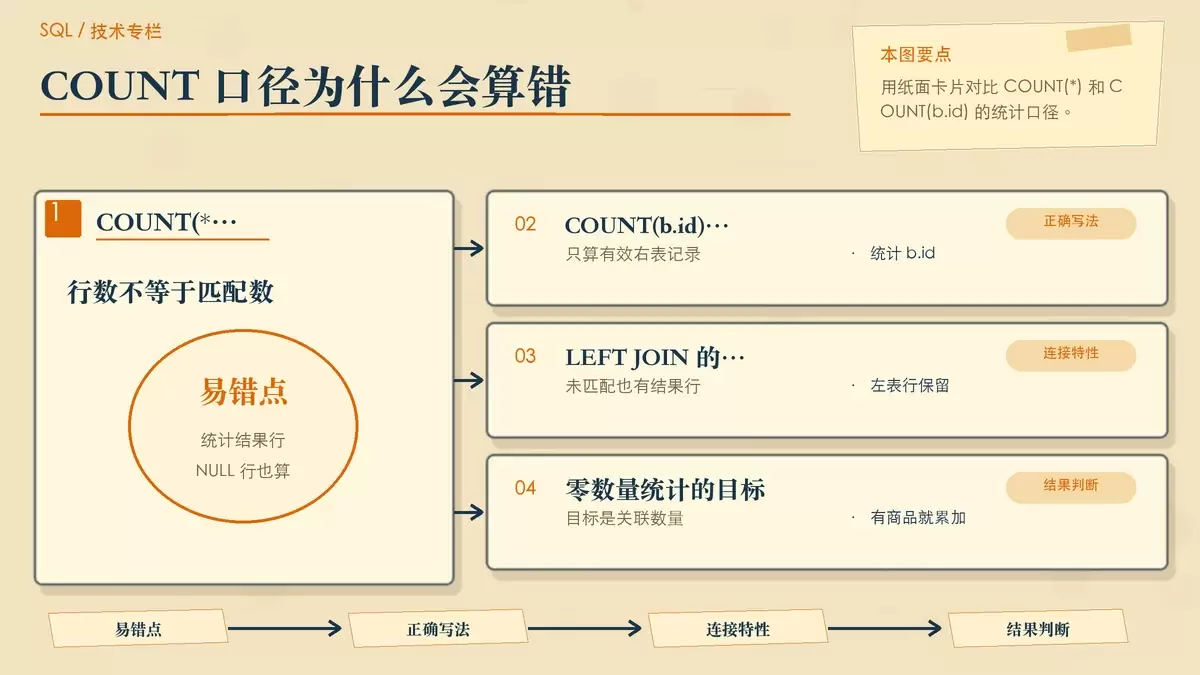
原因很简单:COUNT(*) 统计的是结果集里的“行数”,而不是右表里真正匹配成功的有效记录数。对 LEFT JOIN 来说,即使右表没匹配到,也仍然会有一行结果存在,因此 COUNT(*) 不会得到 0。
常见错误写法如下:
SELECT a.id, COUNT(*) FROM orders a LEFT JOIN items b ON a.id = b.order_id GROUP BY a.id
这条 SQL 的问题在于,只要订单 a.id 存在,聚合时就至少会统计到一行,所以即便某个订单没有任何商品,结果也会被算成 1。
更合适的写法是统计右表中不会为空的字段,例如右表主键:
SELECT a.id, COUNT(b.id) FROM orders a LEFT JOIN items b ON a.id = b.order_id GROUP BY a.id
这里的关键区别是:COUNT(b.id) 只会统计 b.id 非 NULL 的记录。对于没有匹配商品的订单,连接结果里 b.id 为 NULL,因此最终能正确得到 0。
实务里可以记一个简单规则:如果你要统计“关联到了多少条右表记录”,优先写 COUNT(右表主键),或者使用 COUNT(右表非空字段),不要直接用 COUNT(*) 替代。
GROUP BY 应该按谁分组,才不会把结果算乱
把计数口径改对之后,第二个常见问题就是 GROUP BY。LEFT JOIN 配合聚合查询时,分组字段必须能稳定代表左表中的一条记录,否则结果不是报错,就是把多条数据合并到一起。
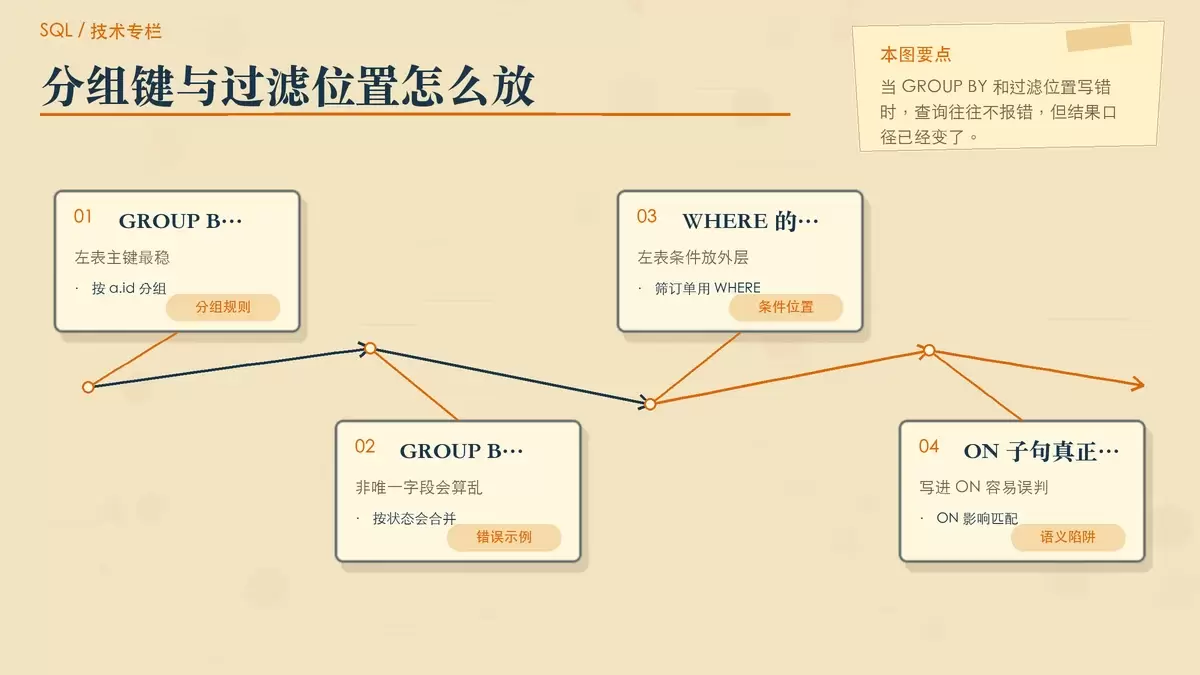
更稳妥的原则是:GROUP BY 应当使用左表主键,或者左表中能唯一标识一行的字段。这样每个分组才对应一条左表记录,统计出来的数量也才有明确含义。
关键原则:GROUP BY 的字段必须能唯一确定左表每一行,且不能包含右表可能为 NULL 的字段。
- ✅ 正确:
GROUP BY a.id(假设a.id是orders主键) - ❌ 错误:
GROUP BY a.status(多个订单可能同状态,会被合并) - ❌ 危险:
GROUP BY a.id, b.category(b.category为NULL时会让分组结果变复杂,且统计目标也被改变)
尤其是在一些非严格 SQL 模式下,错误的分组不一定立刻报错,但返回结果可能已经偏离你的业务含义。比如按 a.status 分组时,你得到的不是“每个订单有多少商品”,而是“每种订单状态对应多少关联记录”,这和原始需求已经不是一回事。
所以在“左表一行,对应右表零到多行”的统计场景里,可以先确认一句话:你到底要按“哪一条左表记录”输出结果。答案如果是订单,就按订单主键分组;答案如果是用户,就按用户主键分组。这个判断比语法本身更重要。
过滤左表时,为什么条件要写在 WHERE 而不是 ON
第三个很隐蔽的坑,出现在查询条件的位置上。很多人会把左表过滤条件直接写进 ON 子句,觉得这样更顺手,但这会改变查询的实际语义。
假设你想统计“2024 年下的订单及其商品数”,正确写法应该是先筛出 2024 年的订单,再去看每个订单关联了多少商品。也就是说,时间条件属于左表 orders 的筛选逻辑,应当放在 WHERE 中:
SELECT a.id, COUNT(b.id)
FROM orders a
LEFT JOIN items b ON a.id = b.order_id
WHERE a.created_at >= '2024-01-01'
GROUP BY a.id
这样写,参与统计的左表记录只有 2024 年的订单,结果口径才准确。
如果误写成下面这样:
ON a.id = b.order_id AND a.created_at >= '2024-01-01'
看起来像是加了时间过滤,实际上并没有把非 2024 年的订单从左表结果里排除掉。它只是影响了右表能否匹配成功,最终效果往往变成:所有订单都还在,只是非 2024 年订单的商品匹配被“打断”,于是这些订单的数量被统计成 0。
这和“只看 2024 年订单”的原始需求是两回事,也是 LEFT JOIN 查询里最常见的逻辑陷阱之一。
可以这样理解:
ON负责定义左右表如何匹配WHERE负责决定哪些结果行真正保留下来
当过滤条件属于左表本身时,通常应放在 WHERE;只有当你明确要控制“右表是否算匹配成功”时,才考虑把条件写进 ON。
COUNT(b.id) 会不会比 COUNT(*) 慢
从理论上说,COUNT(*) 的确常被认为是最直接的计数方式,而 COUNT(b.id) 还需要判断列值是否为 NULL。但在现代数据库里,这个差异通常不是零数量统计的性能瓶颈。
以 PostgreSQL 12+、MySQL 8.0+、SQL Server 为例,只要 b.id 本身定义为 NOT NULL,优化器通常能够把 COUNT(非空列) 做到和 COUNT(*) 接近,甚至生成相同的执行计划。也就是说,在“统计右表有效匹配数”这个场景里,选择 COUNT(b.id) 通常不会成为主要性能问题。
真正决定速度的,往往是 LEFT JOIN 本身,尤其是右表连接字段是否有索引。如果 items.order_id 没有索引,数据库就可能为了匹配每条订单记录去扫描大量商品数据,查询时间很容易从毫秒级上升到秒级。
因此比起纠结 COUNT(*) 和 COUNT(b.id) 的微小差异,更应该优先检查右表连接列的索引是否完善:
- MySQL:
ALTER TABLE items ADD INDEX idx_order_id (order_id); - PostgreSQL:
CREATE INDEX CONCURRENTLY ON items (order_id);
如果你在生产环境里遇到零数量统计越来越慢,第一步通常不是改计数函数,而是确认连接列有没有索引、执行计划是否走到了正确路径。
一条可复用的判断规则
把上面几个点合起来,使用 LEFT JOIN 做零数量统计时,可以按下面这套思路快速自查:
- 要统计右表匹配条数时,用
COUNT(右表主键),不要直接用COUNT(*) - 聚合时按左表主键或唯一标识分组,避免结果被合并或拆散
- 左表过滤条件放在
WHERE,不要误塞进ON里改变连接语义 - 性能优化优先看右表连接字段索引,而不是先怀疑
COUNT(b.id)
如果你的目标是“把没有关联记录的左表数据也展示出来,并且数量显示为 0”,那么这套写法基本就是最稳的通用解法。先把统计口径、分组方式和过滤位置这三件事写对,再去谈性能,通常就不会偏离需求。















