



很多人第一次接触 SQL 视图时,都会把它当成“不会占空间的表”来理解,但这正是后续踩坑的起点。要判断视图能不能写、删掉会不会影响原表、性能该怎么优化,关键得先分清它到底存的是什么、适合放在哪一层,以及什么时候必须回到真实数据表来解决问题。
视图不存数据,表才是真正的存储单元
SELECT 查出来的结果集,和 CREATE VIEW 创建后的查询结果,表面上看都像一张表,但底层完全不是一回事。普通表会把数据真实写入磁盘;视图只是把一段查询定义保存下来,查询它时,数据库再去实时执行背后的 SQL。
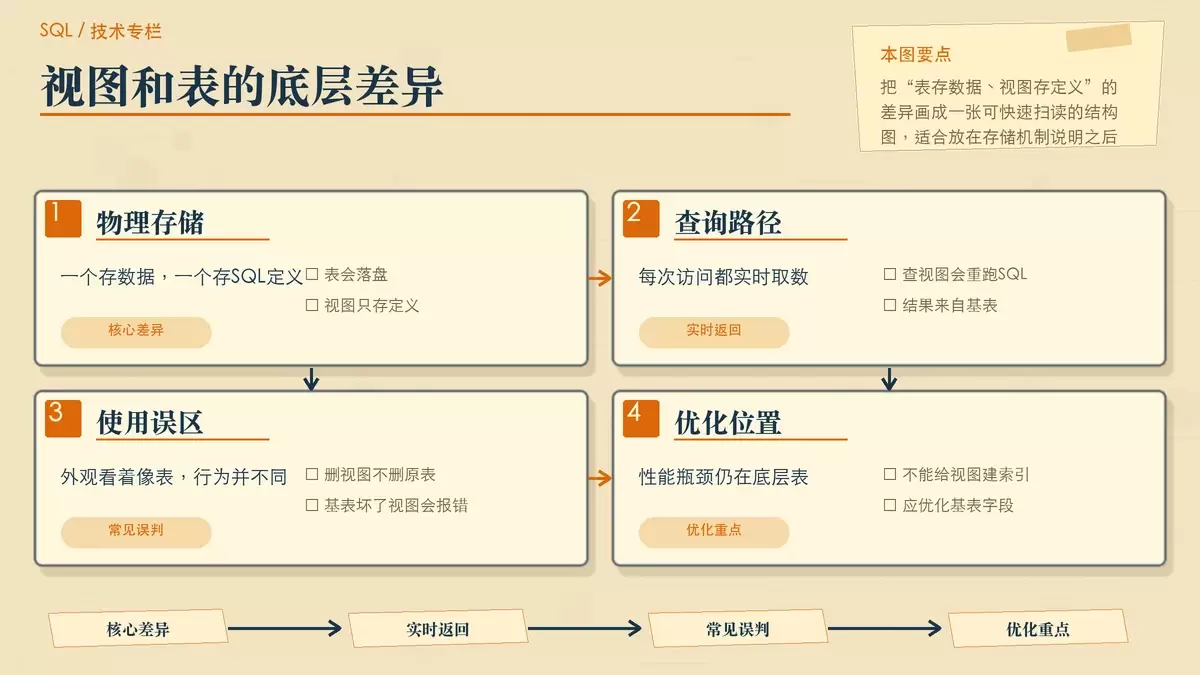
例如,执行 CREATE TABLE users 时,数据库会为这张表分配物理存储空间,把每一行数据真正落盘。相比之下,执行下面这条语句时:
CREATE VIEW active_users AS SELECT * FROM users WHERE status = 'active'数据库保存的只是 SELECT * FROM users WHERE status = 'active' 这段定义,而不是查询结果本身。所以每次访问 active_users,本质上都是重新从 users 表里把符合条件的数据取出来。
这会带来几个很典型的误区:
- 删掉视图,不会删除原表数据,因为视图本身没有数据可删。
- 基表一旦变更,视图结果会立刻跟着变化,它没有“自己的副本”。
- 如果基表被删除或字段失效,视图定义可能还在,但再次查询就会报错。
原文里提到的一个典型错误就是:
ERROR 1356 (HY000): View 'db.active_users' references invalid table(s) or column(s)这类报错通常不是视图“坏了”,而是它依赖的表或列已经不再有效。
另外,很多人发现视图查询慢,第一反应是“给视图加索引”。这条思路在普通视图上行不通,因为视图本身不能建索引。能优化的仍然是底层基表,例如筛选列、关联列、排序列上的索引设计。类似地,导出视图结构时,SHOW CREATE VIEW 返回的也是视图定义 SQL,而不是建表语句。
为什么大多数视图不能直接写入
视图最常见的用途是读,而不是写。多数视图默认只支持 SELECT,一旦定义里出现了复杂逻辑,数据库通常就不会允许你直接对它做 INSERT、UPDATE 或 DELETE。
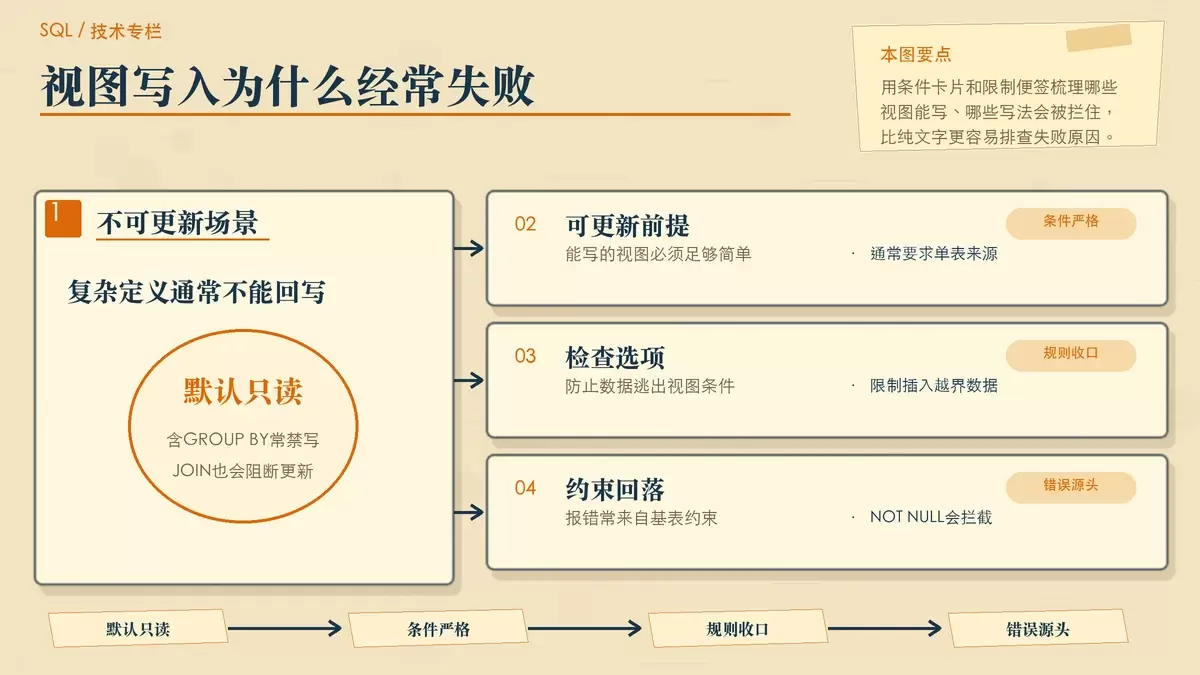
常见的不可更新场景包括:
- 使用了
GROUP BY - 包含
JOIN - 用了聚合函数,如
COUNT()、SUM() - 用了去重
DISTINCT
这些写法会让“视图中的一行究竟对应基表中的哪一行”变得不再明确,数据库自然也就无法安全地回写到底层表。
如果一定要让视图可更新,通常要满足比较严格的条件:来源于单表、不含计算列、主键列完整暴露,而且视图条件不能把目标写入路径弄得模糊。以 MySQL 为例,若要防止写入的数据绕开视图的过滤条件,还需要配合 WITH CHECK OPTION。
比如你执行 INSERT INTO active_users 失败,排查时可以先看两件事:视图定义里是否带有 WHERE status = 'active',以及是否配置了 WITH CHECK OPTION。否则即便语法上能写,也可能插入一条并不满足视图条件的数据,或者直接被数据库拒绝。
还有一点容易混淆:即使对视图的写操作语法通过了,真正落地时仍然要受基表约束控制。像外键、NOT NULL、唯一约束这类错误,本质上仍然来自基表,而不是视图层本身。
不同数据库在这里也有差异。原文提到,PostgreSQL 对可更新视图的限制相对更宽松,而 MySQL 和 SQL Server 通常更保守。实际开发里,不能只凭 SQL 写法判断,还要看具体数据库的实现规则。
视图真正的价值:封装、隔离和稳定接口
如果视图既不存数据,又常常不方便写,那它为什么还值得用?原因在于,视图的核心价值本来就不在存储,而在于把复杂查询和权限边界收拢成一层稳定接口。
它最常见的三类用途是:
- 权限控制
- 查询复用
- 接口稳定
先看权限控制。比如只想让报表组读取整理后的销售数据,而不直接接触原始业务表,这时就可以只开放一个 sales_summary 视图。视图内部已经把多张表 JOIN 好,同时过滤掉单价、成本等敏感字段,外部用户只看到允许暴露的列。
再看查询复用。如果某一段 SQL 逻辑需要被多个页面、多个服务重复调用,把它写成视图通常比到处复制 SQL 更稳。字段重命名、关联条件、过滤规则都集中在一个地方维护,后续修改成本更低。
最后是接口稳定。底层表结构经常会变,比如增加字段、调整字段类型,甚至拆表合表。只要对外暴露的视图定义保持兼容,上层应用代码就可以不跟着一起改,这对系统演进很有价值。
不过,视图的边界也要看清。高频聚合查询如果每次都通过普通视图实时重算,性能很容易成为瓶颈。原文特别提醒,这类场景更适合物化视图,例如 PostgreSQL 的 MATERIALIZED VIEW,或者使用定时汇总表,把计算结果预先落地。
另一个常见问题是嵌套视图。视图里再引用其他视图,虽然开发初期看起来省事,但调试成本会明显增加。原文提到,MySQL 对嵌套视图不会直接展开,EXPLAIN 也不容易看见真实执行路径,排查性能问题时会比较吃力。
权限管理上也别想当然。给用户授权访问视图时,需要单独授予视图权限,例如:
GRANT SELECT ON sales_summary TO report_user这和基表权限不是同一回事,不能默认互通。
什么时候该用表,什么时候该用视图
实际选型时,可以先问三个问题:数据是否需要长期独立存在?是否要被其他系统直接写入?是否要承担强一致性的写入原子性?只要这些问题里有明确的“是”,那主体就应该是表,而不是视图。
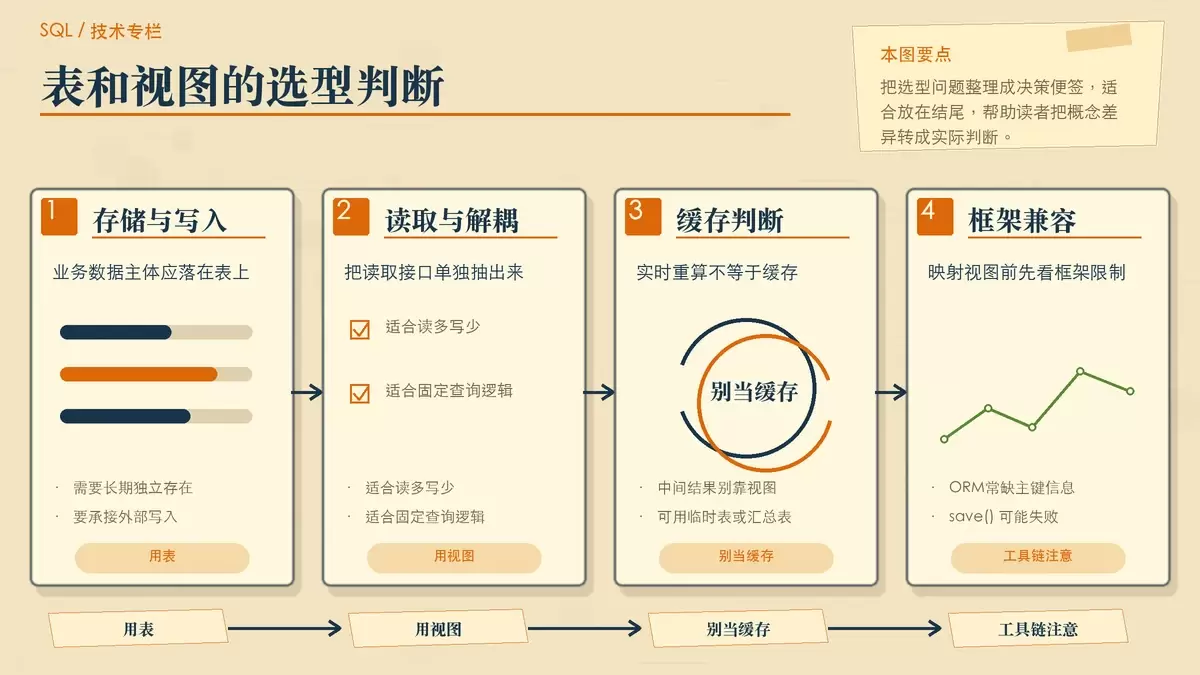
换句话说,表适合承担真实业务数据的存储与写入职责;视图更适合放在读多写少、逻辑固定、希望和底层实现解耦的场景里。
几个典型例子可以帮助判断:
- 把
user_info中脱敏后的字段组合成public_profile,适合用视图。 - 把订单、商品、库存三张表拼成
order_dashboard给前端查询,适合用视图。 - 想缓存一个中间结果,应该考虑
CREATE TEMPORARY TABLE或普通表加定时任务,而不是把视图当缓存层。 - 做 ETL 加工链时,清洗和转换步骤应落到真实表,视图更适合作为最后对外输出的一层。
如果你使用 ORM,还要额外注意视图映射问题。很多 ORM 在映射视图时,不会像映射普通表那样自动识别完整主键信息,id 字段可能只被当成普通列,最终导致 save() 失败。这类问题不是 SQL 写错,而是工具链默认假设“它不是一张标准可写表”。
从这个角度看,视图更像一个自动执行的查询接口,而不是一份独立快照。它带来的便利在于逻辑集中、输出稳定;代价则是每次访问都要重新计算,性能和可控性都受底层查询复杂度影响。你看到的永远是最新结果,但也必须为这份“实时”付出执行成本。
一句话判断两者的本质差异
可以把这件事压缩成一句很实用的判断:表负责存,视图负责看。
当你需要落地数据、承接写入、保证事务一致性时,用表;当你需要封装复杂查询、隔离敏感字段、给外部系统提供稳定读取接口时,用视图。两者长得像,但职责并不重叠,真正区分开之后,很多关于权限、性能、写入限制和系统设计的问题都会更容易判断。















