



很多人把“触发器报错后数据没了”理解成触发器主动执行了回滚,其实这往往是数据库事务模型在起作用。本文按 MySQL、SQL Server、错误可见性和应用层传播四个层面拆开说明,帮助你判断到底是引擎原子性、事务配置,还是异常被中间层吞掉了。
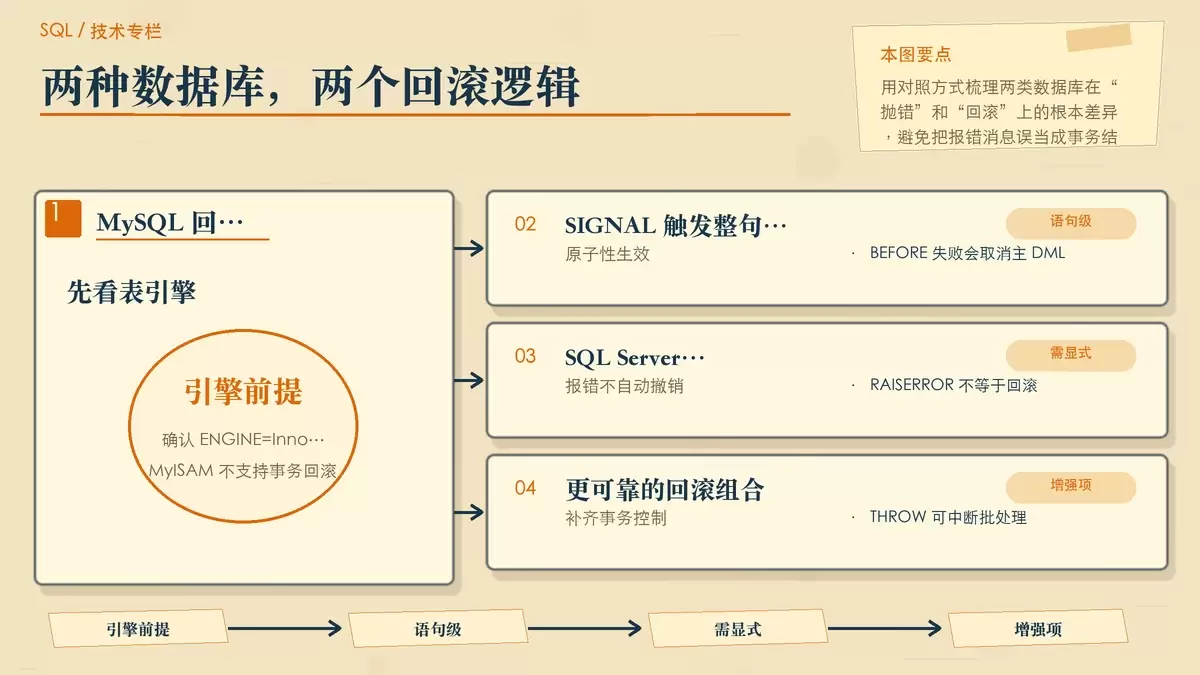
MySQL 的 BEFORE 触发器里,SIGNAL 为什么会连主语句一起撤销
在 MySQL 中,如果触发器定义在 InnoDB 表上,且事务环境允许回滚,那么 BEFORE 触发器里执行 SIGNAL SQLSTATE '45000',会让当前 DML 直接失败,并撤销这条语句涉及的修改。这里要注意,它不是“触发器自己回滚了主语句”,而是 MySQL 对语句执行过程提供的原子性保证:触发器属于这条 DML 的一部分,前置阶段失败,整条语句自然不能提交。
这意味着,被撤销的不只是原始的 INSERT 或 UPDATE,还包括触发器里已经执行过的写操作。只要它们都处在同一事务语境内,失败结果会一起回退。
这个结论成立,通常要先确认几个前提:
SHOW CREATE TABLE t的输出中必须包含ENGINE=InnoDB。如果是MyISAM,就没有事务回滚能力,触发器报错后的行为不能按事务型引擎理解。SELECT @@autocommit如果返回1,那么单条 DML 本身就是一个独立事务。此时照样会回退这条语句,但不会再连带撤销之前已经执行成功的其他语句,因为它们不在同一个事务里。- 如果
sql_mode没有包含STRICT_TRANS_TABLES,某些字段类型问题可能被静默截断,结果是你以为会先进入触发器并执行SIGNAL,实际上数据库可能已经用宽松模式处理掉了异常输入,判断路径和预期并不一致。
所以,MySQL 里“触发器抛异常导致事务回滚”的本质,是事务型存储引擎加语句原子性共同作用的结果,而不是触发器拥有独立的回滚控制权。
SQL Server 里为什么 RAISERROR 报错了,数据却还在
同样是触发器里抛错,SQL Server 的行为很容易让人误判。原因在于 RAISERROR 的职责主要是发出错误消息,它本身并不等于“回滚事务”。如果代码里只写了 RAISERROR,却没有显式执行 ROLLBACK TRANSACTION,那么你完全可能看到错误信息,同时发现 INSERT 仍然已经落库。
要让失败真正影响事务状态,通常需要把回滚逻辑写完整:
RAISERROR后面要跟上IF @@TRANCOUNT > 0 ROLLBACK TRANSACTION,并确保这段代码一定能执行到。最常见的放置位置是分支末尾,或者TRY...CATCH结构里的CATCH块。- 如果你只在
TRY里抛错,却没有在后续显式回滚,事务可能进入挂起状态。之后的操作不但不会自动恢复,反而可能继续触发类似ERROR 3903的问题。 - 在 SQL Server 2012+ 环境,可以考虑改用
THROW。它比RAISERROR更接近现代异常语义,默认会中断当前批处理,但即便如此,要想更可靠地让整笔事务一起撤销,仍然建议配合SET XACT_ABORT ON。
也就是说,在 SQL Server 里,看到错误不等于事务已经回滚;真正决定结果的,是你有没有把错误处理链补完整。
触发器明明报错了,客户端为什么看不到真实异常
另一类常见困惑是:数据库里实际出了错,但应用侧只看到“执行失败”甚至完全没有明确信息。这通常不是因为没报错,而是错误没有顺利传播到客户端。
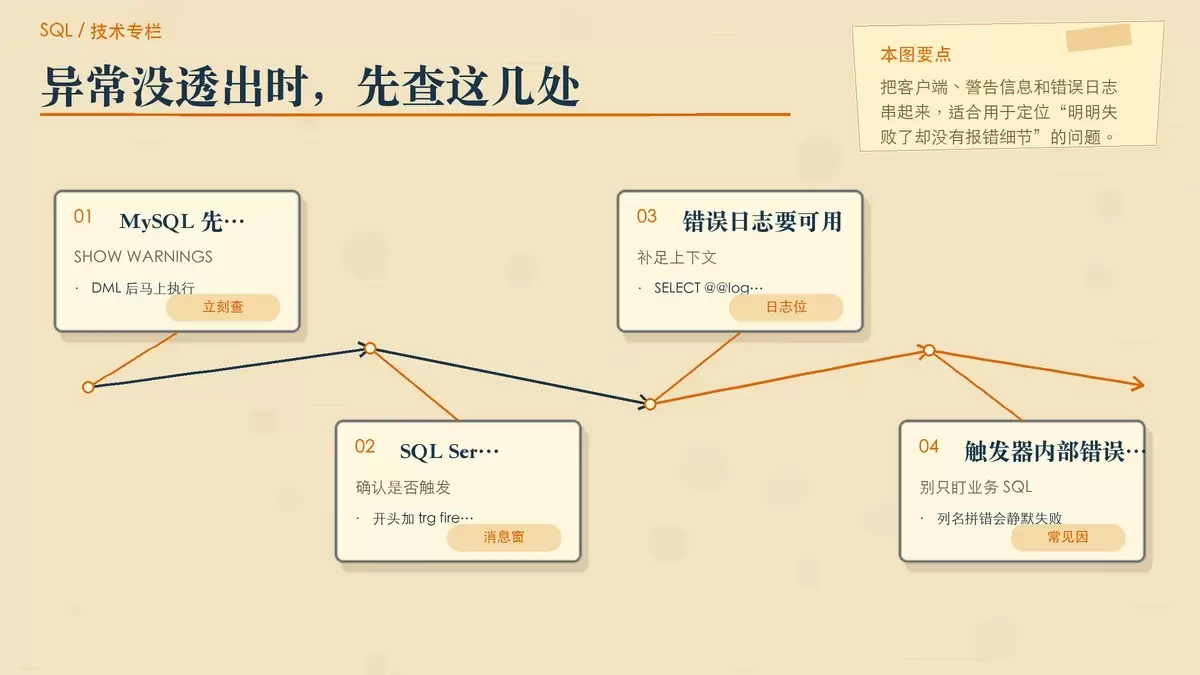
在 MySQL 中,触发器里的语法错误、列名拼写错误、跨库表名漏写库名等问题,往往不会以你期待的方式直接暴露在客户端结果里。表面上看像是主语句静默失败,真正的错误细节却要靠后续查询才能拿到。
更有效的排查方式有三类:
- MySQL:执行完 DML 后立刻运行
SHOW WARNINGS,经常能直接看到真实报错。例如:Warning 1327 Undeclared variable: NEW.invalid_col。 - SQL Server:可以在触发器开头临时加入
RAISERROR('trg fired', 0, 1) WITH NOWAIT,然后到 SSMS 的“消息”窗口里确认触发器是否真的被执行。 - 检查日志:用
SELECT @@log_error确认 MySQL 错误日志位置,并核对log_error_verbosity = 3(MySQL 8.0+)是否开启,这样更容易保留足够的错误上下文。
SQL Server 也有类似情况。比如 RAISERROR 没加 WITH LOG,或者错误发生的位置没有进入预期的 CATCH 路径,就可能导致你在业务日志里只能看到笼统失败,而看不到真正的触发点。
因此,排查触发器异常时,先确认“错误有没有发生”,再确认“错误有没有被看见”,往往比盲目修改触发器本身更重要。
应用层没有正确接住异常,回滚现象就会被掩盖
数据库已经回滚,并不代表应用就一定会把这个事实准确呈现出来。触发器里的 THROW、约束冲突或事务终止,如果没有被应用代码正确捕获,最终很可能被包装成空响应、超时、统一错误页,或者一个泛化后的 HTTP 500。
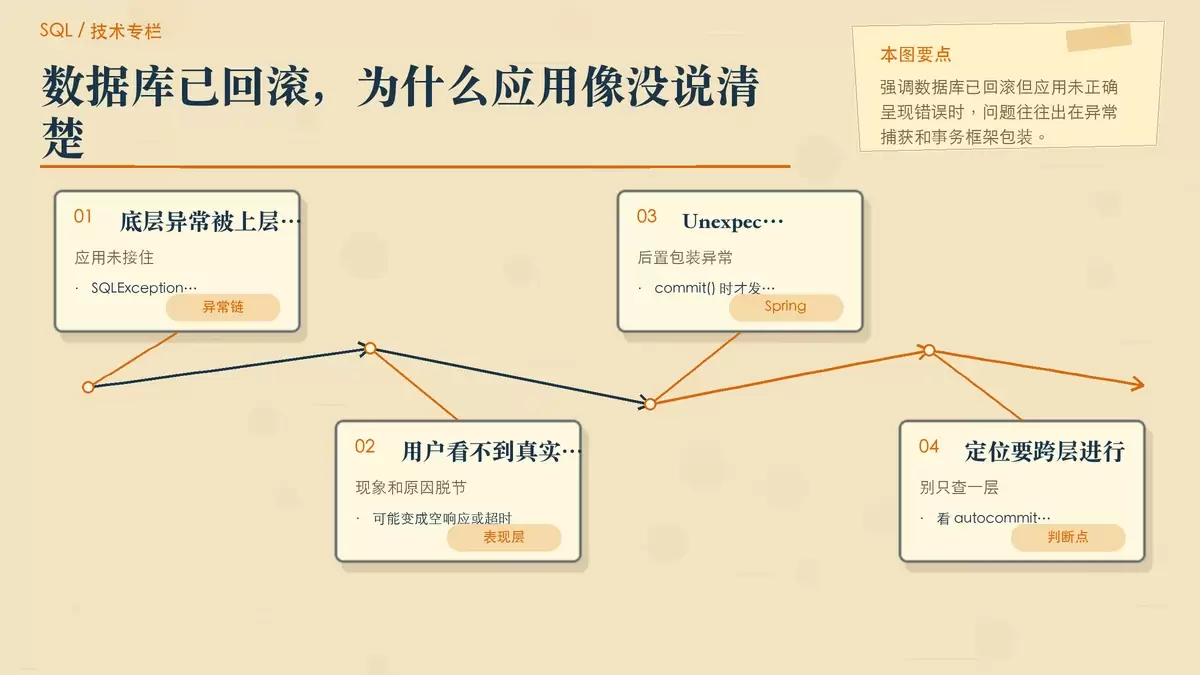
这类问题在 ORM 或事务框架里尤其容易被放大。比如 Java 没有正确处理 SQLException,或者 Go 侧数据库驱动错误被上层忽略,结果就是“数据没写进去,但看不出原因”。表面上像是数据库行为不稳定,本质上却是异常链在应用层断掉了。
Spring 场景里一个典型例子是 UnexpectedRollbackException。这个异常经常让人误以为是业务代码主动发起了回滚,但实际情况往往是:底层事务早已因为触发器中的 ROLLBACK 或数据库错误被终止,等到 Spring 调用 commit() 时,才发现事务已经被标记为 rollback-only,于是重新包装抛出异常。最终日志里只剩一句:
Transaction rolled back because it has been marked as rollback-only
而真正导致失败的原始触发器错误,反而没有保留下来。
所以,判断“为什么触发器抛异常后事务被回滚”,不能只看数据库这一层。触发器没有独立事务生命周期,它最终受三件事共同影响:连接状态是否允许事务控制,比如 autocommit;错误是否能被正确传播,比如 SHOW WARNINGS 或 WITH NOWAIT;以及应用层是否真的把数据库异常当成关键事件来处理。
遇到这类问题时,怎么快速判断责任点
如果你正在排查“报错后为何回滚”或“报错了为何没回滚”,可以按下面的顺序快速定位:
- 先看数据库类型和引擎:MySQL 的
InnoDB与 SQL Server 在错误语义上完全不同,不能直接套同一套经验。 - 再看事务边界:检查
@@autocommit、显式事务、@@TRANCOUNT,确认当前 DML 到底是不是处在可回滚的事务中。 - 然后看异常语句本身:MySQL 的
SIGNAL SQLSTATE '45000'与 SQL Server 的RAISERROR、THROW行为差异很大。 - 最后看错误传播:客户端消息、
SHOW WARNINGS、数据库错误日志、应用框架日志要对起来看,避免把“异常被吞掉”误判成“数据库没有报错”。
把这几层拆开后,你通常就能判断:是 MySQL 的原子性导致整条语句被撤销,还是 SQL Server 里只报错但没有显式回滚;是触发器代码本身有误,还是应用层把底层异常遮住了。















