



很多团队把视图当成“省事的查询别名”,上线后才发现问题往往不出在语法,而是出在依赖关系、过滤位置和底层查询写法。下面就按 SQL Server 2019 的实际使用场景拆开说明:什么时候必须把 schema 写全,为什么生产环境更适合启用 WITH SCHEMABINDING,以及遇到性能下降时该先看哪些信号,帮助你判断视图到底该怎么建、怎么用。
创建视图时,先把架构名写完整
在 SQL Server 中,视图定义里引用的表最好始终使用两段式名称,也就是 schema.table。如果省略 schema,建视图时未必立刻报错,但后续执行可能因为对象解析歧义而出现问题。
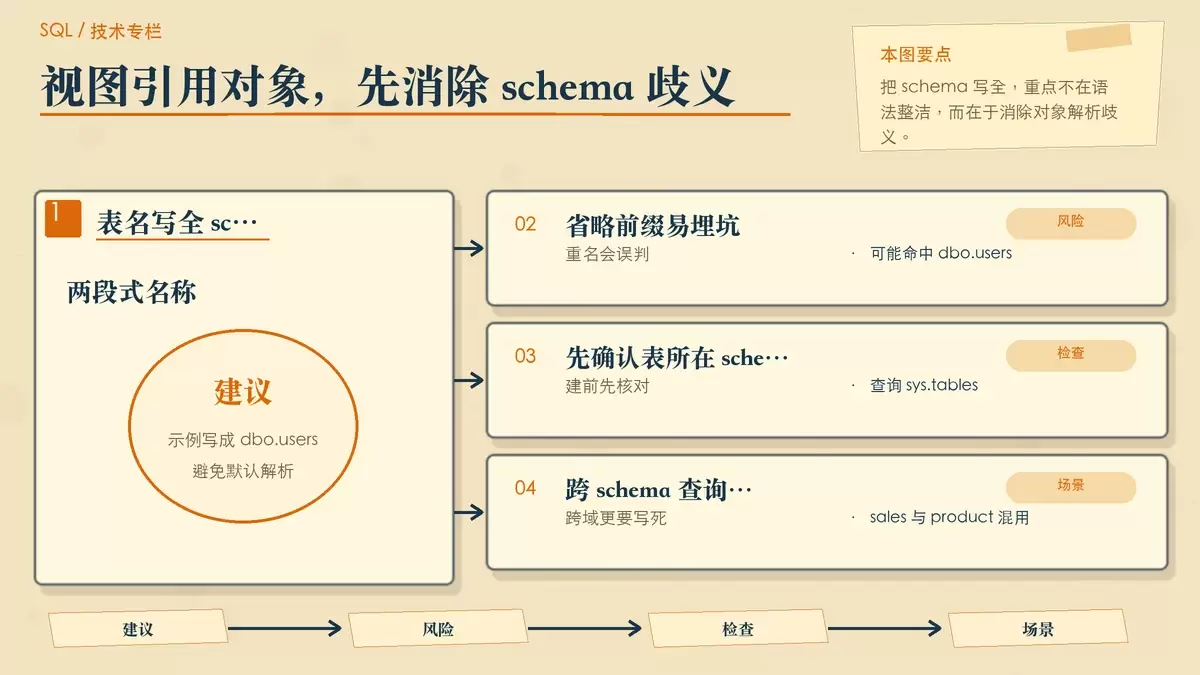
典型情况是你写了 SELECT * FROM users,而数据库里同时存在 dbo.users 和 hr.users。这时 SQL Server 会优先按 dbo.users 解析;如果你的业务原本要查的是 hr.users,视图定义就已经埋下了隐患。
为什么这一步不能省
- 视图依赖的是明确对象,而不是当前用户的默认 schema
- 跨 schema 查询时,省略前缀会让后期维护和排错成本上升
- 对象重名在业务库里并不少见,尤其是分模块或分团队管理时
实操建议
- 始终显式写全架构名,例如:
SELECT id, name FROM dbo.users - 创建前先确认目标表所在 schema:
SELECT SCHEMA_NAME() + '.' + name FROM sys.tables WHERE name = 'users'- 如果业务逻辑跨 schema,例如
sales.order_headerJOINproduct.item_master,相关表名都要明确写死,不能依赖默认解析
为什么生产环境视图更适合加 WITH SCHEMABINDING
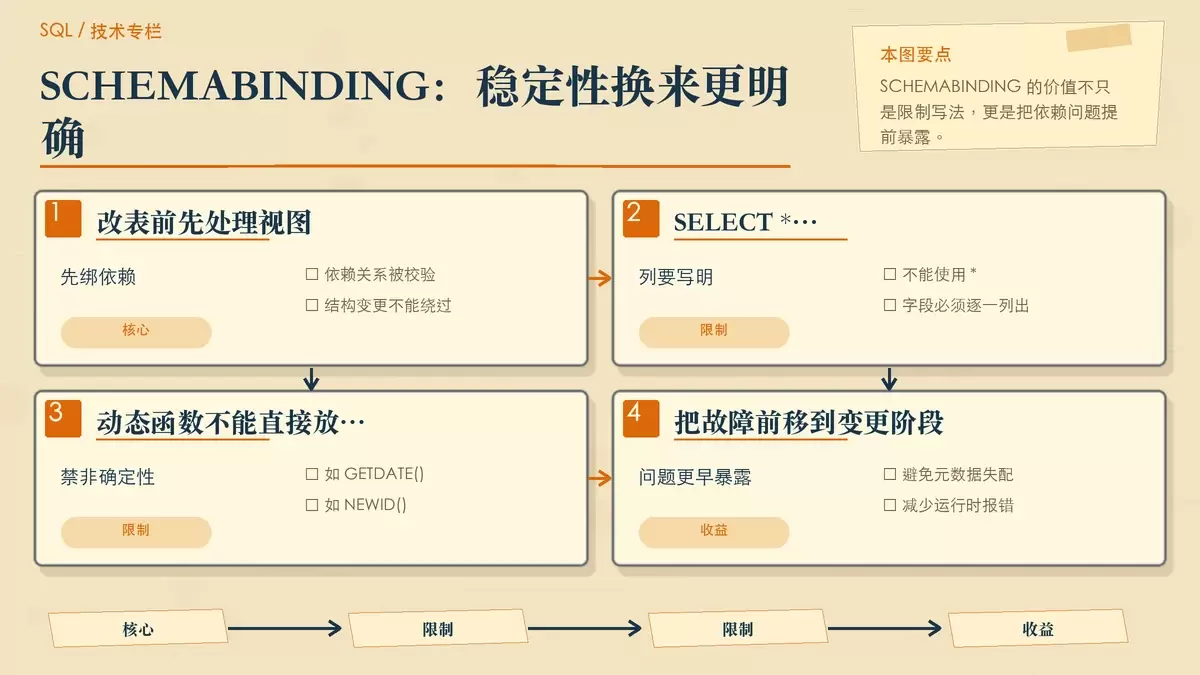
WITH SCHEMABINDING 是 SQL Server 视图里一个很关键的约束开关。不开它,底层表结构即使发生删列、改名、改类型等变化,视图对象本身也可能继续保留;等到真正查询时,才暴露出结果错乱或运行时错误。开了之后,SQL Server 会把依赖关系校验提前到结构变更阶段,反而更利于长期维护。
常见现象是这样的:某天执行 SELECT * FROM v_customer_summary,突然报出 Invalid column name 'email_verified'。你去看表结构,发现这列似乎还在,或者只是做过重命名。很多时候,问题并不在当前查询,而在于视图定义依赖的元数据已经失配。
加上后会带来哪些约束
- 视图中不能再使用
SELECT *,所有列都必须显式列出 - 不能调用非确定性函数,例如
GETDATE()、NEWID() - 底层表要改结构时,必须先处理依赖视图,不能“悄悄改完再说”
这些限制看起来更严格,但它们换来的是可预期的依赖关系,而不是把错误拖到运行阶段才暴露。
推荐做法
- 生产环境视图默认加上
WITH SCHEMABINDING - 把字段列表写明,不要保留
* - 如果确实需要动态时间,不要在视图里直接写
GETDATE(),而是由外层查询传入参数,例如@as_of_date,视图只负责结构封装
还要注意,加了 WITH SCHEMABINDING 之后,视图不能再引用临时表、表变量,也不能在子查询里依赖不合规的 ORDER BY 写法。这些限制有时不会在第一眼就被看出来,但会直接影响后续执行和重构方式。
过滤条件应尽量留在外层,WITH CHECK OPTION 只在必要时使用
把 WHERE 条件硬编码进视图,是很多项目后期灵活性下降的起点。比如把 WHERE status = 'active' 固定在视图中,下游查询一开始看起来省事,但后面一旦要查历史数据、排查异常记录,或者做全量分析,就不得不绕开视图重写 SQL。
更麻烦的是,如果再叠加 WITH CHECK OPTION,那么通过该视图进行的 INSERT 和 UPDATE 也会受到限制。业务侧往往只看到“写入失败”,但错误提示看起来又像普通约束冲突,定位起来并不直观。
什么逻辑适合放进视图
更稳妥的思路是:视图负责封装结构,外层 SQL 负责业务过滤。也就是说,视图适合承载这些内容:
JOIN关系- 基础字段映射
- 简单且稳定的计算,例如
COALESCE(phone, mobile)
而像状态筛选、时间范围、历史版本范围这类变化频繁的条件,尽量交给调用方处理。
什么时候才该用 WITH CHECK OPTION
- 只有在业务明确要求“通过这个视图写入的数据必须满足指定条件”时才启用
- 例如审计类视图中,只允许插入
audit_type IN ('login', 'logout')这样的记录
如果只是为了方便读取,就没有必要额外给写入路径加一道隐性门槛。
可以怎么验证
排查视图属性时,可以直接查系统对象:
SELECT OBJECTPROPERTY(OBJECT_ID('v_active_user'), 'IsSchemaBound')返回 1 表示该视图已经绑定 schema。
SELECT is_updatable FROM sys.views WHERE name = 'v_active_user'这条语句可以用来检查视图是否支持更新,从而辅助判断当前定义是否把读写边界搞得过于复杂。
视图慢不慢,关键看底层查询和执行计划
视图本身不会自动优化查询,它本质上只是对一段 SELECT 的封装。因此,一旦性能变差,优先检查的不是“视图是不是有问题”,而是底层 SQL 有没有写出让优化器难以利用索引的表达式,或者是不是叠了太多层视图。
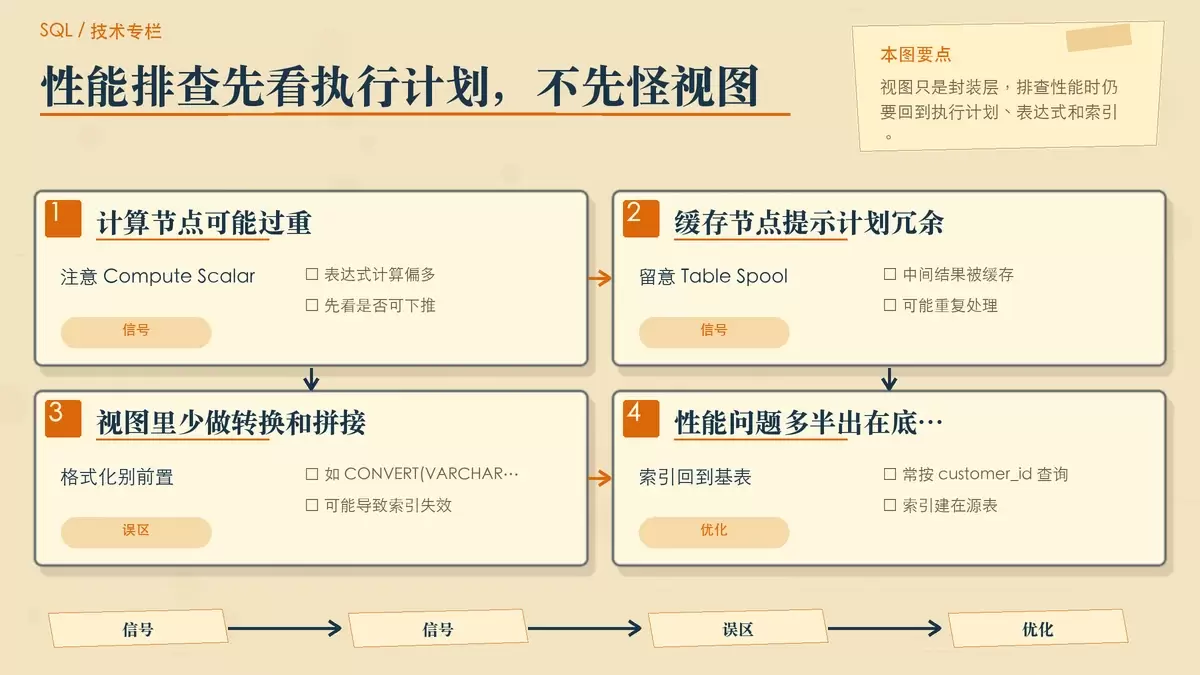
例如在视图里对日期字段使用 CONVERT(VARCHAR, order_date, 120),就可能让相关索引失效。再比如多层嵌套视图虽然组织上整齐,但执行阶段可能引入额外计算,最终让计划变得更重。
先看哪两个信号
可以直接打开执行计划检查关键节点:
SET STATISTICS XML ONSELECT TOP 10 * FROM v_sales_summaryCompute Scalar:通常意味着发生了较多表达式计算Table Spool:通常表示中间结果被缓存、复用或重复处理
这两个节点不一定绝对错误,但如果在简单查询里频繁出现,就值得回头审查视图定义。
常见优化方向
- 避免在视图中做格式化和字符串拼接
- 尽量不要把窗口函数
OVER()放进通用视图层,除非业务场景非常固定 - 聚合视图如果必须存在,要确认
GROUP BY相关字段具备合适索引
如果系统常按 customer_id 查询订单汇总,那么索引就该建在源表,而不是指望视图层“兜底”:
INDEX IX_orders_cid ON orders(customer_id)从这个角度看,视图更像是一层结构组织,而不是性能补丁。真正影响执行效率的,仍然是源表设计、索引策略和表达式写法。
写在最后:把视图当结构层,而不是万能封装层
SQL Server 2019 中的视图适合做的是统一字段、整理连接关系、收敛重复查询;不适合把动态过滤、格式化输出和复杂业务判断一股脑塞进去。只要记住几个核心原则:对象名带完整 schema、生产环境优先使用 WITH SCHEMABINDING、过滤条件尽量放到外层、性能问题回到执行计划和源表索引上排查,视图就能真正成为稳定的结构层,而不是后期难以维护的隐患来源。















