


数据库数据仓库:Hive与Spark SQL生态

理解Hive与Spark SQL在数据仓库中的角色
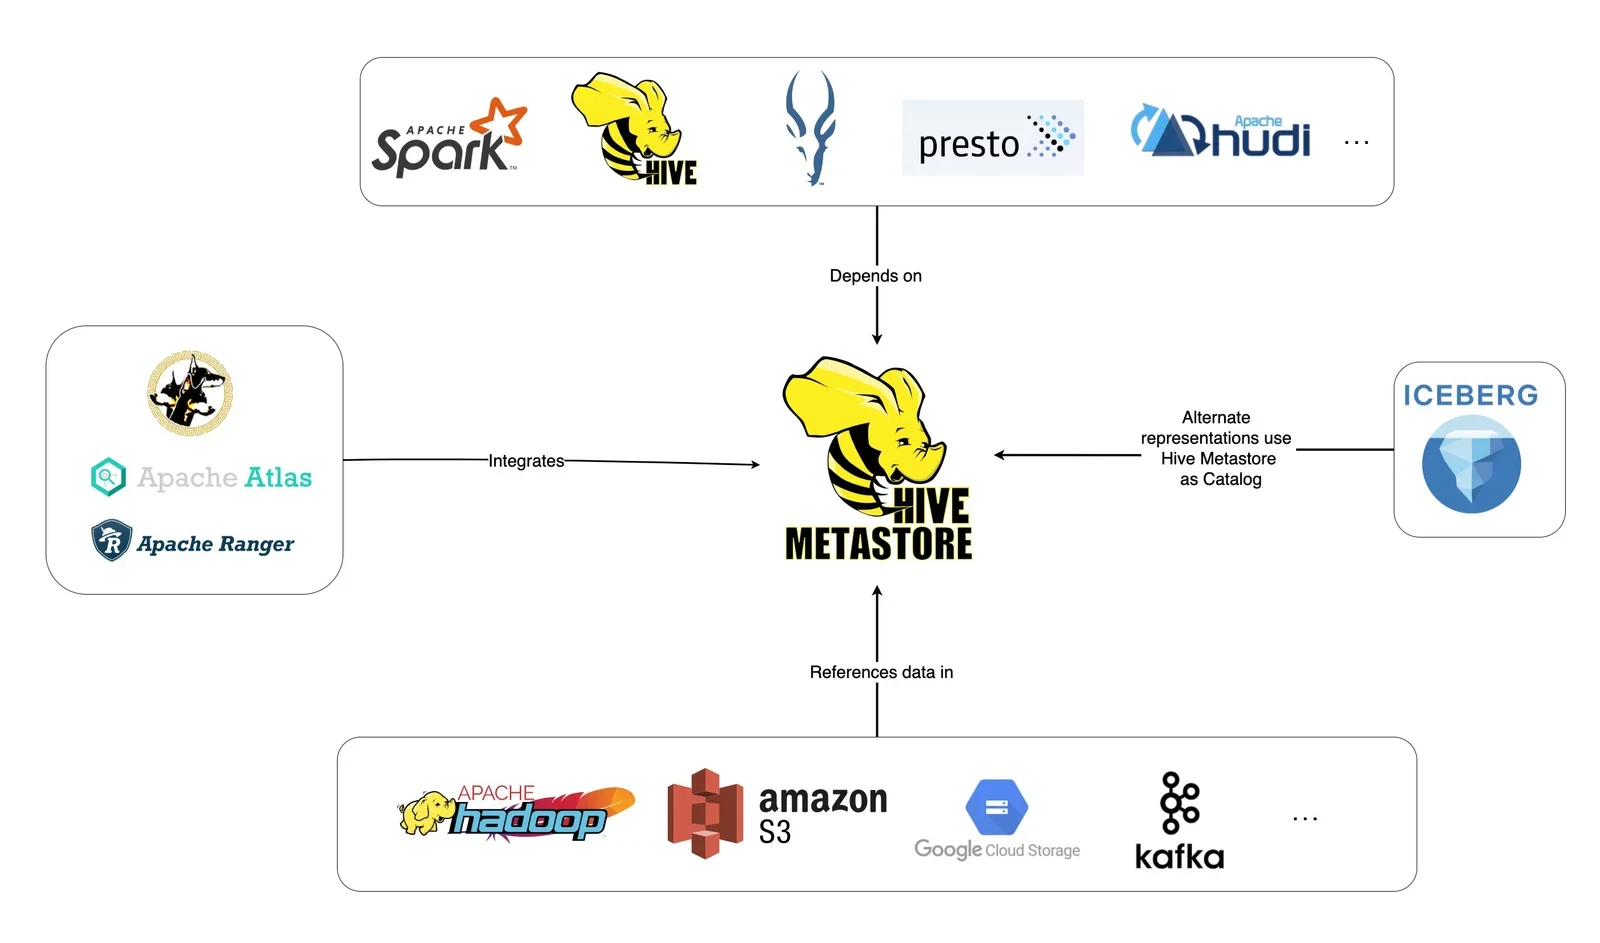
在典型的离线数据仓库架构中,HDFS、Metastore、Hive与Spark SQL各司其职且紧密协作。HDFS作为底层分布式文件系统,负责以块为单位持久化存储原始数据与计算结果;Metastore(通常基于关系型数据库)集中管理表结构、分区信息、列类型及数据路径等元数据,是连接存储与计算的目录服务。Hive本质上是一个基于Hadoop的数据仓库工具,它将SQL语句翻译为MapReduce或Tez任务,并深度依赖Metastore进行表生命周期管理与权限控制,擅长稳定、大批量的离线ETL调度。Spark SQL则是基于内存的分布式计算引擎,通过Catalyst优化器与Tungsten执行引擎提供极高的查询吞吐,它本身不管理元数据,而是通过Hive Metastore接口直接读取表定义与数据位置。在实际数仓分层中,Hive通常承担数据接入、清洗建模与元数据维护的管理中枢角色,而Spark SQL则作为计算加速层,负责复杂聚合、多维分析与交互式查询,两者通过共享HDFS数据与Metastore元数据实现无缝协同。
创建Hive表并完成数据导入与查询
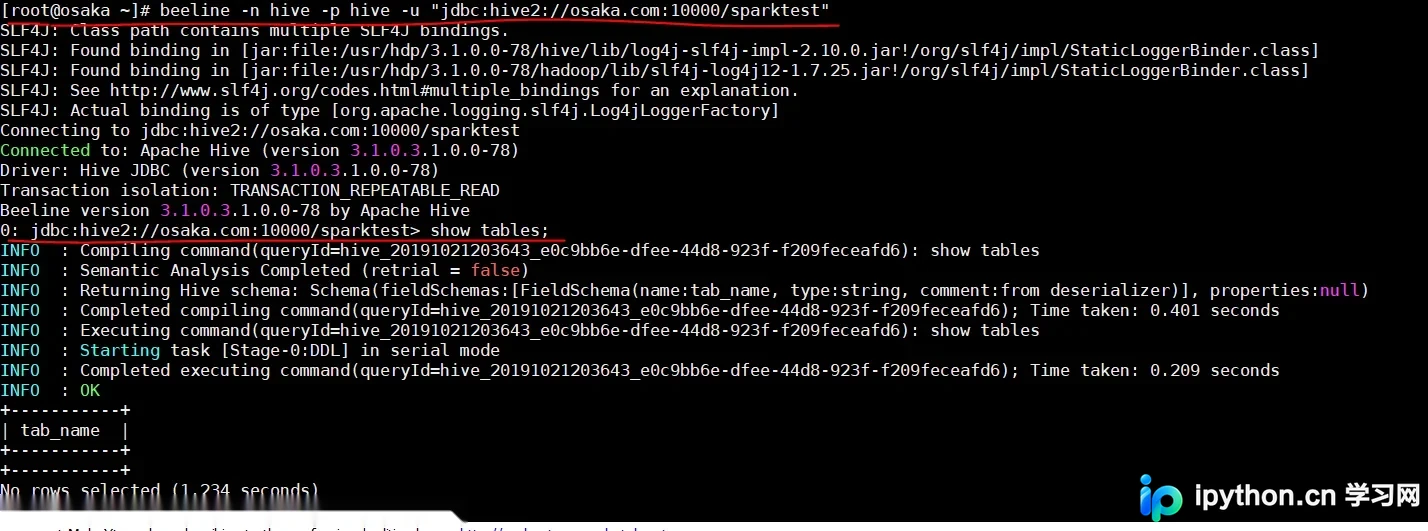
在Hive中构建数据仓库模型时,需严格遵循数据库与表的设计规范。首先通过CREATE DATABASE IF NOT EXISTS dw_ods;创建业务库。针对日志类数据,推荐采用外部表与分区表结合的设计:CREATE EXTERNAL TABLE dw_ods.user_logs (user_id STRING, action STRING, ts BIGINT) PARTITIONED BY (dt STRING) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t' STORED AS TEXTFILE LOCATION '/data/ods/user_logs';。外部表在删除表时仅移除元数据,保留HDFS上的物理文件,避免误删导致数据丢失;分区表则按时间或业务维度切分数据,大幅减少全表扫描开销。数据导入可通过LOAD DATA INPATH '/tmp/logs/20231001.log' INTO TABLE dw_ods.user_logs PARTITION (dt='2023-10-01');完成,该操作实质是HDFS文件的移动或复制。查询时务必带上分区条件,如SELECT user_id, COUNT(1) AS cnt FROM dw_ods.user_logs WHERE dt='2023-10-01' GROUP BY user_id;,以触发分区裁剪。若需处理历史数据,可结合INSERT OVERWRITE进行全量覆盖,或使用ALTER TABLE ADD PARTITION动态注册新分区,确保数仓建模的规范性与可维护性。
用Spark SQL读取Hive表并执行分布式计算
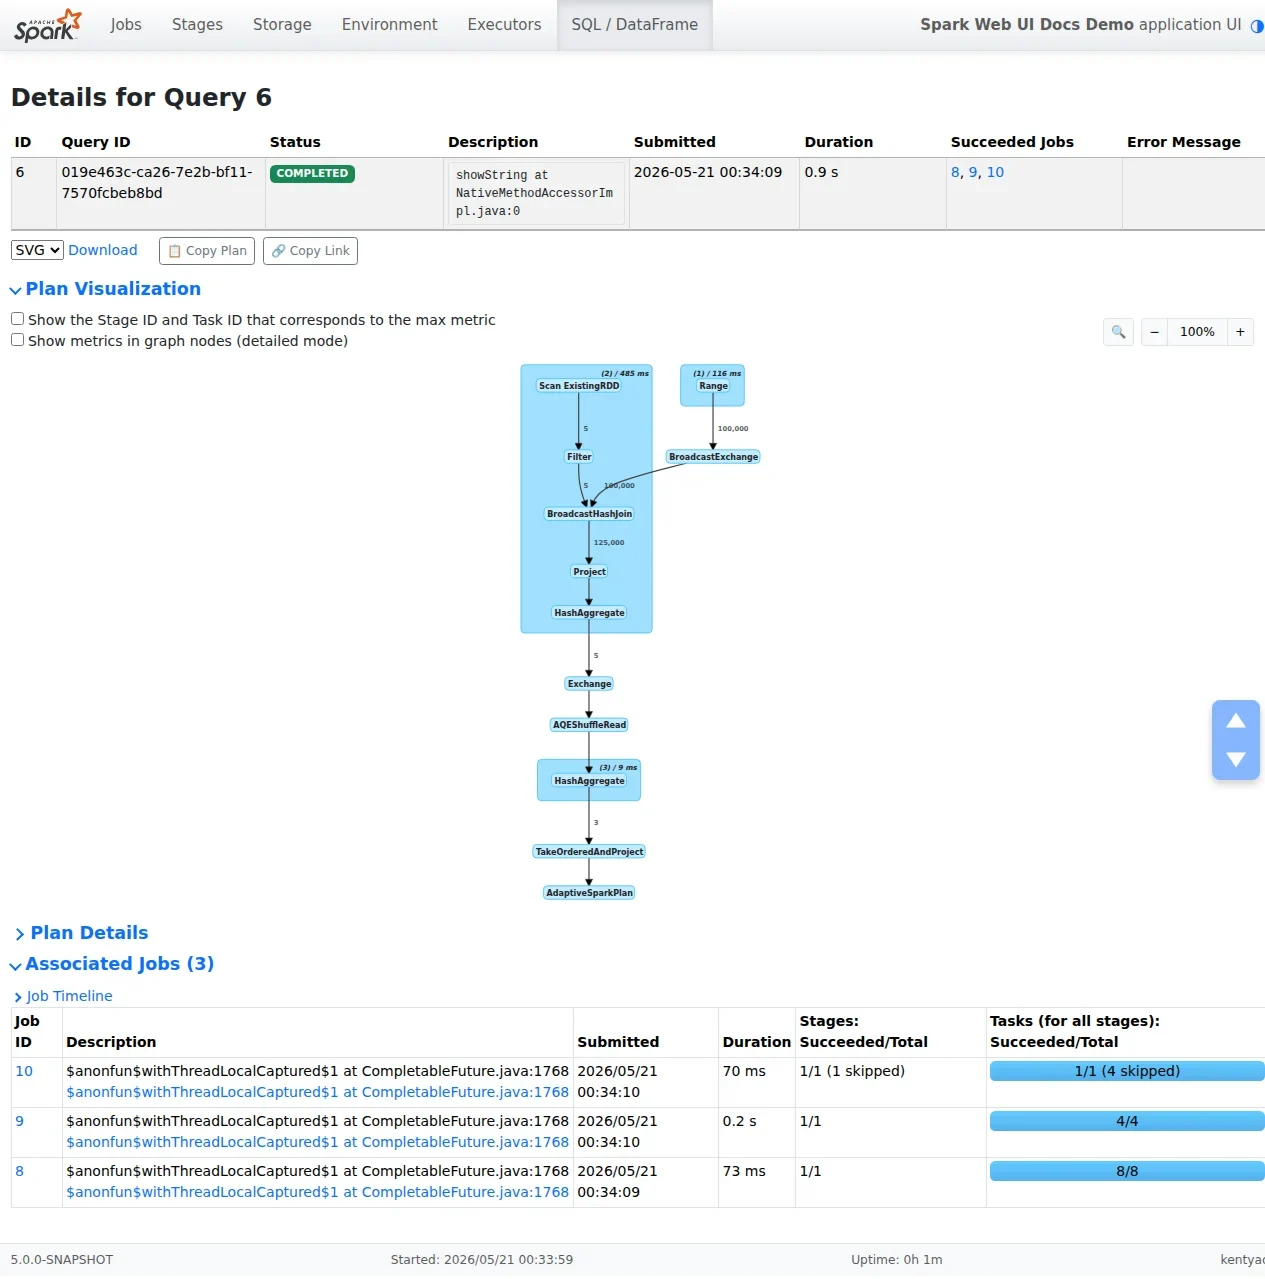
Spark SQL与Hive的集成核心在于共享Metastore与兼容Hive SQL语法。在Spark作业启动时,需通过spark.sql.warehouse.dir指定Hive数仓根目录,并通过hive.metastore.uris指向Metastore服务地址。配置完成后,SparkSession即可直接读取Hive表:val df = spark.sql("SELECT user_id, action FROM dw_ods.user_logs WHERE dt='2023-10-01'")。Spark SQL底层会将HiveQL解析为逻辑计划,经Catalyst优化器进行谓词下推、列裁剪与Join重排序,最终生成物理执行计划并转化为RDD DAG。在DataFrame API中,同样支持spark.read.table("dw_ods.user_logs").filter($"dt" === "2023-10-01")的链式操作。任务提交流程通常通过spark-submit提交至YARN集群,Driver负责协调Executor并行读取HDFS数据块。由于Spark SQL默认启用向量化执行与内存缓存,其执行速度通常远超Hive MR引擎,但在处理超大规模历史全量扫描时,仍需注意内存溢出风险与Shuffle阶段的网络开销。
验证Hive与Spark SQL的数据读写和结果一致性
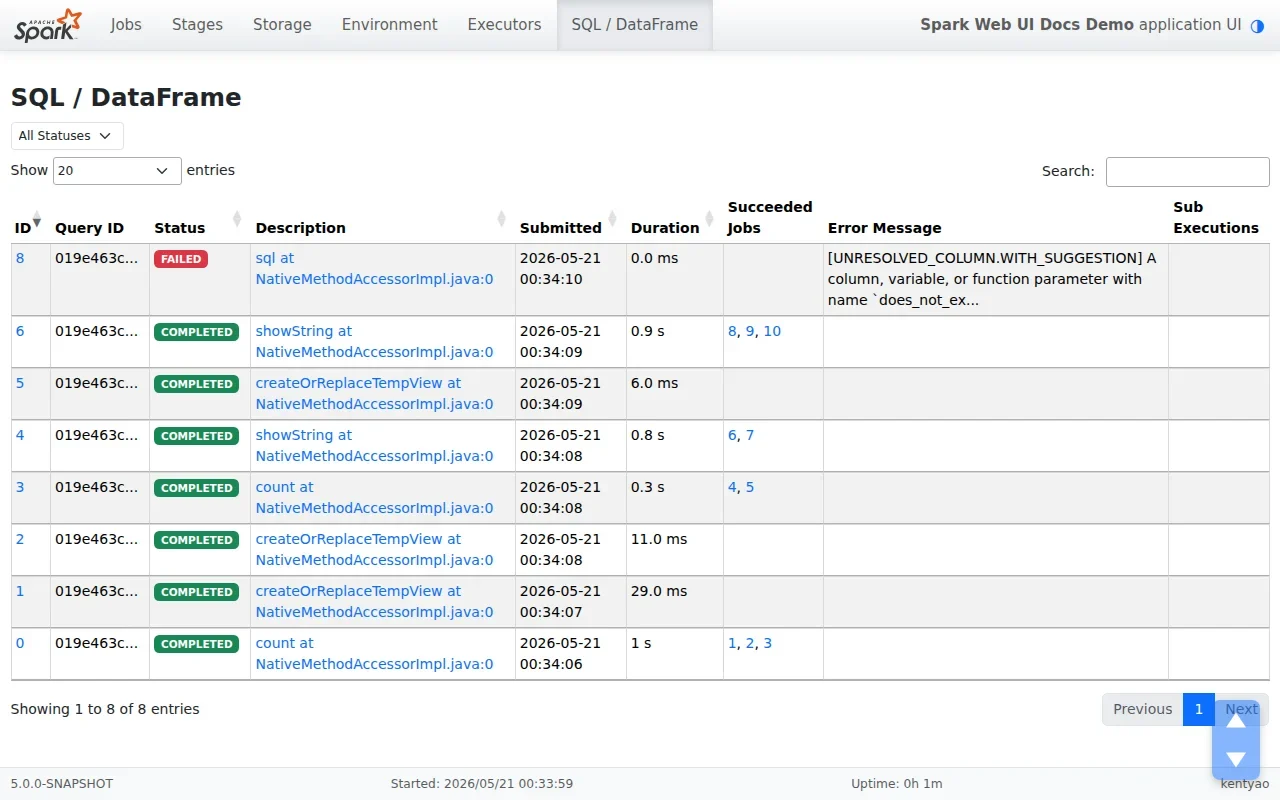
验证Hive与Spark SQL的数据一致性是保障数仓质量的关键环节。实际操作中,可针对同一张分区表分别执行COUNT(*)、SUM聚合及按分区过滤的查询,对比两者返回的记录数与数值结果。若发现差异,首先检查Metastore元数据是否同步,Hive中新增分区后Spark可能因缓存未刷新而遗漏,此时需在Spark侧执行spark.catalog.refreshTable或在Hive侧执行MSCK REPAIR TABLE。其次,核对HDFS底层数据文件路径与格式是否一致,确认无脏数据或重复写入。常见故障排查路径包括:检查时区与时间戳解析差异,验证SerDe序列化配置是否兼容,确认计算引擎是否因空值处理逻辑不同导致聚合偏差。通过编写自动化校验脚本,定期比对关键指标并输出差异报告,可有效建立数据血缘与质量监控闭环,确保离线数仓输出结果的可靠性。
性能优化与常见避坑
离线数仓性能优化需围绕存储、计算与调度三个维度展开。存储层强烈建议采用列式格式配合Snappy或ZSTD压缩,可显著降低I/O并提升谓词下推效率;同时必须落实分区裁剪,避免全表扫描。计算层需重点治理小文件问题,Hive可通过配置合并输出,Spark则需调整spark.sql.files.maxPartitionBytes或使用DISTRIBUTE BY控制Shuffle分区数。针对数据倾斜,可开启spark.sql.adaptive.enabled启用AQE自动优化,或对倾斜Key加盐打散后二次聚合。在引擎选型上,Hive适合高吞吐、低内存占用的稳定批处理与复杂ETL调度;Spark SQL则更适合交互式分析、迭代计算与内存充足的场景。实际优化时,可通过EXPLAIN查看执行计划,确认Join策略与Stage划分是否合理,并结合Web UI监控Task倾斜与GC耗时,形成分析、调参、验证的闭环实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















