


MySQL字符集:utf8mb4与emoji兼容

理解MySQL字符集与utf8mb4的emoji支持机制
在MySQL中,字符集决定了数据在磁盘上的存储编码方式,而排序规则则定义了字符比较与排序的逻辑。早期MySQL版本中的utf8字符集实际上仅支持最多3字节的UTF-8编码,无法容纳需要4字节存储的Emoji表情及部分生僻汉字。当尝试插入这类字符时,系统会直接截断或报错。utf8mb4是MySQL对标准UTF-8的完整实现,支持1至4字节的变长编码,能够无损存储所有Unicode字符。在实际开发中,推荐将character_set_server与collation_server统一设置为utf8mb4与utf8mb4_unicode_ci或utf8mb4_0900_ai_ci,以确保底层存储与排序行为符合现代多语言及富文本需求。通过执行SHOW VARIABLES LIKE 'character_set_%';可直观查看当前环境的字符集配置状态。
配置数据库、表和字段使用utf8mb4
建立一致的字符集环境需从数据库、表到字段逐级明确指定。创建数据库时应使用CREATE DATABASE app_db DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;。建表时同样需显式声明,例如CREATE TABLE user_profile (id INT PRIMARY KEY, nickname VARCHAR(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci) DEFAULT CHARSET=utf8mb4;。若已有表使用旧字符集,可通过ALTER TABLE user_profile CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;进行无损转换,该命令会重建表结构并自动转换存量数据。务必避免在同一张表中混用utf8与utf8mb4字段,否则在跨字段关联或联合查询时极易引发隐式转换失败或排序异常。转换前建议备份数据,并在低峰期执行以避免锁表影响业务。
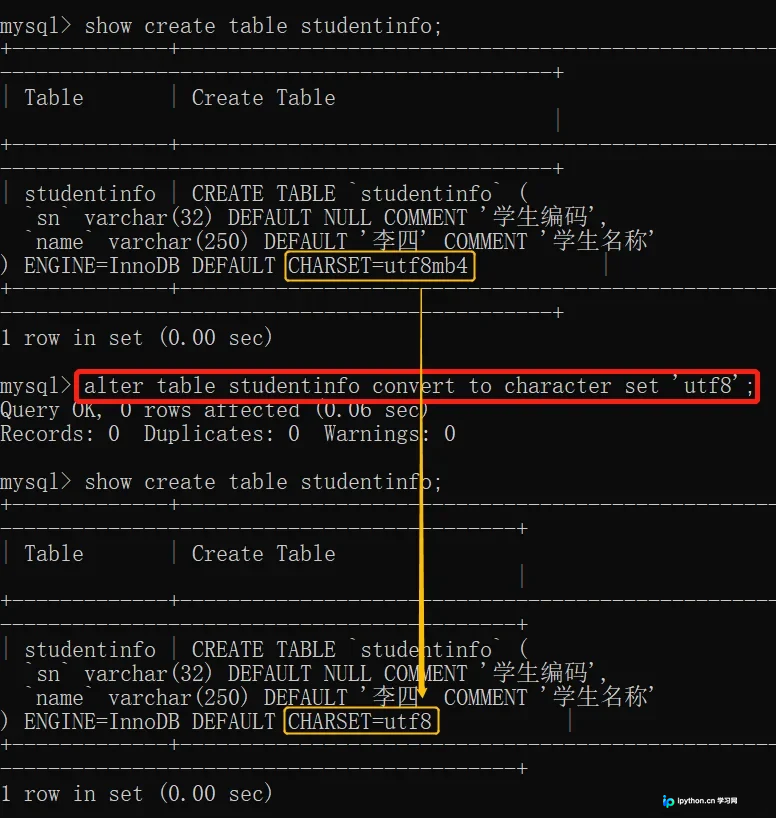
配置客户端连接并验证emoji完整存储
即使服务端与表结构已配置为utf8mb4,若客户端连接未正确声明字符集,仍会导致数据在传输过程中被错误转码。在JDBC连接串中需追加characterEncoding=utf8mb4,或使用SET NAMES utf8mb4;初始化会话。验证完整链路时,可执行插入语句:INSERT INTO user_profile (nickname) VALUES ('测试🚀');,随后通过SELECT nickname, LENGTH(nickname), CHAR_LENGTH(nickname) FROM user_profile;进行核对。CHAR_LENGTH返回字符数(此处为3),而LENGTH返回字节数(UTF-8下中文占3字节,🚀占4字节,合计应为10字节)。若两者符合预期且查询结果正常显示Emoji,则证明从应用层、网络传输到MySQL存储的编码链路已完全打通。
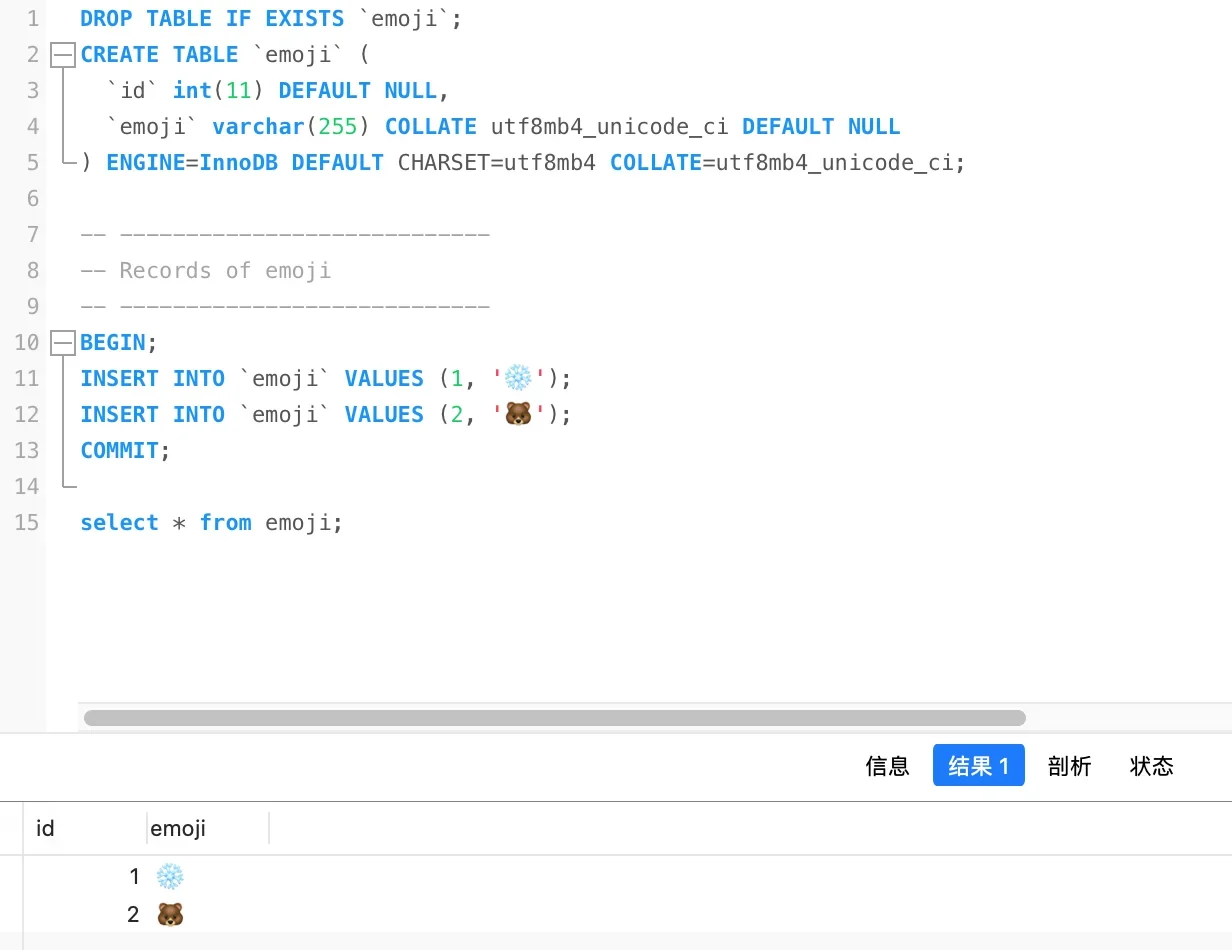
排查utf8mb4乱码与emoji保存失败
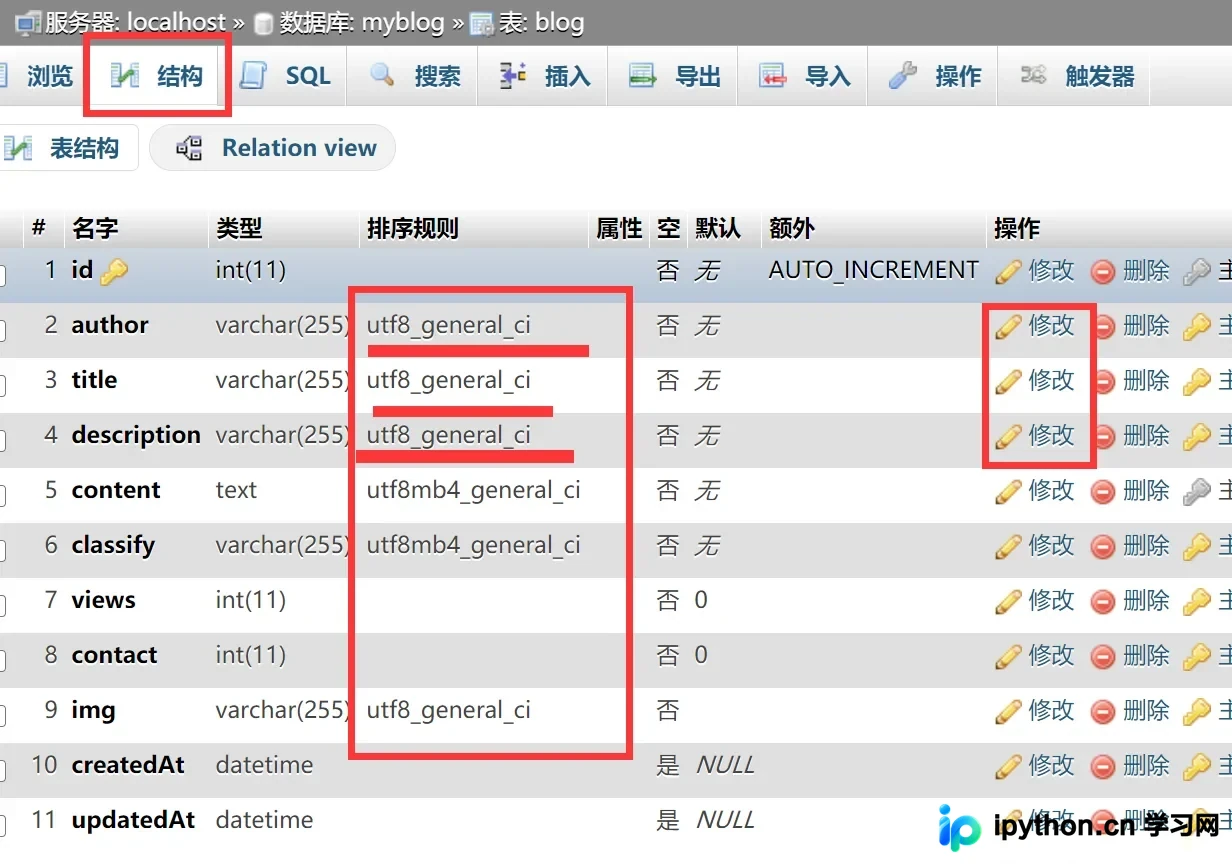
遇到Incorrect string value报错时,通常意味着字段仍为3字节utf8或连接字符集不匹配。排查第一步是执行SHOW CREATE TABLE user_profile\G,确认字段定义是否包含CHARACTER SET utf8mb4。第二步运行SHOW VARIABLES LIKE '%character%';与SHOW VARIABLES LIKE '%collation%';,核对character_set_client、character_set_connection与character_set_results是否均为utf8mb4。若出现中文显示为问号或乱码,多为客户端终端编码与MySQL返回编码不一致所致,可尝试调整终端编码设置或检查应用层序列化配置。此外,排序规则混用会导致JOIN查询报Illegal mix of collations错误,需通过ALTER TABLE统一修改为同一种规则,确保全链路字符集与排序规则严格一致。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















