


数据库消息中间件:RabbitMQ与Kafka吞吐量

理解RabbitMQ与Kafka吞吐量差异的核心机制
RabbitMQ基于AMQP协议,采用Exchange与Queue的路由模型,消息在内存中流转并可选择性落盘,消费端通过Push模式配合预取机制获取数据。其并发模型依赖单队列内的锁竞争与上下文切换,适合低延迟与复杂路由场景。Kafka则采用日志追加的存储模型,以Topic和Partition为核心,依赖操作系统的Page Cache与顺序磁盘I/O实现高吞吐。消费端采用Pull模式,支持多消费者并行拉取不同分区。两者差异的核心在于:RabbitMQ为每条消息提供精细的路由与确认,但锁开销与随机I/O限制了极限吞吐;Kafka通过批量追加、零拷贝与分区并行化,牺牲了单条消息的极低延迟,换取了海量数据的线性吞吐能力。评估时需明确三大指标:吞吐量(单位时间处理消息数或字节数)、延迟(消息从生产到消费的耗时)与可靠性(消息不丢失、不重复的机制保障)。
搭建统一的吞吐量压测环境与测试场景
搭建统一压测环境需严格控制变量。硬件层面建议采用相同配置的Linux服务器(如8核16G内存、NVMe SSD),部署单节点RabbitMQ与Kafka集群。测试工具分别选用官方推荐的rabbitmq-perf-test与kafka-producer-perf-test。关键变量需对齐:消息体大小设定为1KB、10KB与100KB三档;生产者与消费者线程数均固定为4;RabbitMQ队列设置为durable=true,Kafka主题配置6个分区且副本因子为1。确认机制方面,RabbitMQ启用Publisher Confirm,Kafka设置acks=1以平衡吞吐与可靠性。测试场景分为三类:纯生产压测(仅统计发送速率)、纯消费压测(预置数据后仅拉取)与端到端压测(生产与消费同时运行,统计完整链路延迟)。所有脚本需通过环境变量注入参数,确保每次执行可复现,并记录初始基线数据。
实测RabbitMQ与Kafka吞吐量并分析结果
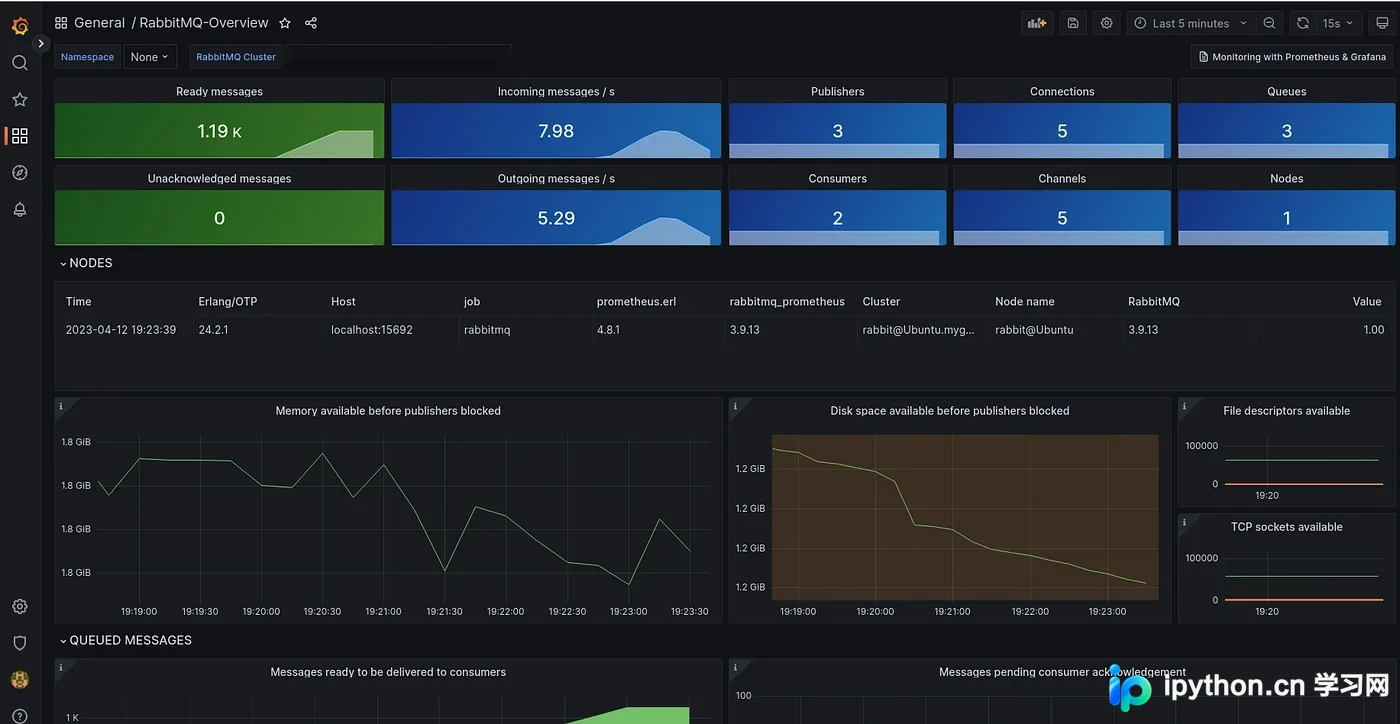
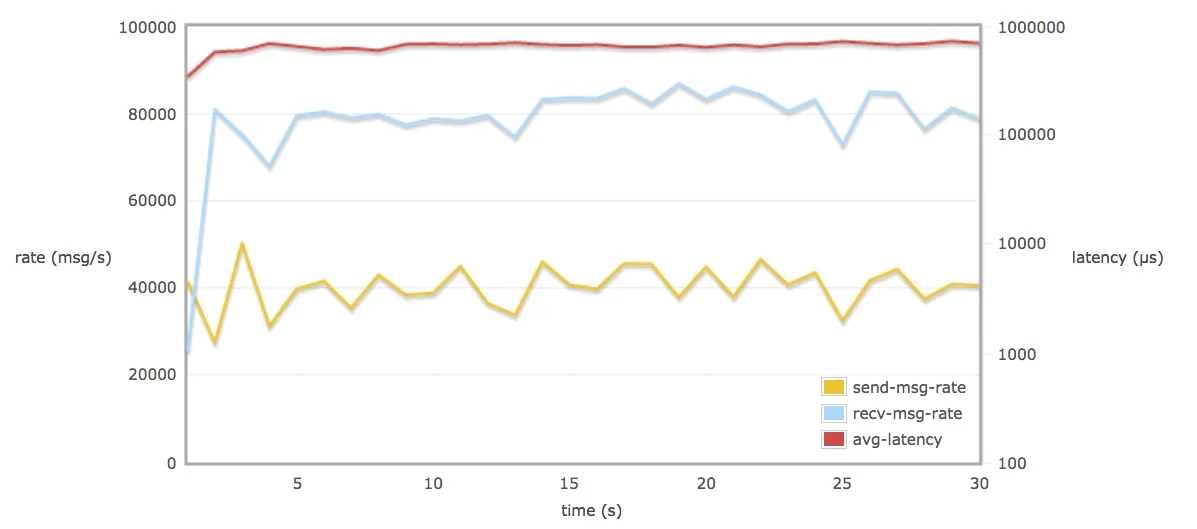
执行压测时,需通过系统监控工具与中间件内置指标同步采集数据。使用iostat监控磁盘I/O利用率与await延迟,top观察CPU用户态与系统态占比,vmstat跟踪内存与上下文切换。RabbitMQ可通过Management UI获取队列深度与确认速率;Kafka则依赖JMX导出BrokerTopicMetrics等指标。实测对比显示:在1KB小消息场景下,RabbitMQ因内存处理优势延迟稳定在毫秒级,但吞吐受限于单队列锁;当消息增至100KB且开启批量发送时,Kafka的顺序写入与零拷贝机制使其吞吐显著跃升,CPU主要消耗在序列化与网络传输,磁盘I/O保持平稳。若开启强持久化,两者吞吐均会下降,但Kafka凭借Page Cache与批量落盘策略,衰减幅度相对可控。分析时需绘制吞吐曲线与延迟P99分布,避免仅看峰值而忽略长尾效应。
调优吞吐量:生产、消费与中间件关键参数
吞吐量调优需遵循先架构后参数、先批量后确认的顺序。Kafka侧:首先增加num.partitions以匹配消费者并发度;其次调整生产者batch.size与linger.ms以聚合请求;启用compression.type=snappy降低网络与磁盘带宽压力;消费者端调大fetch.min.bytes与max.poll.records减少拉取频次。RabbitMQ侧:合理设置prefetch_count(建议100至500),避免单条确认导致的频繁网络往返;启用Publisher Confirm的异步批量模式;针对大流量场景配置x-queue-mode=lazy将消息直接落盘,减轻内存压力;关闭非必要的镜像队列以降低同步开销。验证方法为:每次仅调整单一参数组,运行标准化压测脚本,观察吞吐曲线是否趋于平稳且延迟未突破业务阈值,最终形成参数基线。
吞吐量压测避坑与选型结论
压测避坑需警惕五大误区:一是硬件环境不一致导致结果失真;二是未统一消息大小,误将大文件传输与文本指令对比;三是确认机制不对等,如将RabbitMQ异步确认与Kafka同步刷盘直接比较;四是仅测试生产端吞吐量,忽略消费端积压与反压能力;五是忽视数据可靠性,在追求极限吞吐时关闭持久化或ACK,导致压测结果脱离生产实际。选型结论应基于业务特征:若场景为日志采集、指标上报、实时数仓等海量数据流,且容忍秒级延迟,Kafka凭借高吞吐与生态优势是首选;若业务涉及订单状态流转、支付通知、复杂路由匹配,要求严格的消息顺序、事务支持与毫秒级响应,RabbitMQ的AMQP模型与灵活队列机制更为契合。最终决策需综合吞吐量、延迟、可靠性与运维成本,避免单一指标导向。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















