


数据库跨云迁移:在线迁移与停机窗口规划

评估跨云迁移方案与停机窗口
在启动跨云数据库迁移前,必须对源端与目标端环境进行深度盘点。需明确双方数据库的具体版本、内核参数、实例规格及底层存储类型,确保目标云环境完全兼容源端特性。同时,通过专线或云企业网建立跨云网络连通性,并评估带宽是否满足数据同步需求。结合业务历史监控数据,统计总数据量、日均增量及业务访问峰值时段。在此基础上,对比全量停机迁移与在线增量同步方案:若业务允许较长中断且数据量较小,可采用全量迁移;若要求高可用,则需采用基于日志解析的在线迁移。最终依据业务定义的RPO与RTO,结合业务低峰期划定可接受的停机窗口,并预留至少百分之三十的缓冲时间以应对突发状况。
完成全量迁移与在线增量同步
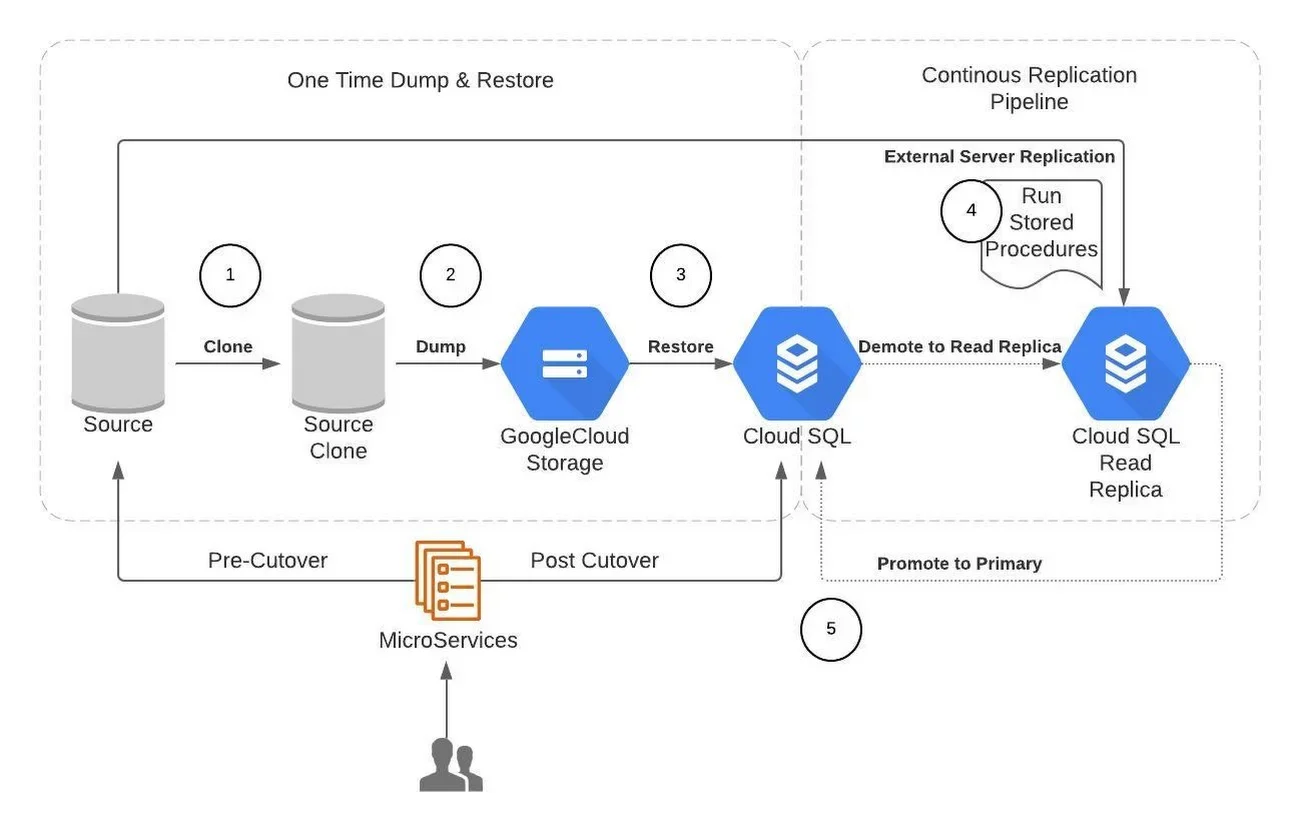
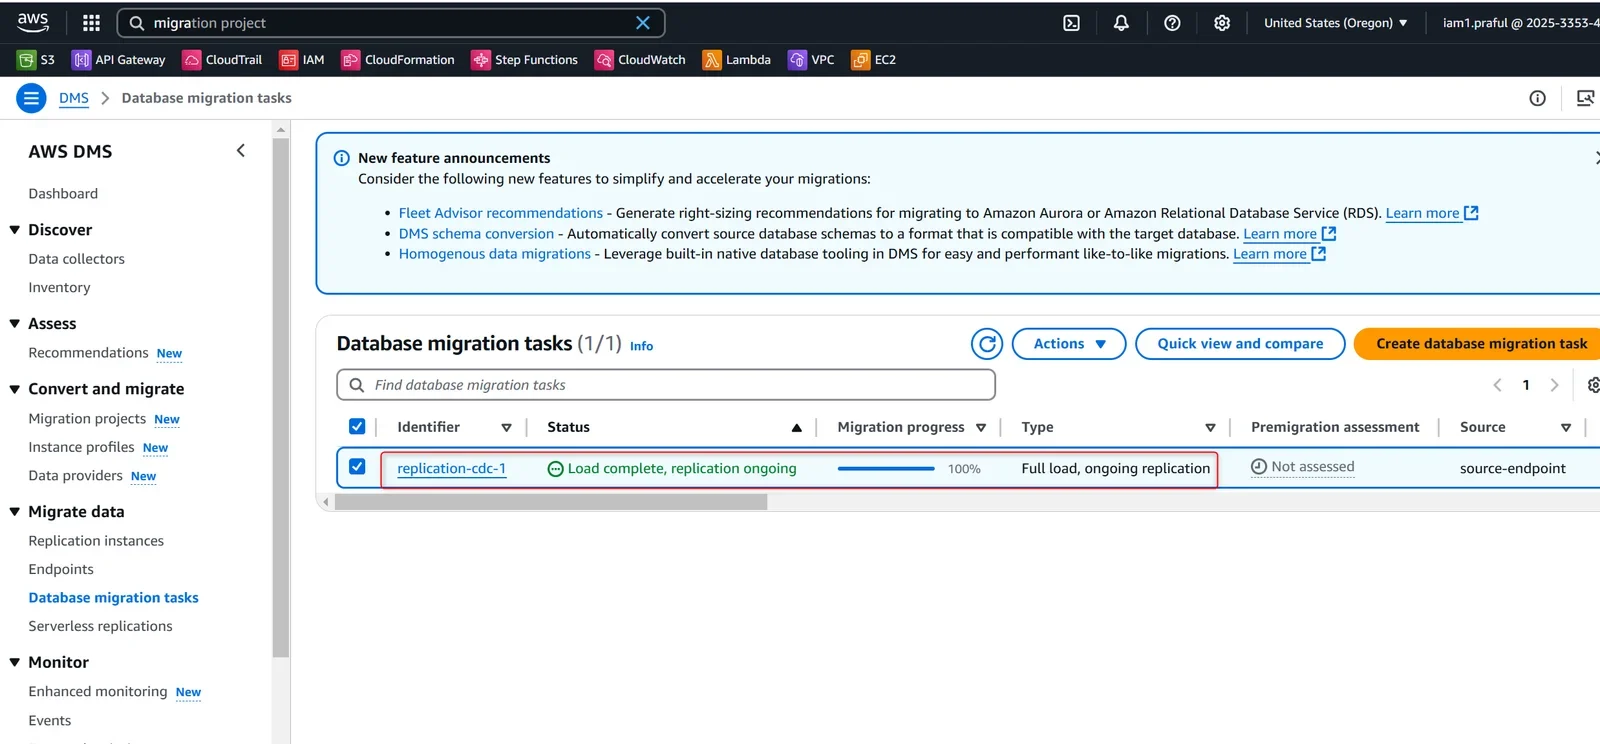
在线迁移的核心流程遵循先全量后增量的原则。首先,在源库创建具备只读权限的专用复制账号,配置跨云安全组与白名单,确保网络链路稳定。启动全量数据导出与导入任务,期间源库保持正常读写,业务无感知。全量完成后,迁移工具自动切换至增量同步阶段,通过解析源库的Binlog或WAL日志,实时捕获并回放数据变更。运维人员需持续监控同步延迟指标,通常要求延迟控制在秒级以内。在此阶段,必须定期执行数据一致性校验,例如通过抽样比对主键范围或计算关键表的校验和。需特别注意,源库在迁移期间仍承载线上流量,应避免执行大事务或DDL操作,防止日志堆积导致同步链路中断或延迟飙升。
执行停机切换与最小化业务中断
停机切换是迁移过程中风险最高的环节,需严格按步骤执行以最小化中断。第一步,在业务低峰期通过应用层开关或数据库只读模式冻结源库写入,确保无新数据产生。第二步,观察增量同步延迟直至归零,确认目标库数据完全追平。第三步,执行关键数据校验,核对订单、账户等核心表记录数与金额汇总。第四步,批量切换应用数据库连接字符串,指向目标云实例,并重启或刷新应用连接池以释放旧连接。第五步,逐步放开业务流量并观察系统状态。切换延迟常由DNS缓存未刷新、连接池未释放、缓存未预热或源库存在未提交长事务引起。可通过强制刷新DNS、提前预热缓存、设置连接池快速失效策略及主动清理长事务来压缩停机时间。
验证迁移结果并准备回滚
切换完成后,需从多维度验证迁移结果并制定回滚预案。数据完整性方面,执行全量比对脚本验证表结构、索引及数据行数;业务功能方面,通过自动化测试用例覆盖核心交易链路,确认读写正常;性能方面,对比迁移前后的吞吐量、慢查询比例及资源水位,确保目标库规格满足负载要求;同时监控应用连接数与错误率,排查因网络抖动或参数差异导致的异常。设定明确的成功判定标准,如连续三十分钟无核心报错且延迟低于阈值。若验证未达标,立即触发回滚:将应用连接切回源库,利用源库保留的增量日志或快照恢复数据。旧库需至少保留七天,期间保持只读并定期备份,确保异常情况下可快速恢复业务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















