



很多人讨论 COUNT(*)、COUNT(1) 和 COUNT(列名) 时,先想到的是性能,但真正决定写法是否正确的,首先是统计语义。本文把几种常见写法拆开说明,再结合 MySQL InnoDB 的执行特点和 JOIN 场景,帮你判断什么时候该数“行”,什么时候该数“非 NULL 值”,以及哪些写法会让结果悄悄跑偏。
COUNT(*) 和 COUNT(列名) 统计的不是一回事
COUNT(*) 统计的是结果集中有多少行存在,COUNT(列名) 统计的是该列中有多少个非 NULL 的值。这是本质区别,不是代码风格之争。
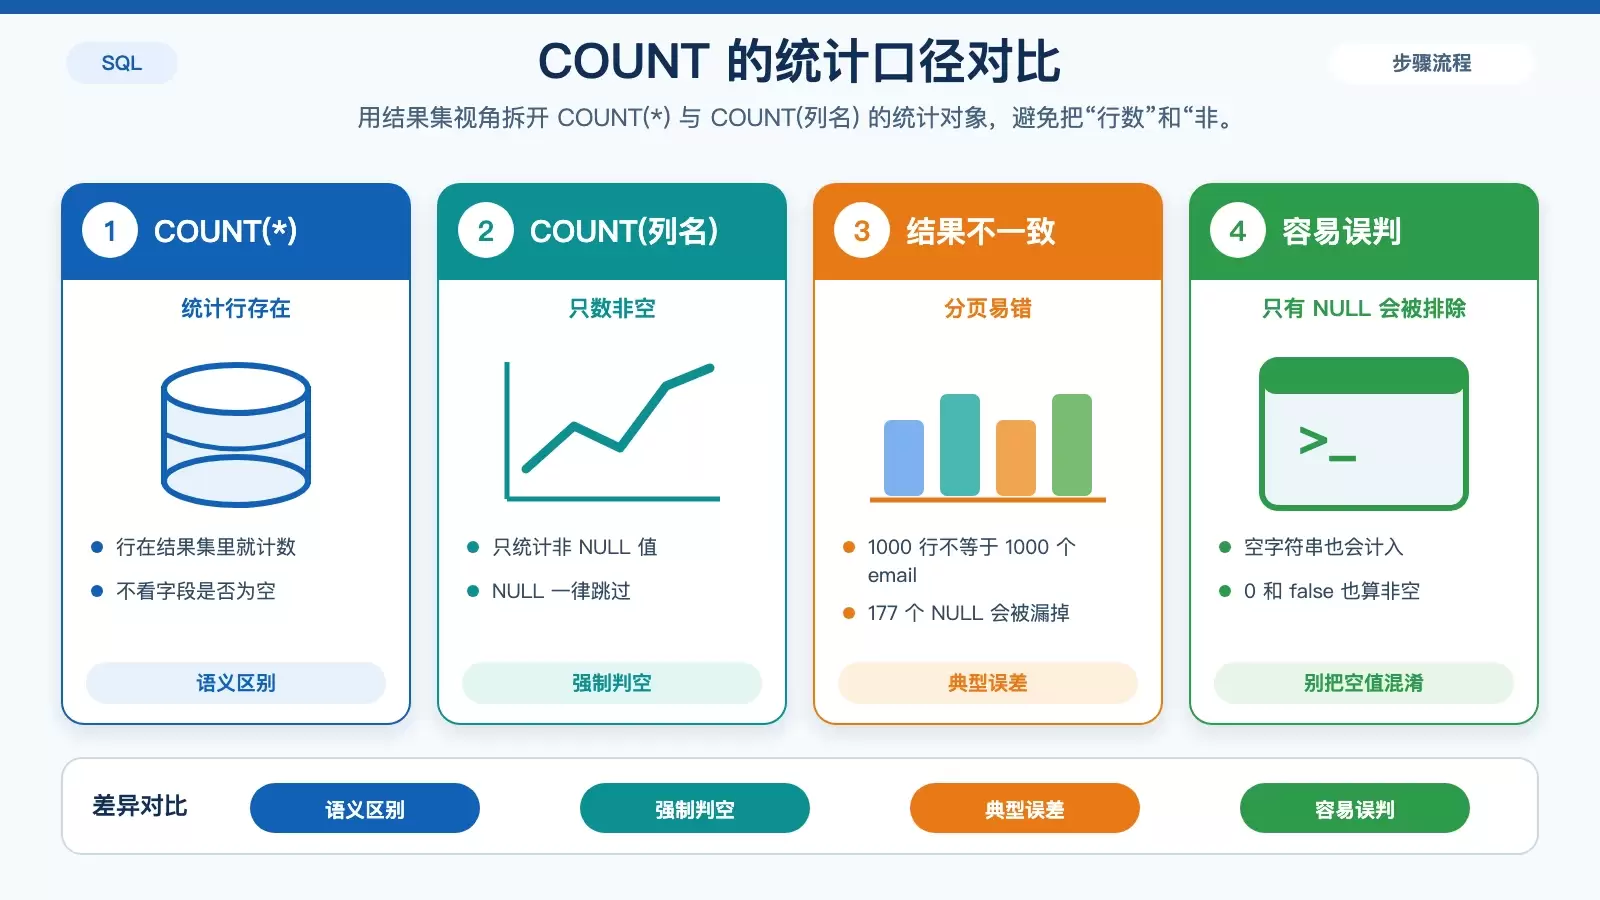
只要一行记录经过 WHERE、JOIN 或子查询之后仍然保留在结果集中,COUNT(*) 就会把它计为 1。哪怕这一行里所有字段都是 NULL,只要行存在,就会被统计进去。
而 COUNT(列名) 不同,它必须逐行判断该列的值是不是 NULL。只有非 NULL 才会计入结果,这个判空逻辑不会因为索引、优化器或执行计划改变。
例如:
COUNT(*) = 1000
COUNT(email) = 823
这表示当前结果集中共有 1000 行,但其中只有 823 行的 email 不是 NULL,剩下 177 行会被 COUNT(email) 跳过。若你把后者拿去做分页总数或数据完整性校验,结论就会直接出错。
几个最常见的误判场景
- 以为
id是主键就一定不会是NULL。如果建表时没有加NOT NULL约束,或者插入数据时漏传、显式写入NULL,那么COUNT(id)就可能少算。 - 在
LEFT JOIN之后使用COUNT(users.name),本来想数“有多少订单关联了用户”,结果实际数到的是“关联到且name非空的用户记录数”,语义已经变了。 ''、0、false都会被COUNT(列名)计入,因为它们不是NULL。只有真正的NULL才会被跳过。
所以,先问清楚业务到底要什么结果:是“当前结果集有多少行”,还是“某一列有多少个有效值”。这一步比性能优化更重要。
性能差异来自约束和索引,不来自写法传说
在 MySQL InnoDB 8.0+ 中,COUNT(*) 在特定条件下确实有更直接的执行路径。若查询没有 WHERE、GROUP BY、HAVING,优化器通常会选择最小索引进行扫描,一般是主键索引,只遍历叶子节点,不需要回表,也不需要对具体字段值做解码。
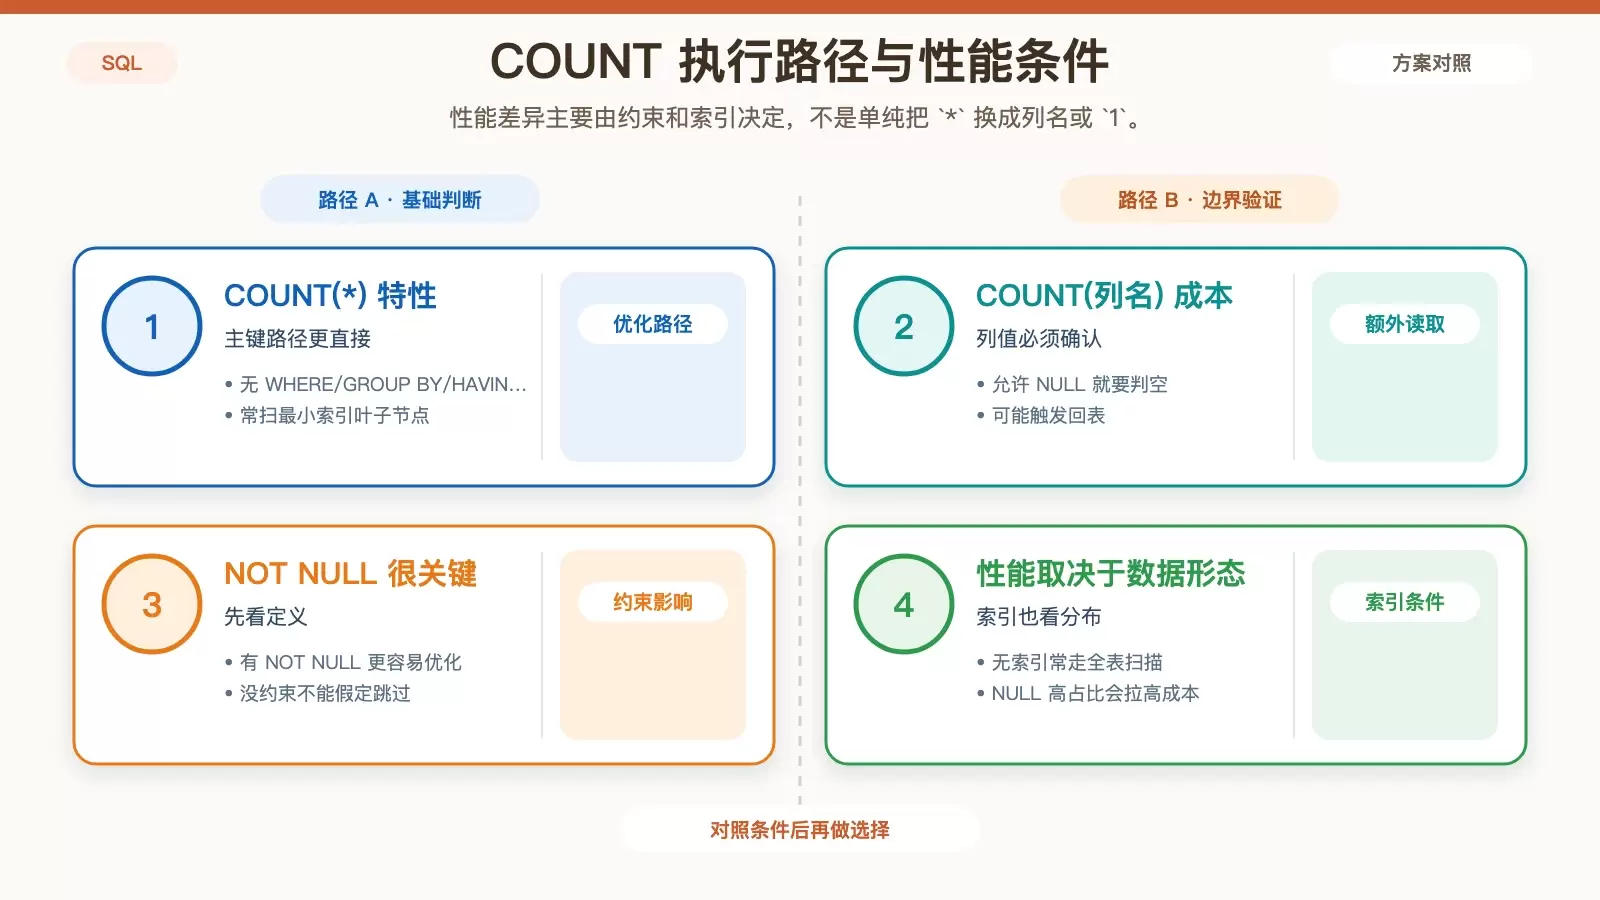
但 COUNT(列名) 不一样。即便这一列有索引,只要它允许出现 NULL,数据库就仍然需要确认每条记录的该列值是否为空。这个额外判断往往意味着要读取实际值,严重时会触发回表,甚至退化成全表扫描。
真正影响性能的几个条件
- 该列是否定义了
NOT NULL。如果没有这个约束,就不能假定数据库能跳过判空。 - 该列是否有索引。无索引且允许
NULL时,通常就要走全表扫描并读取列值。 NULL的占比是否很高。比如超过 50% 时,即使有索引,遍历这类列索引的成本也可能高于扫描主键索引,因为二级索引往往更宽、页更多。
因此,COUNT(*) 更快并不是一条放之四海皆准的结论,但在“无过滤条件的总行数统计”里,它通常更贴近数据库的优化路径。
COUNT(1) 和 COUNT(*) 基本等价,不必为了“更快”替换
关于 COUNT(1) 比 COUNT(*) 更快的说法,放在当前的 MySQL InnoDB 环境里已经没有现实意义。MySQL 明确将两者做同等优化,在执行计划上几乎一致,实际耗时差异通常只有 ±0.5ms,远小于缓冲池抖动带来的波动。
换句话说,把 COUNT(*) 改成 COUNT(1),通常不会带来可感知的收益。真正该盯住的是下面几件事:
- 业务要的是总行数,还是某列非空值数量。语义错了,执行再快也没有意义。
- 可以用
COUNT(*) - COUNT(列名)快速判断某列的NULL占比,再决定是否值得增加NOT NULL约束或索引。 - 当查询带有
WHERE条件时,能不能高效走索引,取决于过滤条件是否匹配合适的联合索引,而不是括号里写*还是1。
JOIN 之后再 COUNT,统计对象会继续变化
在连接查询里,很多误差并不是来自 COUNT 函数本身,而是来自结果集已经被连接操作改写。
例如这条语句:
SELECT COUNT(*)
FROM orders
LEFT JOIN users ON orders.user_id = users.id
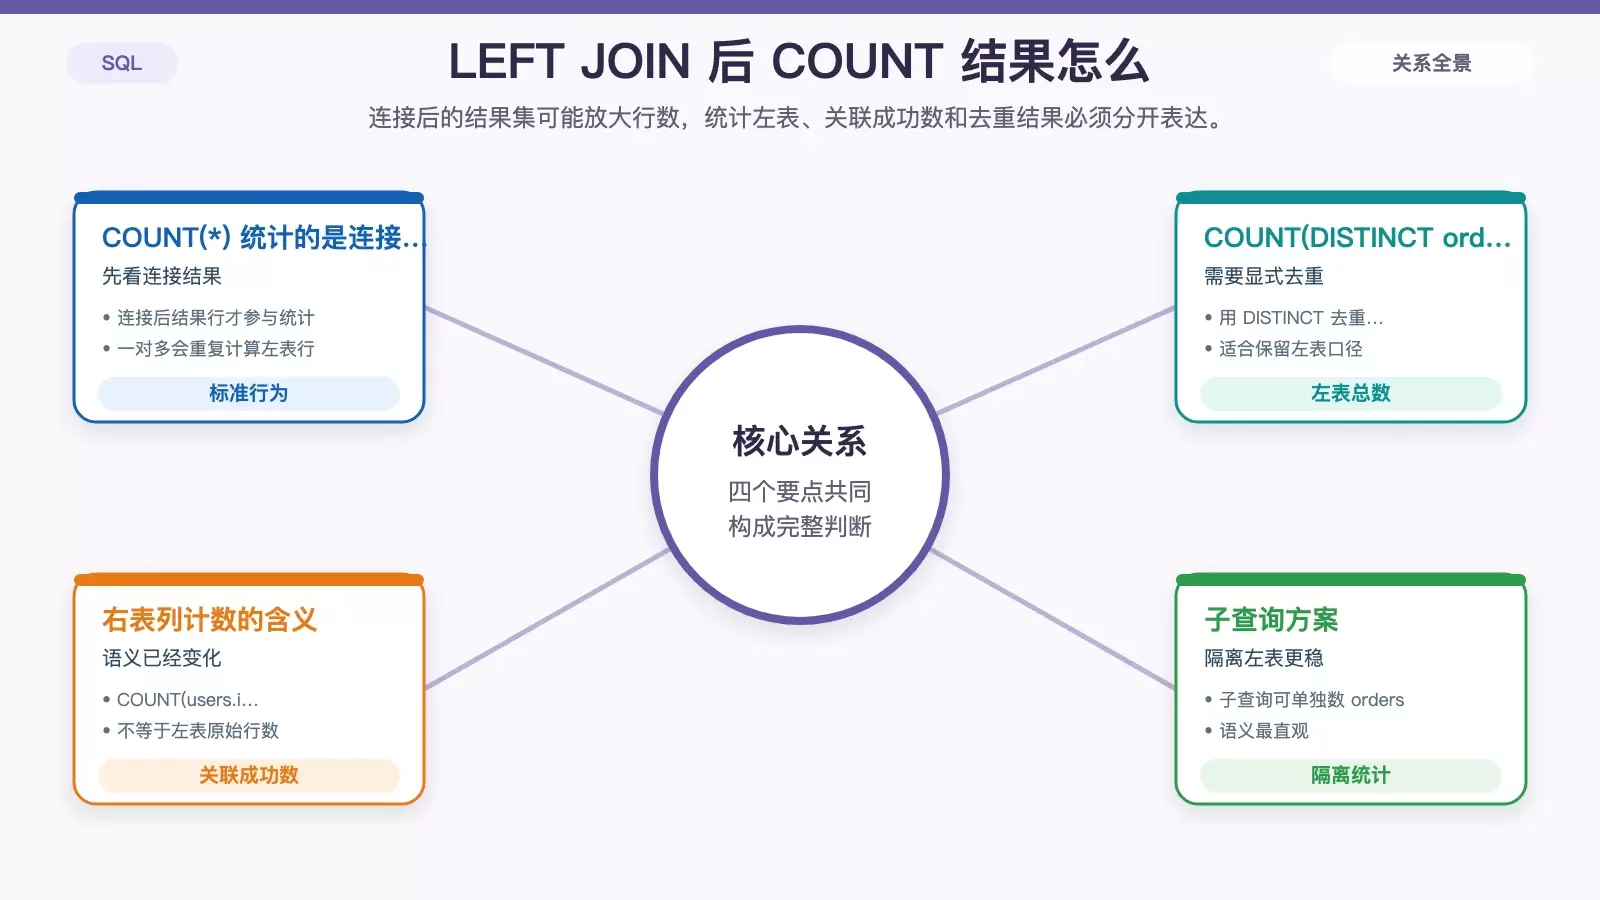
返回的是连接完成后的总行数,而不是 orders 原始表中的行数。如果一条订单记录在连接后匹配出 3 行结果,它就会被算 3 次。这不是 bug,而是 SQL 的标准行为。
如果你要统计左表原始行数,应该怎么写
COUNT(DISTINCT orders.id):适合在连接结果里按订单去重统计,但要注意去重本身有额外开销。(SELECT COUNT(*) FROM orders):用子查询把左表总数单独隔离出来,语义最直接。- 不要用
COUNT(users.id)替代。它统计的是“成功关联且users.id非NULL的结果行数”,既不等于左表原始行数,也不等于泛化意义上的关联数量。
还有一个很容易忽略的点:COUNT(列名) 的 NULL 判断发生在当前结果集层面,也就是经过 WHERE、GROUP BY 等处理之后再计算。它反映的是“此时此刻结果集里该列有多少个非空值”,而不是原始表中这一列的天然分布。
这类错误最麻烦的地方在于,SQL 不会报错,查询还能顺利返回数字,但业务含义已经静默偏移。分页、对账、报表和关联统计里,这正是最危险的一类问题。
实际使用时的判断规则
- 统计结果集总行数,优先使用
COUNT(*)。 - 统计某列中非
NULL的有效值数量,使用COUNT(列名)。 - 不要把
COUNT(列名)当作COUNT(*)的性能版替代,它的业务语义不同。 - 不要再把
COUNT(1)当成 InnoDB 下的优化技巧,重点应放在索引、约束和查询语义上。 - 遇到
JOIN、LEFT JOIN、去重和分页场景时,先确认自己数的是“连接后结果”,还是“某张原始表”,再决定是否要加DISTINCT或子查询隔离。
一句话概括:COUNT(*) 回答的是“有多少行”,COUNT(列名) 回答的是“这一列有多少个非空值”。只要先把这个问题问对,后面的性能和写法选择就不会跑偏。















