



在时间序列、日志明细和业务报表里,NULL 很常见,但“怎么补”不能只看语法是否能写出来。更实际的判断是:数据有没有明确顺序、允许向前补还是向后补、补值是否会破坏原本的业务含义。
下面按几种常见 SQL 窗口函数写法展开,分别说明它们适合解决什么问题、有哪些边界条件,以及为什么有些看似省事的聚合填充方式并不可靠。
用 LAG() 和 LEAD() 取最近的非空值
如果你的数据本身有明确顺序,例如按日期、时间戳或流水号排列,那么 LAG() 和 LEAD() 是最常用、也最容易控制的办法。它们不依赖全局统计,更适合时间序列或有序业务数据,比如按日期排列的销售记录。
先决条件:必须写清楚 ORDER BY
窗口函数要想稳定工作,前提是窗口内顺序明确。若没有 ORDER BY,窗口无序,结果就不可靠。
例如:
LAG(value, 1) OVER (ORDER BY date)这表示取前 1 行的 value。但如果上一行本身也是 NULL,结果仍然会是 NULL,不会自动继续向前找。
多取几层时要显式兜底
SQL 不会自动递归寻找“最近的非空值”,因此通常只能手动展开 1 到 3 层。原理就是先看当前值,再看上一行,不行再看上两行。
CASE
WHEN value IS NOT NULL THEN value
WHEN LAG(value, 1) OVER (ORDER BY date) IS NOT NULL THEN LAG(value, 1) OVER (ORDER BY date)
ELSE LAG(value, 2) OVER (ORDER BY date)
END
这种写法适合规则比较明确的场景,例如只允许用最近两天的数据补值。它的优点是可控,缺点是层数一多,SQL 会迅速变长。
性能上要注意重复计算
多层 LAG() 会重复执行窗口计算。数据量大时,建议先用 CTE 把不同偏移量的结果预先算出来,再在外层统一判断,避免一段表达式里多次重复调用同一个窗口。
用 COALESCE() 把多个窗口结果串成填充链
如果你的目标不是单纯“向前补”,而是“优先取最近可用值”,那么 COALESCE() 往往比嵌套 CASE WHEN 更直观。它本身不是窗口函数,但很适合把多个 LAG()、LEAD() 结果串起来,形成一条清晰的兜底链。
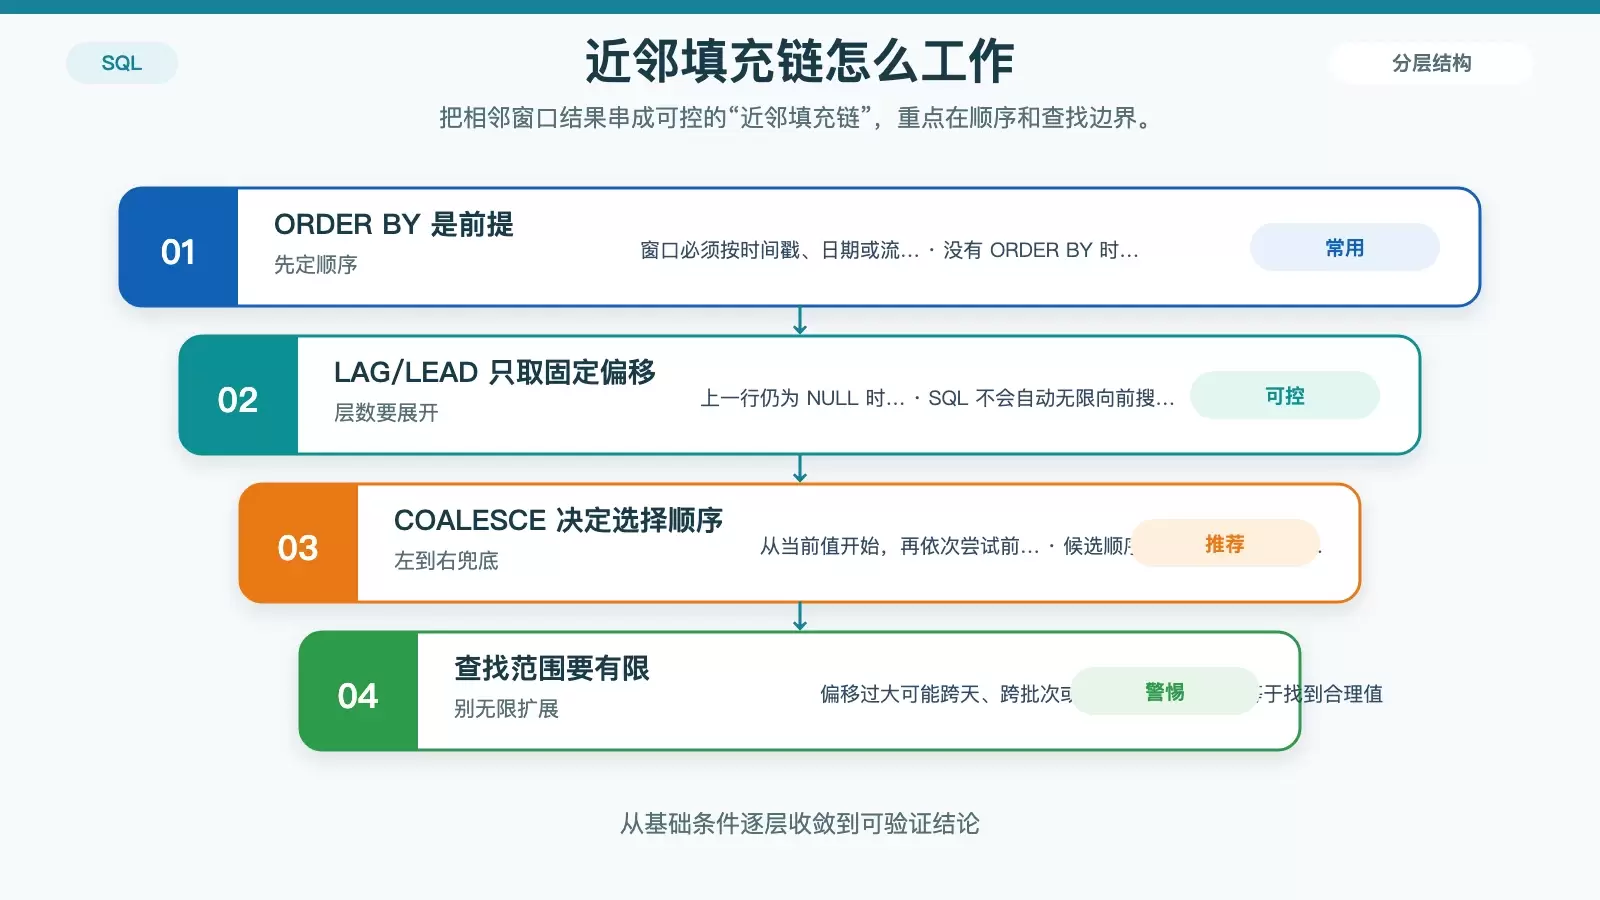
一个典型场景是传感器数据断点修复:设备每小时上报一次,偶尔漏报,这时就可以先看当前值,再看前后最近的有效值。
COALESCE(
value,
LAG(value, 1) OVER (ORDER BY ts),
LAG(value, 2) OVER (ORDER BY ts),
LEAD(value, 1) OVER (ORDER BY ts),
LEAD(value, 2) OVER (ORDER BY ts)
)
顺序决定了填充偏好
COALESCE() 会从左到右求值,遇到第一个非空值就返回。因此,候选项的排列顺序本身就是业务规则的一部分。
常见顺序可以是“当前行 > 前 1 行 > 前 2 行 > 后 1 行 > 后 2 行”。如果你的业务更偏向保留未来值,例如补齐计划表,也可以把 LEAD() 提前,但这必须是有意识的规则选择,而不是随意排列。
不要无限拉大查找范围
这种写法虽然灵活,但不适合无上限扩展。像 LAG(value, 100) 这样的偏移,在稀疏数据里很可能已经跨天、跨批次,甚至跨业务状态,最后补上的值虽然不是 NULL,却已经脱离当前记录的上下文。
因此,近邻填充的关键不是“能找到值”,而是“找到的值是否仍属于同一个业务语境”。
支持时优先考虑 FIRST_VALUE() + IGNORE NULLS
如果数据库支持 IGNORE NULLS,那么前向填充可以写得更自然。PostgreSQL 14+、Oracle、BigQuery 和 Snowflake 都支持这组语法,可以直接拿到“截至当前行为止,往前看第一个非空值”。
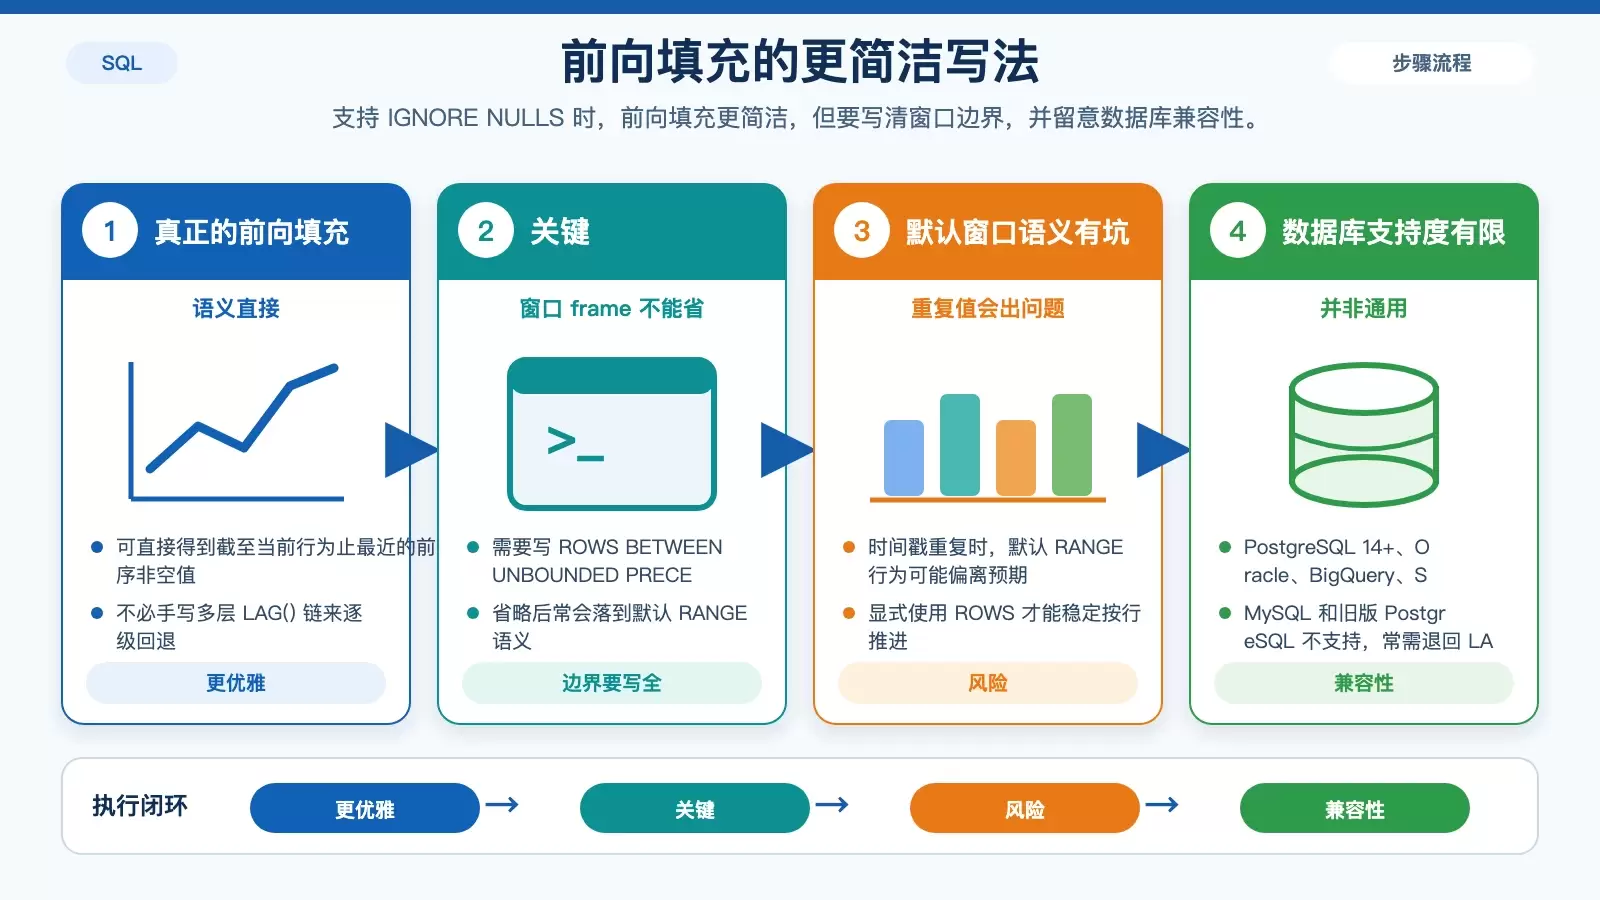
相比手写多层 LAG(),这更接近真正意义上的 forward fill:语义清楚,SQL 也更紧凑。
FIRST_VALUE(value) OVER (
ORDER BY ts
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
IGNORE NULLS
)
窗口边界一定要写完整
这里不能只写 ORDER BY ts 就结束。必须带上:
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW原因在于,如果省略窗口边界,很多数据库会使用默认的 RANGE 语义;一旦时间戳重复,行为就可能和预期不一致。写成明确的 ROWS BETWEEN ...,窗口范围才足够可控。
兼容性是最大限制
这套写法的主要问题不在逻辑,而在数据库支持度。MySQL 和旧版 PostgreSQL 不支持 IGNORE NULLS,这时如果硬用 ROW_NUMBER() 加自连接去模拟,往往既复杂又更慢,实际项目里通常不如退回到 LAG() 链。
为什么不建议直接用 AVG() 或 MAX() 来填充
很多人第一次处理缺失值时,会想到直接用聚合窗口函数“抹平”空值,比如 AVG(value) OVER (...)。从语法上看,这确实能得到一个非空结果,但在大多数业务场景里,这个结果并不等于“合理填充”。
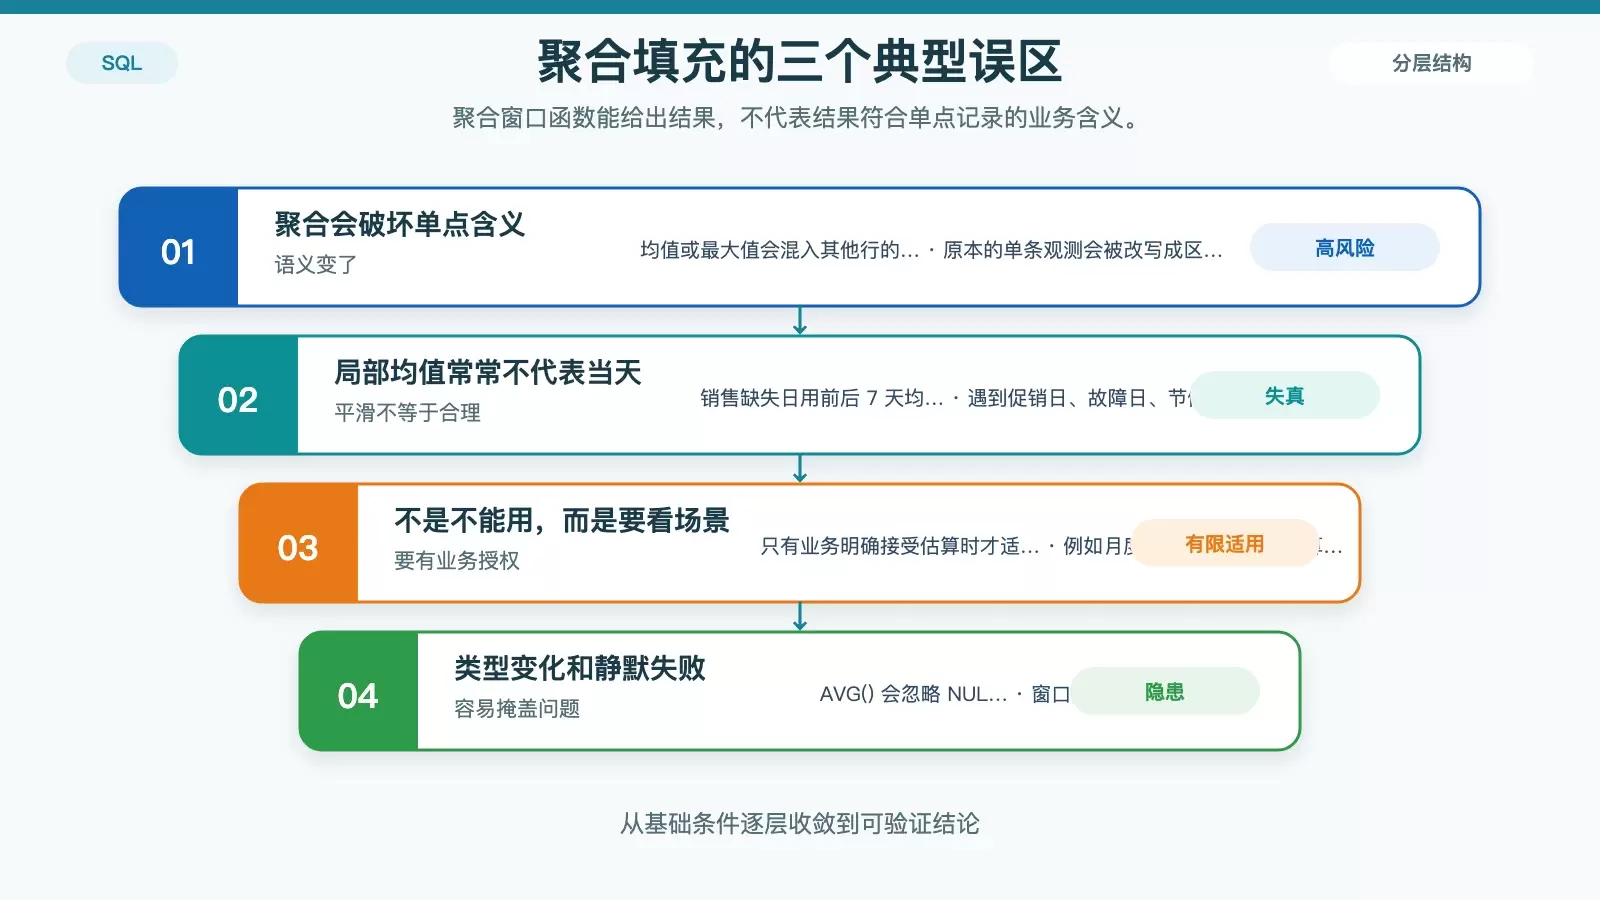
聚合值会改变单点观测含义
问题的核心是:聚合函数会把其他行的有效值混进来,原本代表单次观测、单日结果或单条记录的字段,经过聚合后就变成了区间统计值。
例如某天销售额缺失,如果直接用前后 7 天均值补上,就等于默认这一天的表现服从局部均值。遇到促销日、故障日或节假日时,这种假设通常会严重失真。
只有业务明确要求时才考虑
聚合填充并不是绝对不能用,但前提必须是业务本身接受这种估算方式。例如月度能耗估算、区间预算摊销等场景,本来就允许用区间均值代表缺失期,这时再用 AVG() 才说得过去。
还要留意类型和静默失败
AVG() 会自动忽略 NULL,但结果类型可能变成 DECIMAL,和原字段类型不一致。若后续要插入回表,通常需要显式 CAST。
另一个更隐蔽的问题是:如果整个窗口内全为 NULL,AVG() 仍然只会返回 NULL,不会报错。这很容易把原本应该暴露的数据质量问题悄悄掩盖掉。
最终该怎么选:先看业务规则,再选窗口函数
处理缺失值时,真正困难的部分往往不是 SQL 语法,而是先回答两个问题:这个空值到底该不该填,以及应该由谁来填。
如果数据有明确顺序,且只允许参考相邻记录,优先用 LAG()/LEAD();如果要做“就近兜底”,用 COALESCE() 串联多个窗口结果会更清晰;如果数据库支持 IGNORE NULLS,那么 FIRST_VALUE() 是更自然的前向填充方案。至于 AVG()、MAX() 这类聚合方式,除非业务明确要求估算,否则不宜直接拿来补值。
换句话说,窗口函数只是工具,决定结果是否可信的,始终还是业务规则本身。















