


怎么写更Pythonic?常用代码片段的优化与最佳实践
深入拆解如何写出地道、优雅且高效的Python代码。围绕序列迭代、推导式与生成器、字典操作、上下文管理与EAFP心智模型等核心场景,提供从传统代码到Pythonic风格的详实重构指南。
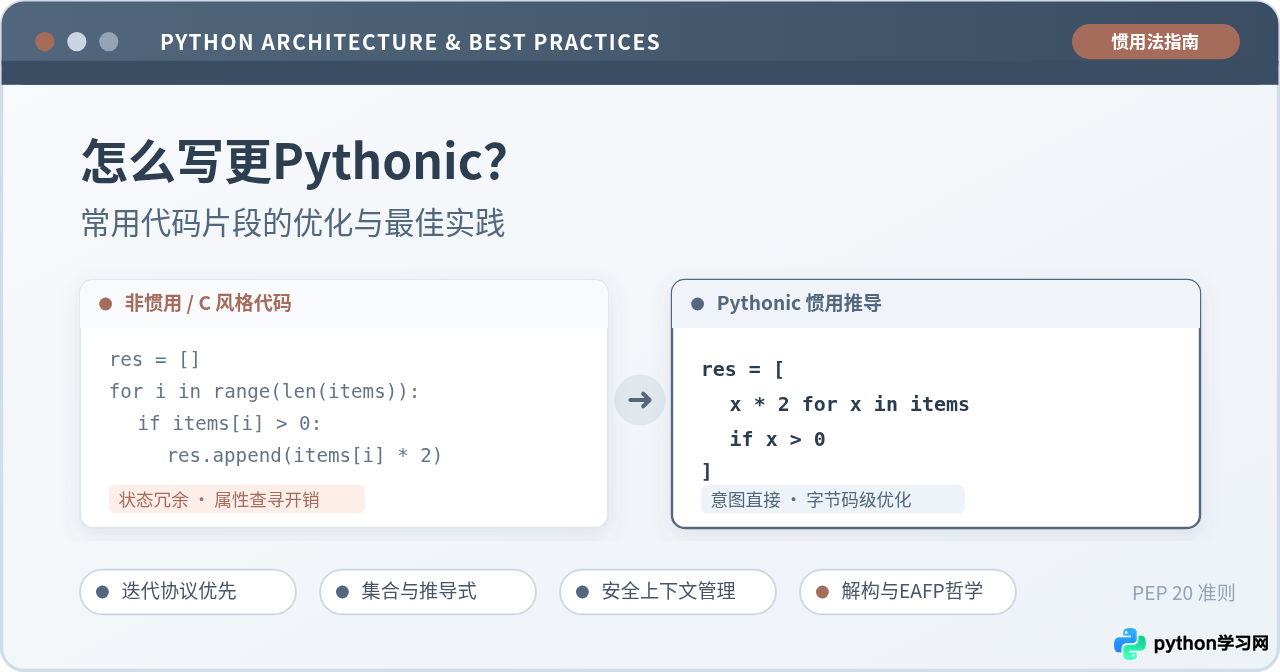
“Pythonic” 并不是追求冷僻语法特性的个人炫技,更不是为了缩减行数而将复杂逻辑生搬硬套成难懂的单行代码;它的核心是以 Python 原生数据模型(Data Model)为依托,用直白、明确、一致的方式传达编程意图。许多刚从 C、C++、Java 或 PHP 转向 Python 的工程师,往往容易把原先强依赖下标寻址、手动分配状态和显式资源回收的编码习惯照搬过来。这不仅让代码冗长晦涩,还平白丢掉了解释器底层的优化机制。本文围绕开发中高频出现的五类日常场景——序列遍历、推导式与生成器、字典操作、上下文管理以及惯用心智模型,结合直观对比、执行原理与边界约束,系统讲解常用代码片段的 Pythonic 重构路径。
一、遍历与计数:从索引访问到协议迭代
在有 C 语言背景的代码库中,最容易见到的反模式莫过于使用 range(len(...)) 构造下标。编写者需要知道当前元素的位置,于是机械地生成数字序列,再在循环内部回查容器。这种写法将原本统一的“元素访问”割裂为“计数维护”和“下标寻址”两件事,既繁琐又容易引发边界错误。
users = ["Alice", "Bob", "Charlie"]
for i in range(len(users)):
print(f"Index {i}: {users[i]}")users = ["Alice", "Bob", "Charlie"]
for i, user in enumerate(users, start=0):
print(f"Index {i}: {user}")需要同时遍历多个关联列表时,下标索引的劣势会成倍放大。例如同步迭代商品列表与对应售价时,传统写法依赖 names[i] 和 prices[i],一旦两个列表长度不一致,末尾就会抛出 IndexError。更稳妥且直观的做法是使用内置的 zip() 函数。在 Python 3.10 及以上版本中,建议显式声明 strict=True 参数:
names = ["Keyboard", "Mouse", "Monitor"]
prices = [299, 129, 1499]

# Python 3.10+ strict 校验保障数据长度一致性
for name, price in zip(names, prices, strict=True):
    print(f"{name}: ¥{price}")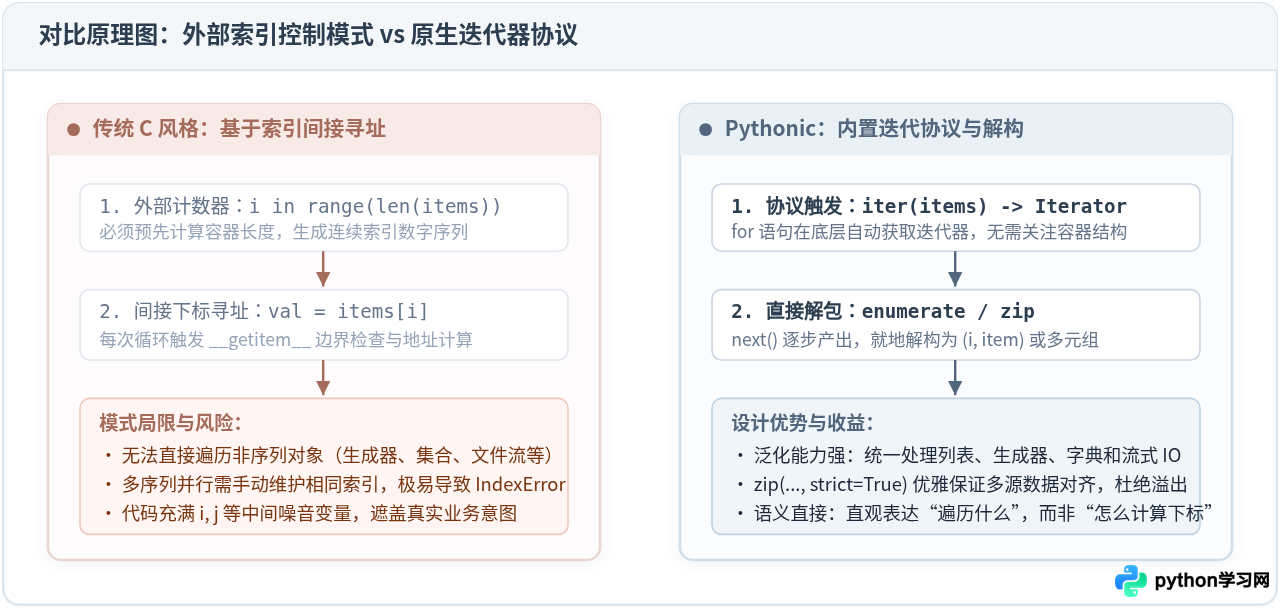
Python 的 for 循环本质是底层迭代器协议(Iterator Protocol)的驱动层。当执行 for x in obj 时,解释器首先调用 iter(obj) 获取迭代器,随后连续调用其 next() 方法,直至触发 StopIteration 终止信号。这意味着即便数据源是不可切片、无法提前获知长度的文件字节流、网络 Socket、生成器或数据库游标,迭代协议都能无缝运行,而索引寻址法则直接失效。
二、数据集合构建:从 append 到推导式与生成器
在筛选和转换数据集合时,许多脚本习惯先实例化一个空列表,接着写一个 for 循环并在满足条件时调用 list.append()。这种逐行拼接的命令式逻辑不仅视觉分散,在运行时还存在额外的性能损耗。
# 筛选偶数并计算平方
even_squares = []
for n in numbers:
    if n % 2 == 0:
even_squares.append(n ** 2)# 紧凑清晰的列表推导式
even_squares = [
n ** 2 for n in numbers
if n % 2 == 0
]推导式不仅适用于列表,还同样适用于集合(Set)与字典(Dict)。例如将对象列表转换为以 ID 为键的映射表:
# 字典推导式:单行完成键值映射构建
user_map = {u.user_id: u.name for u in user_records}

# 集合推导式:自动剔除重复项并转为大写
unique_roles = {u.role.upper() for u in user_records}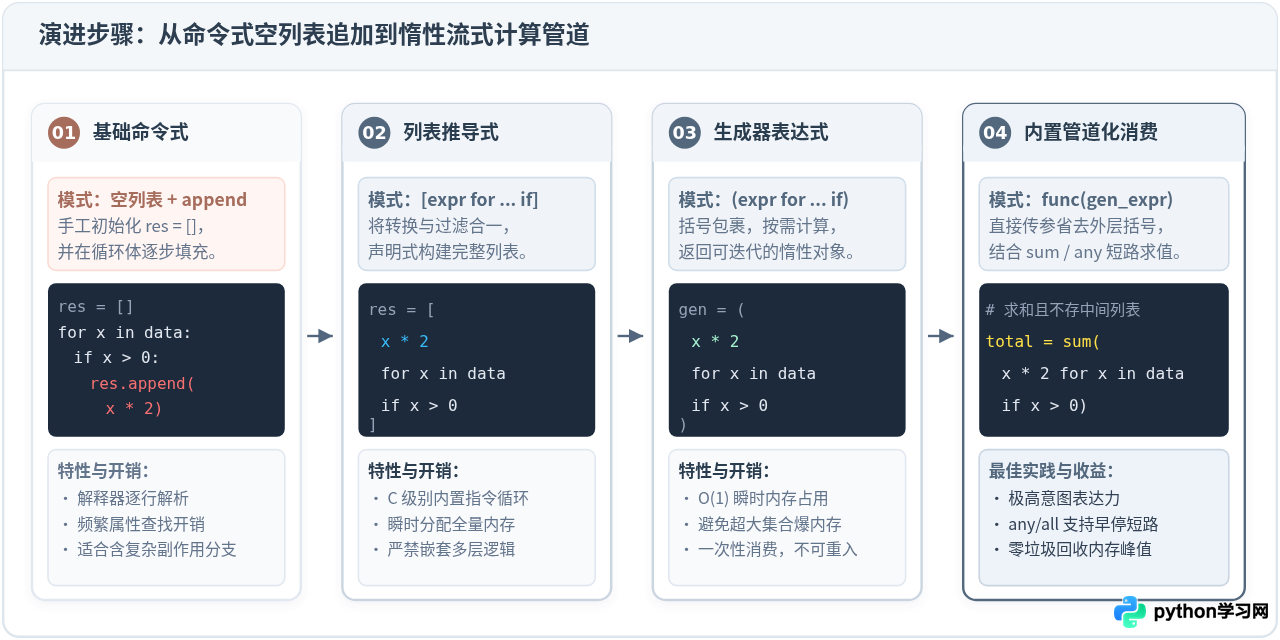
惰性求值:海量数据下的生成器管道
列表推导式虽然优雅,但它会在内存中一次性分配全部运算结果。如果输入源包含数百万行日志,或者数据本身是无限流,列表推导式会瞬间耗尽机器可用内存。此时,只需将外层中括号改为圆括号,即可获得生成器表达式(Generator Expression):
# 生成器表达式保持 O(1) 瞬时内存占用
log_lengths = (len(line) for line in open("large_access.log") if line.strip())

# 直接将生成器交给聚合函数消费,中间无需额外加括号
max_len = max(len(line) for line in open("large_access.log") if line.strip())Pythonic 的第一准则是“可读性优先”。当推导式中包含超过两层 for 循环,或者混杂了多重三元条件表达式(如 a if cond1 else b if cond2 else c)时,请立即停止单行化。过长的推导式会直接摧毁代码的可维护性,此时拆分为结构清晰的标准循环或抽取专用生成器函数才是最佳工程选择。
三、键值存取与聚合:简化字典处理
字典是 Python 系统内部最核心的数据基石。处理字典查找与聚合时,容易出现充斥着 if key in dict 校验的防御性代码。这不仅让核心业务逻辑被淹没,还造成多次多余的哈希碰撞与查找计算。
1. 默认值读取:避免显式条件判断
当仅仅需要读取某个可能不存在的键并赋予降级值时,直接调用 dict.get() 即可,无需编写完整的分支结构:
# 传统写法
if "timeout" in config:
    t = config["timeout"]
else:
    t = 30

# Pythonic 惯用写法
t = config.get("timeout", 30)
2. 分组归拢与计数:善用 collections 工具库
在统计词频或按类别归拢元素时,若手动判断键是否存在并逐步追加,代码往往显得冗长笨重。标准库提供了完备的高阶映射类:
grouped = {}
for user in users:
    dept = user.department
    if dept not in grouped:
        grouped[dept] = []
grouped[dept].append(user.name)from collections import defaultdict
grouped = defaultdict(list)
for user in users:
grouped[user.department].append(user.name)3. 字典合并:Python 3.9+ 的合并运算符
在需要合并默认配置与用户自定义参数的场景下,历史版本中常使用 dict.update() 或双星号解包 {**defaults, **custom}。Python 3.9 官方引入了并集运算符 | 与就地运算符 |=,让映射合并变得如同数字相加般自然:
base_config = {"host": "localhost", "port": 8080, "debug": False}
user_config = {"port": 9000, "debug": True}

# Python 3.9+ 字典合并运算符
final_config = base_config | user_config
# 结果:{"host": "localhost", "port": 9000, "debug": True}
四、资源管理与状态流转:上下文管理器的优雅与安全
在处理文件 I/O、网络连接、互斥锁或数据库事务等系统资源时,最严重的生产事故莫过于“资源泄漏”。如果仅在代码末尾显式调用 close() 或 release(),一旦前序执行过程抛出异常或者提前执行了 return,资源回收逻辑将被直接跳过。
f = open("dataset.csv", "r")
try:
    content = f.read()
    process(content)
finally:
f.close()with open("dataset.csv", "r") as f:
content = f.read()
process(content)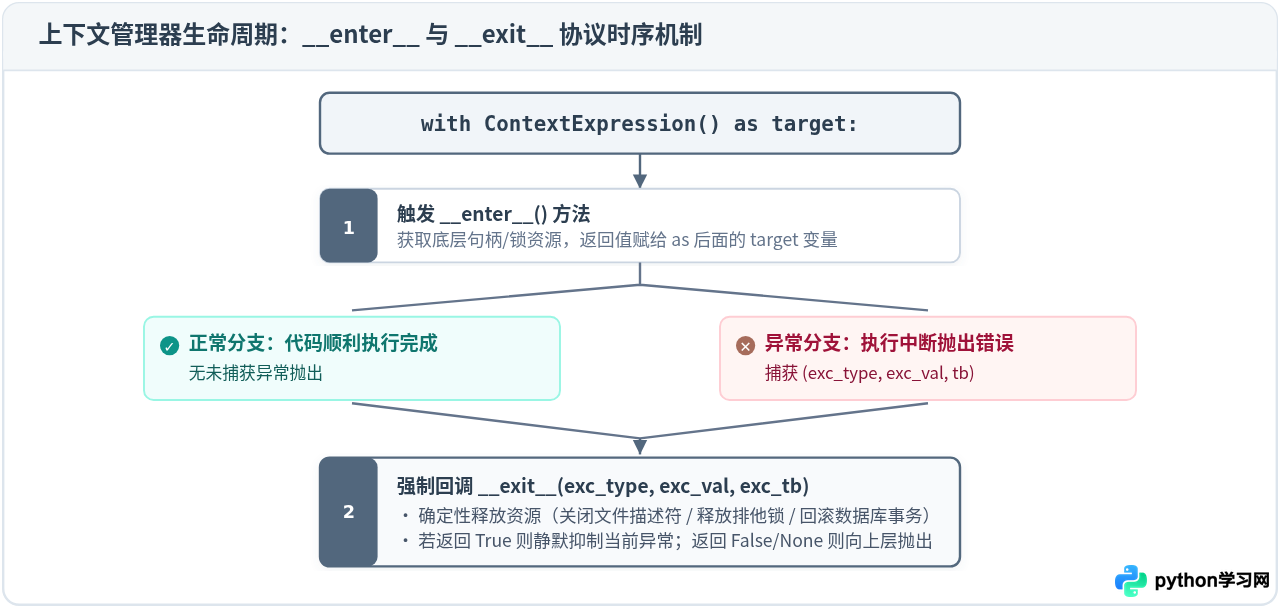
自定义上下文管理器:使用 contextmanager 装饰器
在日常业务开发中,不仅原生文件需要上下文保护,诸如“临时修改系统环境变量”、“接口耗时统计打点”以及“数据库原子事务提交回滚”等对称性操作,均应封装为上下文管理器。借助标准库 contextlib.contextmanager,无需手写繁琐的类和双下划线方法,只需一个包含 yield 的生成器:
import time
from contextlib import contextmanager

@contextmanager
def execution_timer(task_name: str):
    start = time.perf_counter()
    print(f"[{task_name}] 开始执行...")
    try:
        # yield 将控制权交还给 with 代码块
        yield
    finally:
        # 无论发生何种异常,均确保计算并输出耗时
        elapsed = time.perf_counter() - start
        print(f"[{task_name}] 执行完毕,耗时 {elapsed:.4f} 秒")

# 业务使用体验极其自然
with execution_timer("批量生成报表"):
    generate_monthly_reports()
五、惯用语法与心智模型:解构、比较与 EAFP 哲学
除了容器和控制语句,Pythonic 代码的精髓还深植于语言内建的语法表达与心智模型中。
1. 多变量解构与星号吸收
在 Python 中交换两个变量的值无需声明第三方临时变量 temp,解构赋值(Unpacking)能在一个原子操作中完成:
# 传统写法
temp = a; a = b; b = temp

# Pythonic 交换
a, b = b, a
如果需要从序列中截取首尾元素,不必使用容易产生索引偏移的切片语法,星号表达式(Star Unpacking)可以让意图一目了然:
raw_records = ["2026-10-31", 102.5, 98.2, 104.1, 101.8, "FINAL_AUDIT"]

# 首项为日期,末项为状态标记,中间任意个浮点值为采集样本
date, *samples, status = raw_records
# samples 自动捕获为列表:[102.5, 98.2, 104.1, 101.8]
2. 链式比较与短路逻辑
在很多语言中,区间校验需要写成 val >= min and val <= max。Python 支持如同数学表达式般的连续链式比较:
# 避免:冗长的逻辑与运算符
if age >= 18 and age <= 65:
    allow_registration()

# 推荐:自然的数学区间表达
if 18 <= age <= 65:
    allow_registration()
类似地,面对多项布尔检查,使用 any() 和 all() 结合生成器表达式,比手写循环累加标志位(Flag)更加高效且具备短路求值特性:
# 检查是否存在非法输入(只要有一项满足就立即短路返回)
has_invalid = any(x < 0 for x in transaction_amounts)

# 确保所有前置任务均已成功完成
is_ready = all(task.is_completed for task in pre_tasks)
3. 心智模型转变:EAFP 胜过 LBYL
在传统静态语言中,通常推崇 LBYL(Look Before You Leap,三思而后行):在执行操作前,先通过层层 if 检查各种前提条件。而在 Python 哲学中,更推崇 EAFP(Easier to Ask for Forgiveness than Permission,先行其事,后请原谅):先假定环境正常并大胆执行,若发生异常再从容捕获处理。
import os

if os.path.exists(file_path):
    if os.access(file_path, os.R_OK):
        with open(file_path) as f:
data = f.read()try:
with open(file_path) as f:
data = f.read()
except (FileNotFoundError, PermissionError) as e:
logger.warning(f"无法读取文件 {file_path}: {e}")六、综合优化与日常重构自查规范
写出更 Pythonic 的代码不是死记硬背语法糖,而是在日常编码与 Code Review 中建立起一套自然的反射习惯。下表总结了本篇文章梳理的核心优化维度与对比自查项:
| 优化维度 | 传统 / 非惯用写法 (Avoid) | Pythonic 推荐方案 (Prefer) | 核心收益 |
|---|---|---|---|
| 序列遍历 | for i in range(len(items)): |
for i, item in enumerate(items): |
消除下标查表与越界风险,统一可迭代对象接口 |
| 多源对齐 | for i in range(len(a)): a[i], b[i] |
zip(a, b, strict=True) |
直接解构多维数据,保障长度一致性 |
| 集合构建 | res = []; for ... res.append(...) |
[expr for item in seq if cond] |
底层字节码级加速,逻辑由命令式转为声明式 |
| 流式统计 | sum([x for x in large_data]) |
sum(x for x in large_data) |
惰性求值,将内存开销由 O(N) 降低至 O(1) |
| 字典查询 | if k in d: v = d[k] else: v = 0 |
v = d.get(k, 0) |
精简分支判断,减少重复哈希检索 |
| 映射合并 | d = {**a, **b} 或多行 update() |
d = a | b |
Python 3.9+ 现代化语法,保持语义清晰统一 |
| 资源清理 | open() ... close() + finally |
with open(...) as f: |
确保持有句柄在任何异常路径下均安全闭合 |
| 逻辑控制 | 深层嵌套 if 先验防御检查 |
try ... except (EAFP) / 链式比较 |
防止并发竞态,提升正常主干代码的阅读流畅度 |
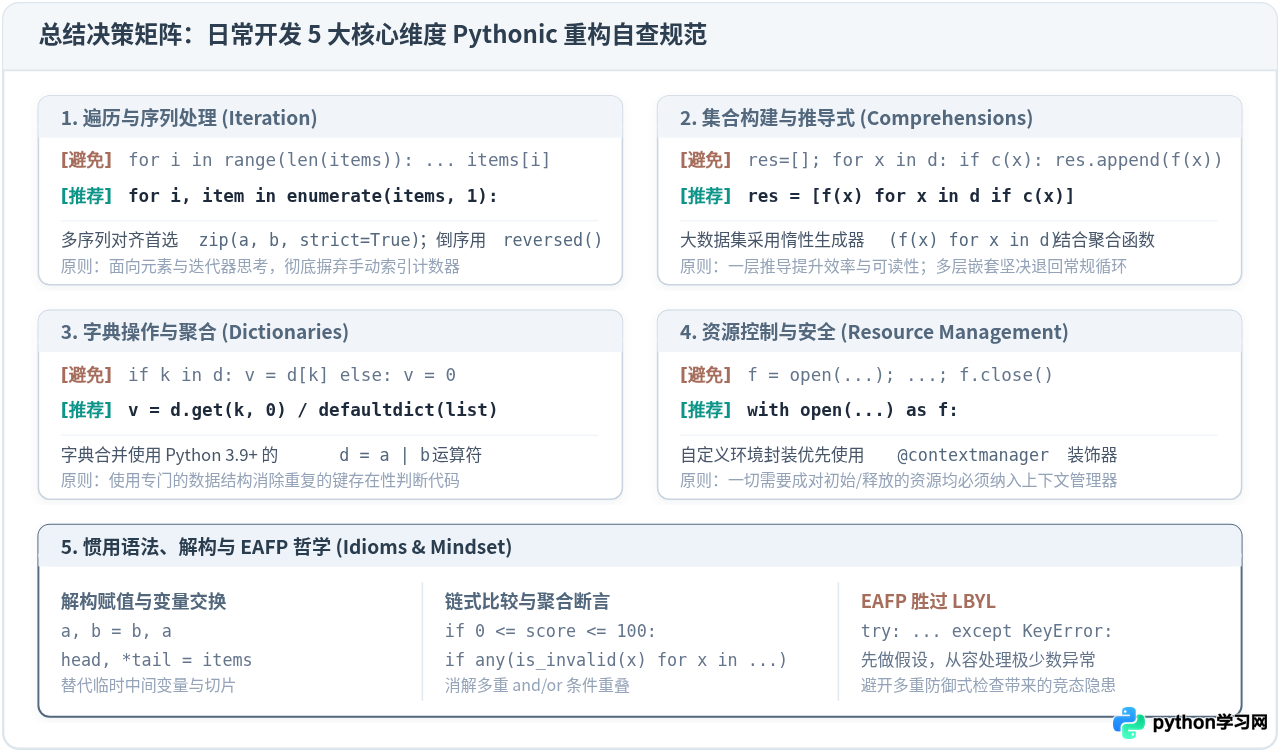
在 Python 解释器中输入 import this,你可以重温经典的《The Zen of Python》。其中最为关键的两句话是:“Explicit is better than implicit”(明了胜于晦涩)与 “Readability counts”(可读性至关重要)。所谓 Pythonic,归根结底是在语言特性的简洁性与工程代码的清晰性之间取得平衡。掌握这些最佳实践,并在合适的地方准确使用它们,你的代码不仅能更优雅地运行,也能让团队中的每一位协作者倍感轻松。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















