


详解requests与BeautifulSoup:Python静态网页抓取实战教程
系统详解Python使用requests与BeautifulSoup抓取静态网页的实战教程。涵盖网络请求发送、DOM树解析、find与CSS选择器差异对比、完整抓取链路与异常防坑策略。
使用 Python 进行静态网页数据抓取的核心流程非常直接:由 requests 负责发起 HTTP 网络请求并获取服务端返回的原生 HTML 文档,再交由 BeautifulSoup 构建文档对象模型(DOM)树并提供灵活的检索接口。本文将从二者的协作边界、解析器选型、核心定位方法对比到异常防护展开完整讲解,帮助读者掌握可靠的静态网页抓取方法。
一、静态网页抓取的执行全流程
在进入代码编写之前,需要明确“静态网页”在技术层面的定义。静态网页指用户访问目标 URL 时,服务器所响应的 HTML 文本中已经包含了所有需要展示的文本、链接和结构化内容,无需依赖客户端浏览器后续执行 JavaScript 脚本向后端异步加载数据。
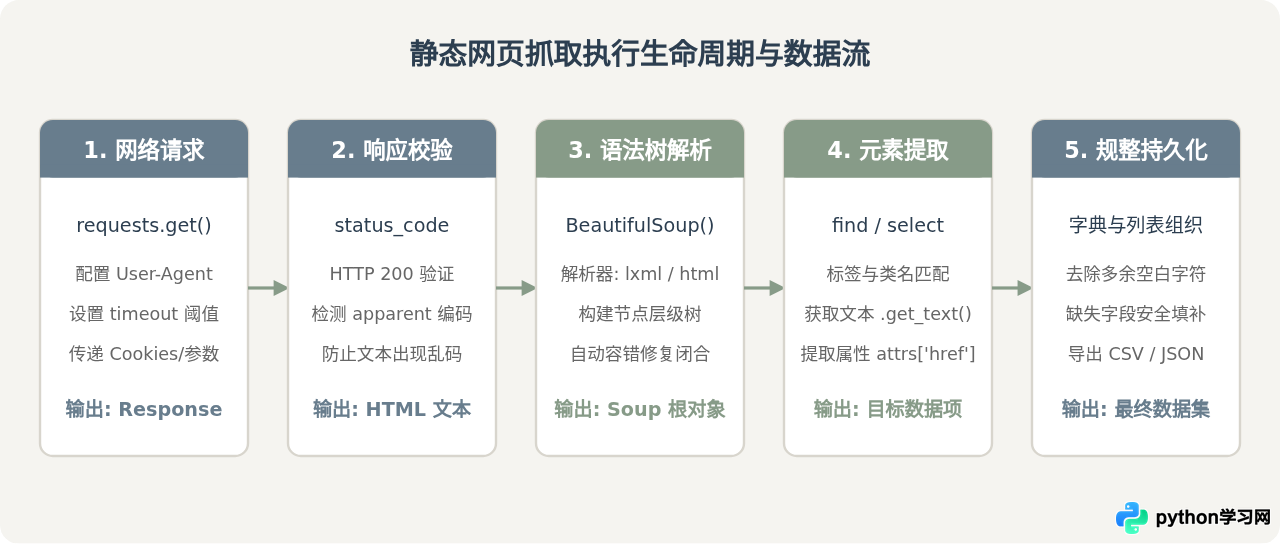
一次标准的静态网页抓取任务在逻辑上划分为五个严格相扣的环节:从构建请求头并调用 requests 发送网络请求开始,依次经过状态检验与字符编码确认、DOM 树结构化加载、标签与属性筛选清洗,直至将数据规整并持久化存储。
二、技术分工与架构边界
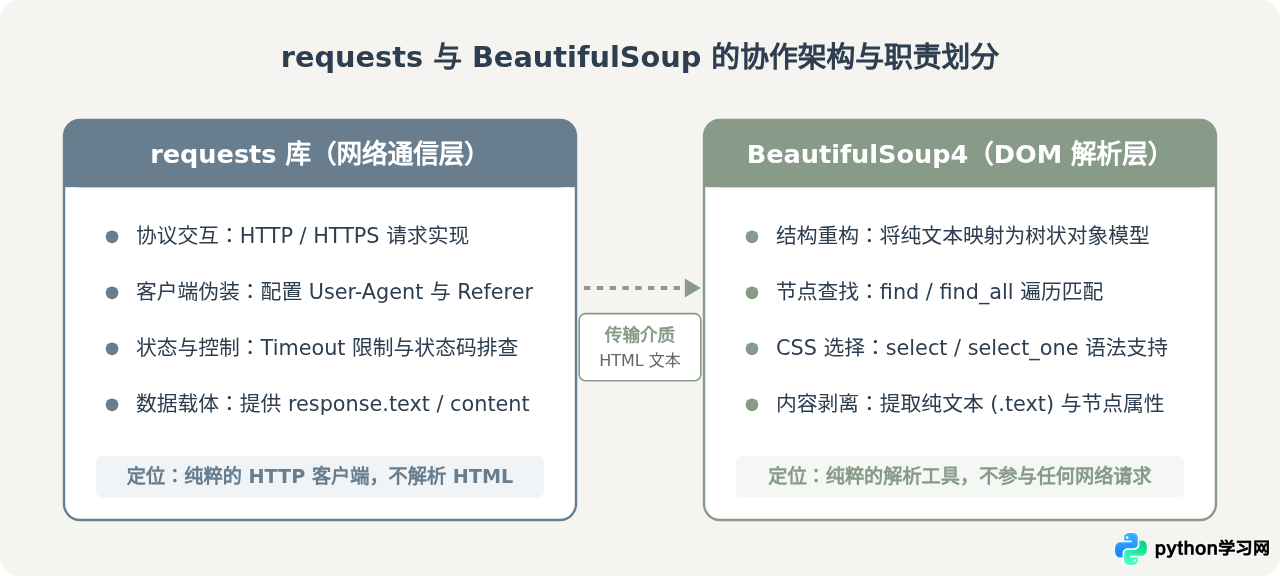
初学者常误以为某个库能够“一条龙”完成网页抓取,但实际上 requests 和 BeautifulSoup 各自解决不同层面的问题,具有非常分明的职责边界。
- requests 负责 HTTP 通信层:专注于发送网络请求、配置请求头(Headers)、处理查询参数(Params)、传递表单数据(Data)、管理会话(Session)与 Cookie、处理 301/302 重定向以及网络超时。它对 HTML 的内部语法一无所知,仅将服务器响应视作纯字符串或二进制字节流。
- BeautifulSoup 负责 DOM 解析层:专注于解析传入的 HTML 字符串,依据标准建立包含父子、兄弟关系的节点树,并提供基于标签名、CSS 类名、属性字典及 CSS 选择器的遍历和定位接口。它不具备任何联网能力,无法自主发起 HTTP 请求。
三、运行环境准备与解析器对比
在 Python 环境中执行爬虫开发前,需要安装必要的第三方库。除了 requests 和 beautifulsoup4 本身,建议同时安装高性能解析引擎 lxml。
pip install requests beautifulsoup4 lxml
在初始化 BeautifulSoup(html_text, '解析器名称') 时,解析器的选择会直接影响程序的运行效率和对不规范 HTML 的容错能力:
| 解析器名称 | 底层实现 | 解析速度 | 容错能力 | 依赖与适用建议 |
|---|---|---|---|---|
html.parser |
Python 标准库原生实现 | 中等 | 良好 | 无需额外安装 C 扩展;适合开发测试与轻量抓取。 |
lxml |
基于 C 语言 libxml2 / libxslt | 极快 | 优秀 | 推荐生产首选;解析吞吐高,能够自动修复未正确闭合的异常标签。 |
html5lib |
纯 Python 标准算法 | 较慢 | 极强(完全模拟浏览器) | 按 HTML5 规范以浏览器容错方式构建 DOM;适合极其畸形或复杂的旧网页。 |
四、核心定位方式对比:find 系列与 CSS 选择器
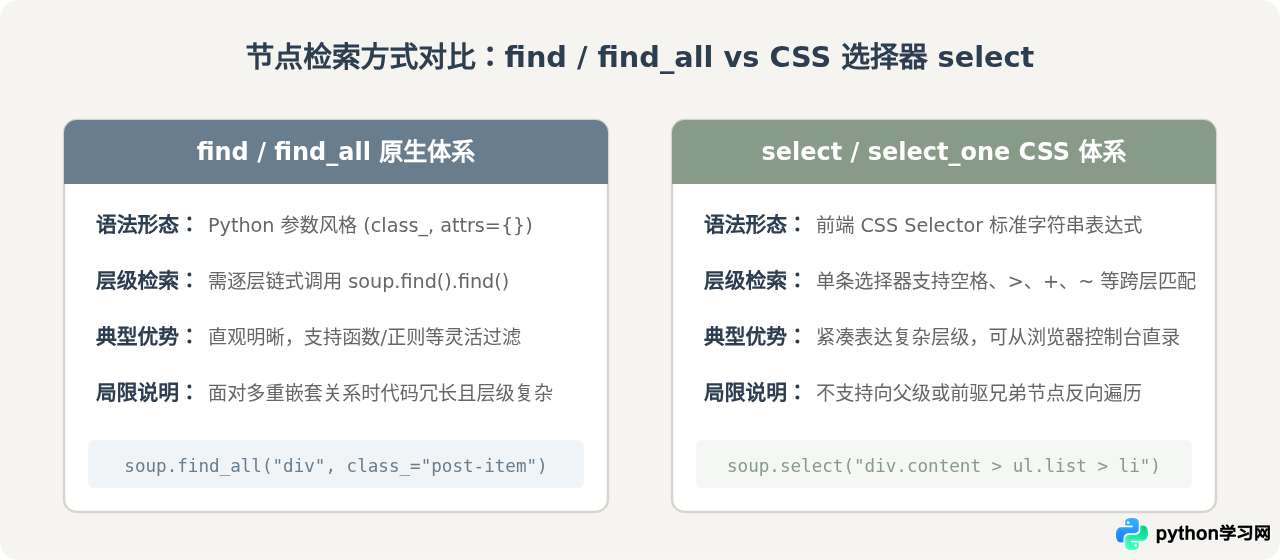
BeautifulSoup 提供了两套不同语法风格的节点查询体系:以 find() 和 find_all() 为代表的原生 API,以及以 select() 和 select_one() 为代表的 CSS 选择器 API。在一致的抓取目标下,二者的逻辑表现和适用场景存在明显差异。
1. 原生 API:find() 与 find_all()
find() 返回匹配条件的第一个节点(Tag 对象),未找到时返回 None;而 find_all() 返回所有符合条件的节点列表(ResultSet),未找到时返回空列表 []。
# 按标签与 class 筛选
article = soup.find("article", class_="news-card")

# class 是 Python 保留关键字,BeautifulSoup 约定加下划线 class_
# 也可以使用字典语法传递多重属性
links = soup.find_all("a", attrs={"target": "_blank", "rel": "nofollow"})
2. 选择器 API:select_one() 与 select()
select_one() 返回第一个匹配 CSS 规则的 Tag,select() 返回所有匹配的 Tag 列表。对于深层嵌套结构(如文章内容下的特定段落),CSS 选择器能够用极短的表达式定位:
# 获取 id 为 main-content 内部所有 class 包含 highlight 的段落
paragraphs = soup.select("#main-content p.highlight")

# 获取直接子节点(子代选择器)
items = soup.select("ul.nav-bar > li > a")find() 更加直截了当;对于具有明确层级关系(如“导航栏下的第三级链接”)或已经通过浏览器开发者工具复制了选择器路径的场景,使用 select() 编写维护效率更高。
五、端到端静态网页抓取实战示例
下面给出一个完整的、符合生产编码规范的实战示例。代码模拟抓取一个包含新闻列表的静态页面,演示从请求构造、错误捕获、数据解析到字典清洗的全部过程。
import requests
from bs4 import BeautifulSoup

def fetch_news_articles(target_url: str):
    """
    抓取目标静态网页的新闻列表数据
    """
    # 1. 构造标准请求头,模拟真实浏览器访问
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/122.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        # 2. 发起请求并严格限制超时时长(连接超时 5 秒,读取超时 10 秒)
        response = requests.get(target_url, headers=headers, timeout=(5, 10))

        # 3. 校验 HTTP 状态码,若为 4xx 或 5xx 则主动抛出异常
        response.raise_for_status()

        # 4. 处理文本编码,防止中文出现乱码
        # 若原始响应头未给出确切编码,采用 apparent_encoding 进行内容探测
        if response.encoding.lower() == "iso-8859-1":
            response.encoding = response.apparent_encoding

        html_content = response.text

    except requests.exceptions.Timeout:
        print(f"请求超时:目标地址 {target_url} 响应过慢")
        return []
    except requests.exceptions.HTTPError as err:
        print(f"HTTP 错误:{err}")
        return []
    except requests.exceptions.RequestException as err:
        print(f"网络交互失败:{err}")
        return []

    # 5. 使用 lxml 解析器构建 DOM 树
    soup = BeautifulSoup(html_content, "lxml")

    articles_data = []

    # 6. 定位新闻列表卡片容器
    card_elements = soup.select("div.news-list > div.news-item")

    for card in card_elements:
        # 7. 安全提取标题与链接
        title_node = card.select_one("h3.title > a")
        if not title_node:
            continue

        title = title_node.get_text(strip=True)
        # 提取 href 属性,若属性不存在则默认返回空字符串
        link = title_node.get("href", "").strip()

        # 8. 提取发布时间与摘要(若不存在则安全降级)
        time_node = card.select_one("span.publish-date")
        publish_time = time_node.get_text(strip=True) if time_node else "未知时间"

        summary_node = card.select_one("p.summary")
        summary = summary_node.get_text(strip=True) if summary_node else ""

        articles_data.append({
            "title": title,
            "link": link,
            "publish_time": publish_time,
            "summary": summary
        })

    return articles_data

# 执行示例
if __name__ == "__main__":
    example_url = "https://example.com/news"
    # 执行函数(演示用途,实际运行时请传入有效网络目标)
    results = fetch_news_articles(example_url)
    print(f"成功解析出 {len(results)} 条记录")
六、生产级爬虫四大防护支柱与避坑指南
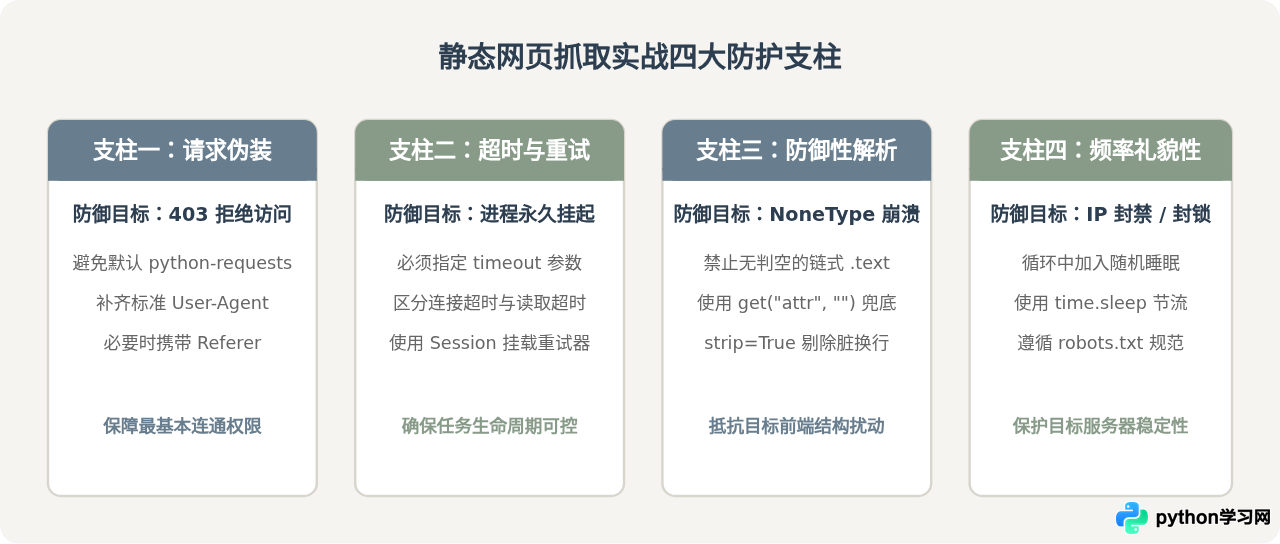
编写可以运行的演示脚本非常简单,但要编写能够在生产环境下长期稳定执行的抓取程序,必须具备应对常见网络异常与页面结构波动的能力。以下总结了静态抓取过程中必须遵守的四大支柱原则:
常见问题与排错方案
-
获取到的中文全部变成乱码(类似
姑æ…):
原因:HTTP 响应头中缺少charset声明时,requests 默认会回退为ISO-8859-1编码。
解决方案:在调用response.text之前,主动执行response.encoding = response.apparent_encoding,或者直接使用response.content.decode('utf-8', errors='replace')。 -
程序报错
AttributeError: 'NoneType' object has no attribute 'text':
原因:页面结构发生变化或某条数据缺失特定字段,soup.find()未找到节点返回了None,直接调用.text导致崩溃。
解决方案:始终对节点做if node:存在性校验,或使用三元表达式赋默认值。 -
浏览器里能看到数据,但 requests 拿到的 HTML 里根本没有对应内容:
原因:该目标并不属于纯静态网页,其内容是通过前端 Ajax / fetch 异步请求接口动态加载渲染出来的。
解决方案:打开浏览器“开发者工具”的 Network 标签页,直接排查目标后端返回的 JSON 数据接口;或者改用 Playwright / Selenium 等支持无头浏览器运行的自动化工具进行抓取。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















