


Python机器学习中的过拟合怎么办?原因分析与调优策略
针对Python机器学习中模型过拟合问题,系统剖析数据、特征、算法复杂度与训练机制等核心成因,并提供基于Scikit-Learn的交叉验证、正则化、特征筛选与早停策略等实用调优解决方案与代码示例。
过拟合是机器学习实践中最常见、也最容易让人产生“模型效果绝佳”错觉的问题。解决过拟合的核心并不在于追求极致的模型结构,而在于准确识别泛化能力断崖式下降的拐点,并通过约束模型容量、提纯特征以及扩充严密验证机制,让算法学会泛化而非死记硬背数据。
一、如何快速识别模型正在过拟合?
在Python构建机器学习管道时,过拟合通常表现为极其鲜明的反差:模型在训练集上评分极高(准确率接近100%,或者MSE趋近于0),但一旦推断从未见过的验证集或测试集,指标便出现剧烈滑坡。这种现象表明,模型不仅学习了数据的底层客观规律,还将训练数据中的偶然噪声、异常离群点甚至采样偏置当作必然模式完整吸收。
判断过拟合最直接、最客观的方法是结合独立验证集和绘制学习曲线(Learning Curve)。当训练误差维持在很低水平,而验证误差与训练误差之间的间距(Generalization Gap)显著拉大,或者验证集损失随着迭代次数增加反而开始反弹上升时,即可明确断定模型已陷入过拟合泥潭。
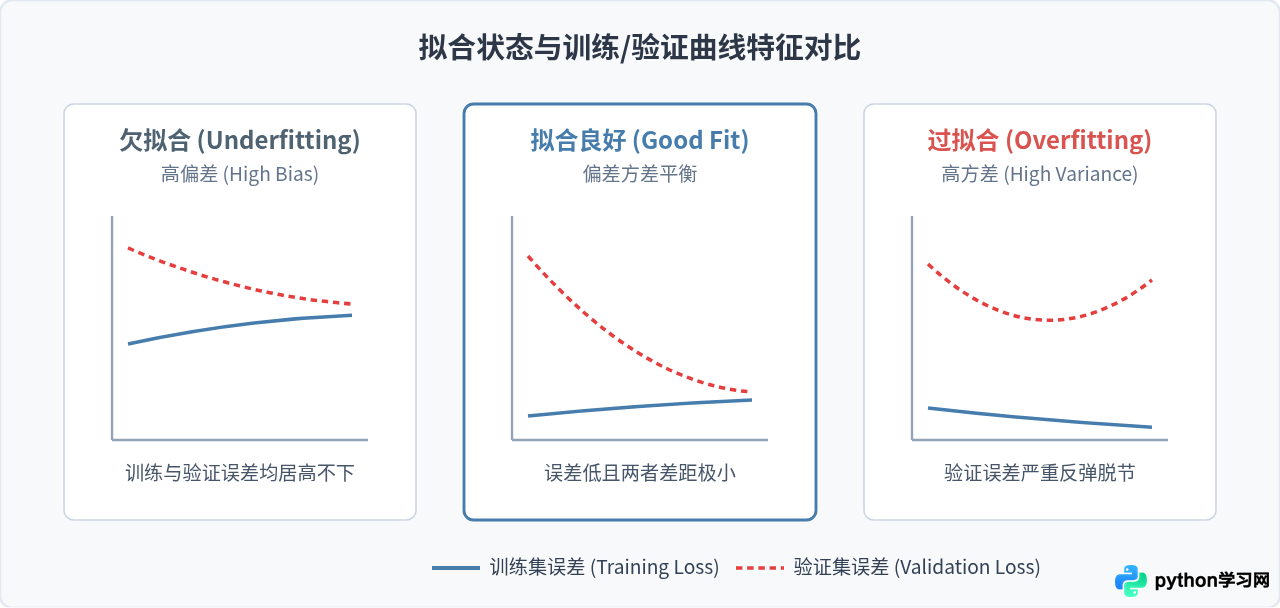 图1:欠拟合、良好拟合与过拟合在训练集和验证集误差曲线上的典型分歧对比
二、深挖根本:过拟合诱发的四大主因
要彻底治愈过拟合,必须先诊断模型究竟在哪一个环节失去了控制。在日常建模中,引发过拟合的因素通常可以划分为以下四类核心维度:
- 数据规模受限与噪声干扰:当有效训练样本容量相比任务复杂度严重匮乏时,模型很容易记住每一个特例的表象;若数据集中混杂着大量标错标签或异常传感器采集点,模型为了压低训练损失会强行构造曲折的决策边界去包容它们。
- 特征维度灾难与信息泄露:引入了过多与目标相关性极弱的无意义特征,或者特征提取时未对训练集与测试集严格隔离(如在拆分数据前就对全局执行标准化、目标编码或缺失值插补),导致未来信息隐蔽流入训练集。
- 算法自由度远超实际需求:在树模型中未限制树的最大深度(无约束展开直至纯叶节点),在线性模型中无限制升阶多项式,或者在样本较少的情况下搭建了数百万参数的深度神经网络。
- 训练过程失控:梯度下降类优化器迭代步数(Epochs)过长,未设定早停门限,使得模型在后期逐渐偏离普适趋势,转而精细拟合残差中的白噪声。
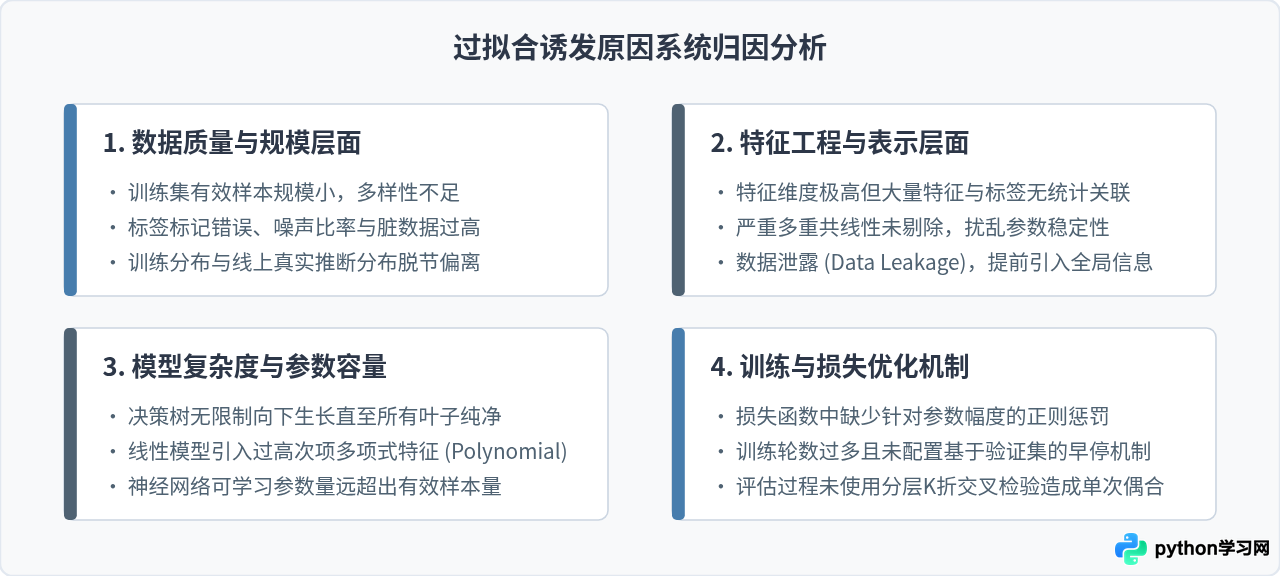 图2:诱发Python机器学习模型过拟合的四大关键原因矩阵
三、系统调优步骤与Scikit-Learn代码实战
解决过拟合并不是盲目修改一个参数,而是一个有章可循的递进排查与调优链条。建议严格按照以下步骤顺序逐步施加约束。
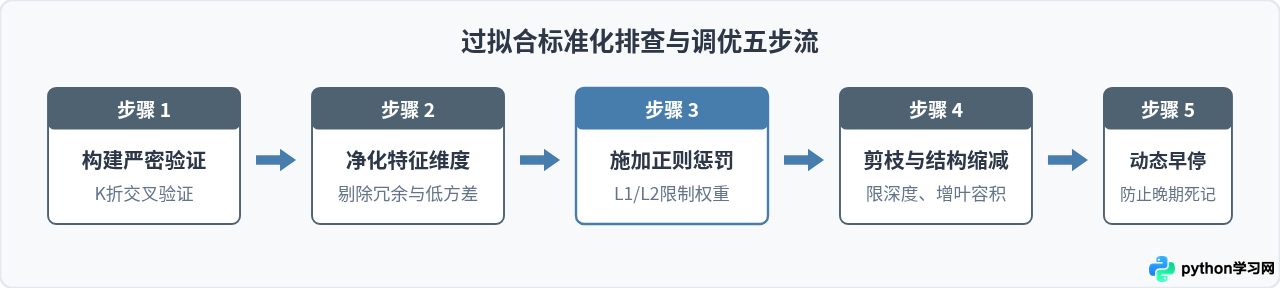 图3:过拟合调优标准执行路径
策略一:构建无泄露的评估框架(K折交叉验证)
在调优参数前,首先确保评估过程本身没有撒谎。在数据切分阶段,务必将特征工程与模型统一封装在 Pipeline 内部,避免任何数据统计量提前渗入测试子集:
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

# 构造高维且带有噪声的高过拟合风险数据
X, y = make_classification(n_samples=200, n_features=50, n_informative=10,
                           n_redundant=10, n_clusters_per_class=2, random_state=42)

# 使用 Pipeline 确保预处理严格封装在各折交叉验证中,杜绝数据泄露
pipe = Pipeline([
    ('scaler', StandardScaler()),
    ('clf', LogisticRegression(penalty='l2', C=1.0, solver='liblinear'))
])

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipe, X, y, cv=cv, scoring='accuracy')

print(f"5折交叉验证平均分: {scores.mean():.4f} (标准差: {scores.std():.4f})")
策略二:使用正则化约束参数空间(L1 / L2 正则化)
在线性回归、逻辑回归或SVM中,通过在损失函数后追加参数范数惩罚,强制让模型权重趋向于平缓或稀疏。L1正则化(Lasso)倾向于直接将无关特征的系数压缩至0,天然具备特征筛选能力;L2正则化(Ridge)则限制所有权重的绝对值大小,防止某一个特征权重过大主导预测:
from sklearn.linear_model import Lasso, Ridge

# L1 正则化:压缩无用特征权重至 0
lasso_model = Lasso(alpha=0.05, random_state=42)
lasso_model.fit(X, y)
nonzero_features = np.sum(lasso_model.coef_ != 0)
print(f"L1 稀疏化后保留的有效特征数量: {nonzero_features} / {X.shape[1]}")

# L2 正则化:收缩权重平滑边界
ridge_model = Ridge(alpha=10.0, random_state=42)
ridge_model.fit(X, y)
print(f"L2 正则化模型权重范数: {np.linalg.norm(ridge_model.coef_):.4f}")
策略三:决策树与集成算法的显式剪枝
决策树(DecisionTreeClassifier)在不加约束时会不断分叉直到叶节点基尼不纯度降为0,产生极其复杂的折线分界。在树模型中,控制过拟合的核心抓手是以下参数:
max_depth:限制树的最大深度,通常设置在3至8之间,切断深层异常样本细分。min_samples_leaf:规定单个叶节点所必须包含的最小样本数量(例如5或10),防止模型为个别噪声点独立分叉。min_samples_split:节点继续分裂所需的样本下限。max_features:每次分裂仅随机考虑子集特征,打散强特征的支配效应。
from sklearn.ensemble import RandomForestClassifier

# 针对集成树施加综合抗过拟合剪枝策略
rf_tuned = RandomForestClassifier(
    n_estimators=100,
    max_depth=5,              # 严格限制树深
    min_samples_leaf=4,       # 叶子节点最低样本容积
    min_samples_split=8,      # 分裂门限
    max_features='sqrt',      # 特征子采样
    bootstrap=True,           # 样本随机有放回抽样
    random_state=42
)
rf_tuned.fit(X, y)
策略四:梯度提升树中的学习率与早停机制(Early Stopping)
在LightGBM、XGBoost或Scikit-Learn的 HistGradientBoostingClassifier 中,如果树的数量(n_estimators)无限堆叠,后期生成的弱学习器会逐步拟合残差中的随机抖动。最佳策略是将学习率(learning_rate)调低,同时配置验证集早停:
from sklearn.ensemble import HistGradientBoostingClassifier

# 配置早停机制:当验证集连续多轮无改善时自动终止迭代
hgb = HistGradientBoostingClassifier(
    learning_rate=0.05,
    max_iter=500,
    early_stopping=True,      # 启用内置早停检测
    n_iter_no_change=10,      # 连续10轮验证集得分未提升则停止
    validation_fraction=0.15, # 内部预留15%数据用于跟踪泛化误差
    random_state=42
)
hgb.fit(X, y)
print(f"实际提前停止的迭代轮数: {hgb.n_iter_} / 500")
四、常见算法族过拟合调优速查
不同机器学习模型对不同抗过拟合手段的敏感度各异。下表整理了生产环境主流算法的调优优先级与核心参数组合:
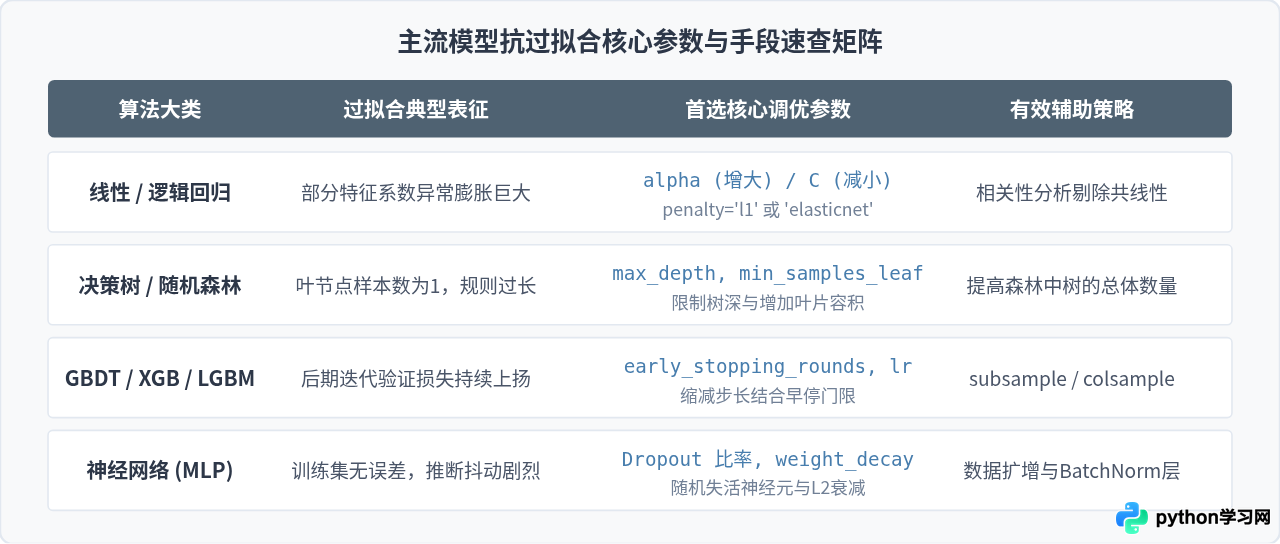 图4:四大类机器学习模型调优参数与对抗过拟合手段矩阵
五、调优过程中的关键注意事项
当开发者反复在同一个固定验证集上反复尝试上百组超参数(GridSearchCV)时,模型可能会逐渐适应验证集的随机特异性。这被称为“元过拟合(Meta-Overfitting)”。为了避免这种误判,工程中应当始终保留一份从始至终不参与任何调参和决策的独立测试集(Holdout Test Set),仅在最终部署前进行一次性验收打分。
另外,切勿在特征工程开始前使用全局数据计算均值或做归一化。必须在 Pipeline 内部针对训练折单独进行统计量计算,并在验证折上直接应用该统计量,从而坚决封堵由于数据泄露导致的“虚假完美泛化”。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















