


Python列表与字典操作入门:常用方法与实践示例
系统讲解Python列表(list)与字典(dict)的核心增删改查方法、切片与遍历技巧、底层内存与哈希寻址机制,并提供场景选型决策与常见避坑指南。
在Python编程中,列表(list)与字典(dict)是最常用且功能强大的两类内置复合数据类型。列表是有序、支持位置索引的元素序列,适合按序组织同质或线性数据;字典则是基于键值对映射的无序或保持插入序集合,适合通过唯一标识符进行高速检索。本文将系统拆解这两大数据结构的核心增删改查方法、切片与迭代技巧、底层寻址机制以及典型避坑准则,帮助读者在实际开发中写出严谨、高效的代码。
一、列表(List)基础操作与高频方法
列表使用方括号 [] 声明,支持存储任意类型的对象,且元素按插入顺序依次排列。列表具有可变性(Mutable),允许直接修改、追加或删除内部项。
1. 元素追加与插入
向列表中添加元素主要有三种方法:append() 将元素作为单一对象追加到末尾;insert() 在指定索引处插入元素,原位置及其右侧元素依次后移;extend() 接收一个可迭代对象,将其元素逐个追加到原列表末尾。
# 列表初始化与扩容示例
fruits = ["apple", "banana"]

# 1. append 追加单一项
fruits.append("orange")
print("append 后:", fruits)  # 输出: ['apple', 'banana', 'orange']

# 2. insert 指定位置插入
fruits.insert(1, "grape")
print("insert 后:", fruits)  # 输出: ['apple', 'grape', 'banana', 'orange']

# 3. extend 合并迭代对象
fruits.extend(["mango", "peach"])
print("extend 后:", fruits)  # 输出: ['apple', 'grape', 'banana', 'orange', 'mango', 'peach']
2. 元素删除与清空
删除列表元素同样根据场景分为按索引删除与按值删除:
pop([index]):移除并返回指定索引处的元素;若不传参则默认移除最后一个元素。若索引超出范围会抛出IndexError。remove(value):从左到右查找并移除首个匹配的值;若目标值不存在会抛出ValueError。del statement:使用 Python 原生语句del list[index]或del list[start:end]删除单个或连续区间元素。clear():清空列表内的所有元素,将其重置为空列表[]。
languages = ["Python", "Java", "C++", "Rust", "Go"]

popped_item = languages.pop()       # 默认弹出尾部元素 'Go'
print("弹出元素:", popped_item)      # 输出: Go

languages.remove("Java")            # 按值删除首个匹配项
print("remove 后:", languages)      # 输出: ['Python', 'C++', 'Rust']

del languages[1]                    # 删除索引为 1 的 'C++'
print("del 后:", languages)         # 输出: ['Python', 'Rust']

languages.clear()                   # 清空
print("clear 后:", languages)       # 输出: []
3. 索引访问与切片技巧
列表支持正向索引(从 0 到 len - 1)与反向负索引(从 -1 到 -len)。切片语法为 list[start:stop:step],属于左闭右开区间 [start, stop)。
nums = [10, 20, 30, 40, 50, 60]

print("正向首项:", nums[0])         # 输出: 10
print("反向末项:", nums[-1])        # 输出: 60
print("截取子集:", nums[1:4])       # 输出: [20, 30, 40]
print("步长采样:", nums[::2])       # 输出: [10, 30, 50]
print("反转列表:", nums[::-1])      # 输出: [60, 50, 40, 30, 20, 10]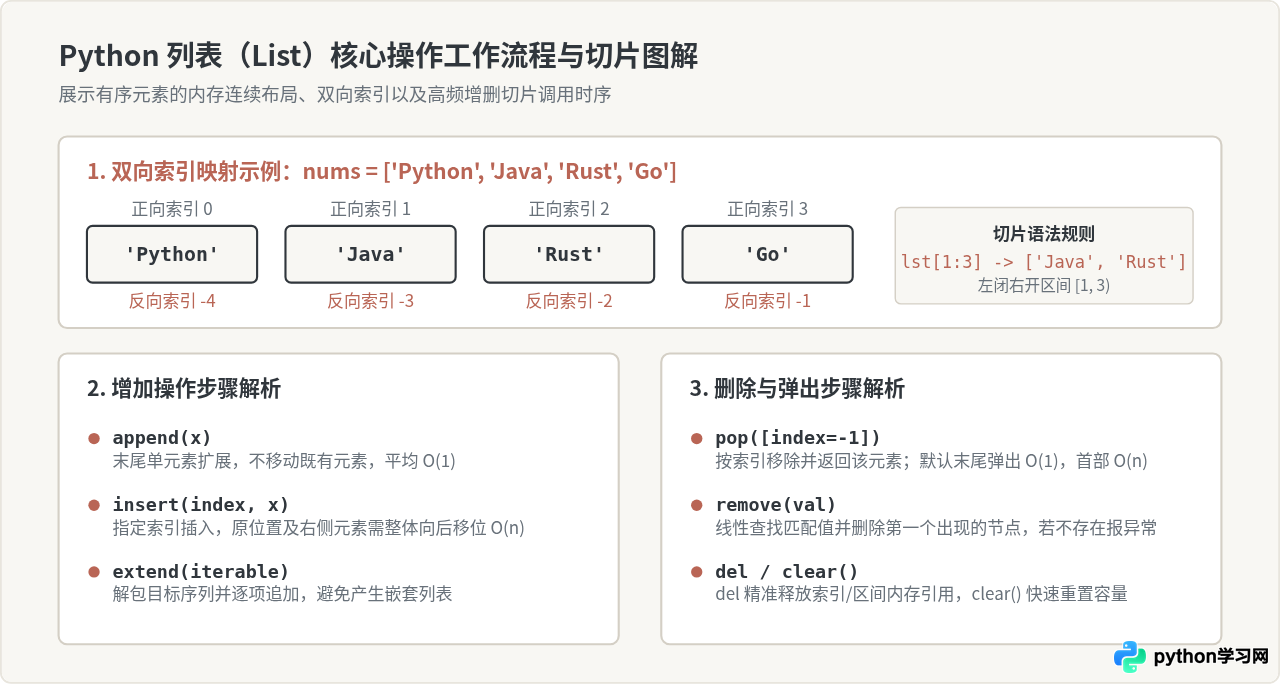
二、列表与字典的底层存储与寻址原理对比
理解数据结构的底层实现是掌握其性能特性与适用边界的关键:
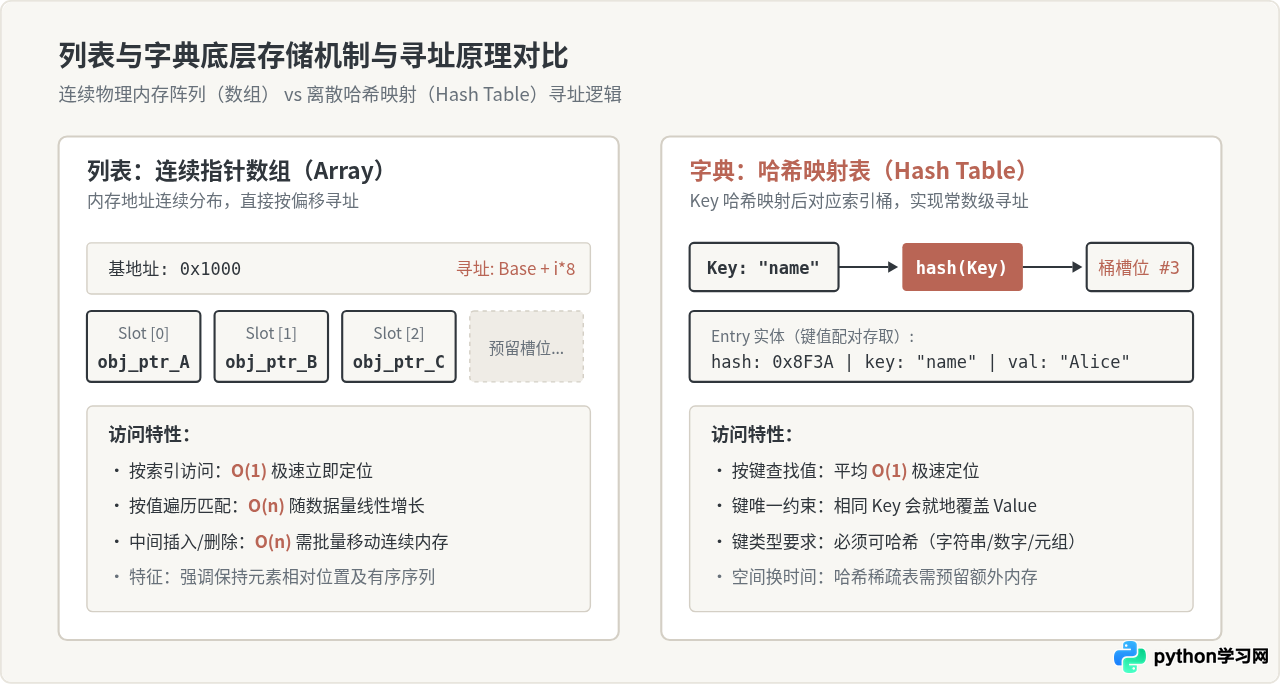
- 列表(连续数组):在 CPython 解释器中,列表本质是一个长度动态调整的连续指针数组(
PyListObject)。由于指针在内存中紧凑排列,通过索引获取元素时,可以通过基地址 + index * 指针字节长瞬间完成偏移寻址,因此下标访问的时间复杂度为O(1)。但如果通过值查找元素(例如item in my_list),必须从头开始逐个对比,时间复杂度为O(n)。 - 字典(哈希表):字典底层基于紧凑哈希表(Hash Table)实现。每一个存入字典的键(Key)必须是不可变且可哈希的对象(如字符串、整数、元组)。计算
hash(key)得到哈希值后映射至对应索引桶。查询时直接根据哈希定位对应槽位,不论字典中包含一千条还是一千万条数据,按键查找与存取的平均时间复杂度均接近O(1)。
三、字典(Dictionary)核心操作与常用方法
字典使用花括号 {} 声明,以 key: value 形式组织数据。Python 3.7+ 版本起,字典正式保证维持元素的插入顺序。
1. 键值的新增、修改与安全读取
对字典操作时,最常见的问题是使用方括号 d[key] 读取不存在的键会触发 KeyError 崩溃。推荐使用 get(key, default) 方法进行平滑容错访问。
# 字典初始化与修改
user = {"id": 1001, "username": "alex", "role": "editor"}

# 1. 直接赋值:键存在则修改,不存在则追加
user["status"] = "active"          # 新增键值对
user["role"] = "admin"             # 修改既有键的值

# 2. 安全读取 get 方法
email = user.get("email")          # 不存在返回 None,不报错
role = user.get("role", "viewer")  # 存在则返回 'admin'
phone = user.get("phone", "未登记") # 不存在返回默认值 '未登记'

print("读取状态:", user["status"])  # 输出: active
print("获取邮箱:", email)           # 输出: None
print("获取手机:", phone)           # 输出: 未登记
2. 字典删除与合并
pop(key[, default]):删除指定键并返回对应的值;如果键不存在且未提供 default,会抛出KeyError。popitem():按后进先出(LIFO)顺序移除并返回最后一个键值对元组(key, value)。del d[key]:直接删除字典中指定的键值对。update(other_dict)或|运算符(Python 3.9+):合并两个字典,后者覆盖前者同名键。
data = {"a": 1, "b": 2, "c": 3}

val_a = data.pop("a")             # 移除并返回值 1
last_item = data.popitem()        # 移除并返回 ('c', 3)
print("剩余字典:", data)           # 输出: {'b': 2}

# 字典合并:Python 3.9+ 推荐使用 | 运算符
config_base = {"theme": "light", "fontSize": 14}
config_user = {"fontSize": 16, "showLineNumber": True}
config_final = config_base | config_user
print("合并后配置:", config_final) # 输出: {'theme': 'light', 'fontSize': 16, 'showLineNumber': True}
3. 字典的遍历方式
字典支持按键、按值或同时按键值对进行迭代遍历:
scores = {"Math": 95, "English": 88, "Physics": 92}

# 遍历所有键 (默认 behavior: for k in scores)
for subject in scores.keys():
    print("科目:", subject)

# 遍历所有值
for score in scores.values():
    print("分数:", score)

# 推荐:解构遍历键值对 (items)
for subject, score in scores.items():
    print(f"{subject}: {score} 分")
四、数据结构选型:何时用列表?何时用字典?
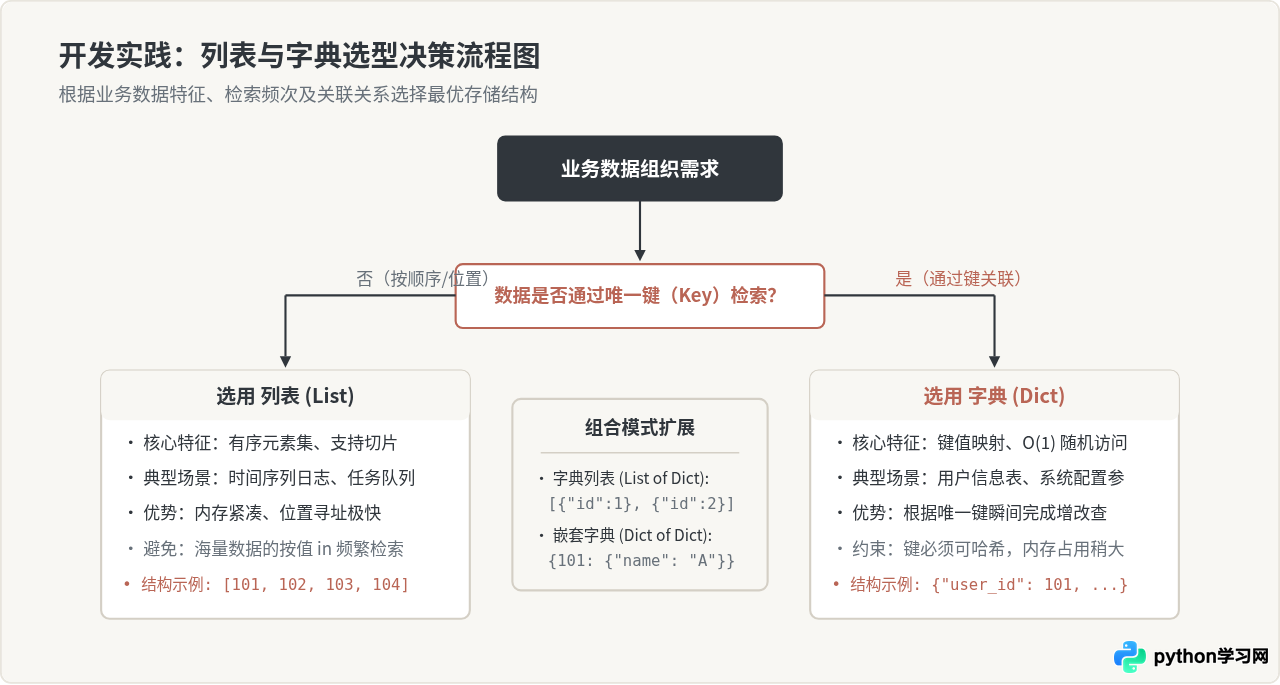
在编写业务逻辑时,很多初学者在选择数据容器时产生犹豫。做出合理选择的核心依据在于数据的组织特征与访问频率模式:
- 选择列表的场景:数据是同种类型的序列集合,天然关注先后顺序(如事件流日志、排队任务队列);或者经常需要通过数值位置下标、范围截取(切片)进行处理。
- 选择字典的场景:数据具有实体属性特征,需要通过唯一标识符或属性名高速反查对应内容;或者对特定数据的检索频率极高,不容忍线性扫描的性能开销。
- 复合结构的场景:在处理真实世界的复杂业务时,往往采用嵌套结构。例如“多行表格记录”通常表达为字典列表
[{"id": 1, "name": "a"}, ...];而“高频索引库”则表达为以唯一 ID 为键的嵌套字典{1: {"name": "a"}, ...}。
五、综合实践示例:列表与字典嵌套应用
在实际工程中,后端接口(如 REST API JSON 响应)几乎都以列表与字典嵌套的形式呈现。下面通过一个具体的电商购物车计算案例展示两者的协同配合:
# 电商订单与商品库处理实践
# 商品信息库(字典结构,便于 O(1) 按照 sku 快速定位单价与名称)
product_catalog = {
    "SKU_101": {"title": "机械键盘", "price": 299.0, "category": "数码"},
    "SKU_102": {"title": "无线鼠标", "price": 99.0, "category": "数码"},
    "SKU_103": {"title": "护眼台灯", "price": 149.0, "category": "家居"}
}

# 用户购物车项目(列表结构,按加购顺序排列,每项是一个记录买入数量的小字典)
cart_items = [
    {"sku": "SKU_101", "quantity": 1},
    {"sku": "SKU_102", "quantity": 2},
    {"sku": "SKU_103", "quantity": 1}
]

# 遍历购物车列表,从字典库中获取单价并计算总账单
total_cost = 0.0
summary_list = []

for item in cart_items:
    sku = item["sku"]
    qty = item["quantity"]

    # 使用 get 进行安全查找
    prod_info = product_catalog.get(sku)
    if prod_info:
        subtotal = prod_info["price"] * qty
        total_cost += subtotal
        summary_list.append({
            "name": prod_info["title"],
            "qty": qty,
            "subtotal": subtotal
        })

print(f"购物车结算总额: {total_cost:.2f} 元")
# 输出明细
for row in summary_list:
    print(f"- {row['name']} x {row['qty']} = {row['subtotal']:.2f} 元")
六、高频操作速查与新手避坑指南
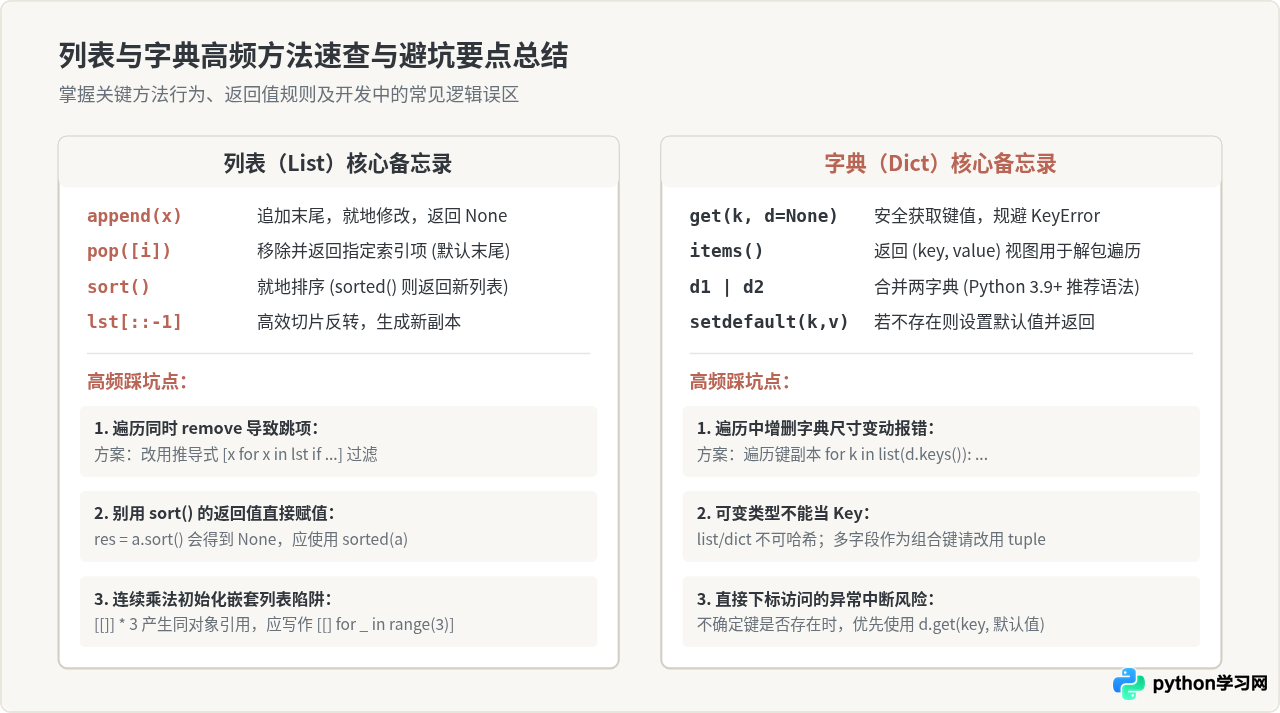
掌握了基本 API 之后,在实际编写 Python 代码时仍有几个极高频出现的典型陷阱需要格外警惕:
在执行
for item in my_list: my_list.remove(item) 时,由于列表长度在迭代中实时发生变化,迭代器的内部索引不会回退,会导致部分元素被直接跳过而漏删。正确做法:使用列表推导式生成新列表 my_list = [x for x in my_list if not condition(x)],或复制副本遍历 for item in my_list[:]: ...。字典在遍历时直接增删键则会直接抛出 RuntimeError: dictionary changed size during iteration,应改用 for k in list(d.keys()): ...。
执行
b = a 仅是创建了一个新的变量名指向同一个内存对象,修改 b 会导致 a 同时改变。浅拷贝使用 b = a.copy() 或 b = a[:],若列表/字典内部包含多层嵌套容器,则必须导入 copy 模块使用 copy.deepcopy()。
字典的 Key 必须满足可哈希性(Hashable)。若试图将列表作为 Key(例如
d[[1, 2]] = "test"),Python 解释器会抛出 TypeError: unhashable type: 'list'。若需要将一组元素组合作为复合键,应使用不可变的元组(tuple):d[(1, 2)] = "test"。
七、总结
掌握列表与字典是构建稳健 Python 应用的基石。在日常编码中,建议遵循以下实践标准:
- 根据数据访问的核心诉求确定容器类型:需要按顺序、下标和切片处理选择列表;需要通过唯一键以
O(1)极速检索属性选择字典。 - 始终关注代码健壮性:优先使用
d.get(k, default)代替硬性下标访问;避免在迭代循环体内直接修改容器长度。 - 多层嵌套数据进行赋值时,明确区分引用绑定与深浅拷贝,防止意外的全局副作用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















