


为什么选择Python做脚本语言:自动化运维与数据处理优势
深入解析为什么选择Python作为核心脚本语言,详尽分析其在自动化运维与大规模数据处理场景中的语法表达、生态库支持、异常可控性及流式处理优势。
在自动化运维与日常数据处理工作中,选择 Python 作为主力脚本语言的核心原因,在于它精准填补了“Shell 脚本复杂度上限”与“编译型语言高昂开发成本”之间的空白。Python 凭借高可读性的语法结构、涵盖系统操作与网络协议的完备标准库,以及成熟的数据计算生态,既能像常规脚本一样快速编写、即时调试,又能提供支撑大型自动化工程所需的异常安全、模块化封装与跨平台兼容性。
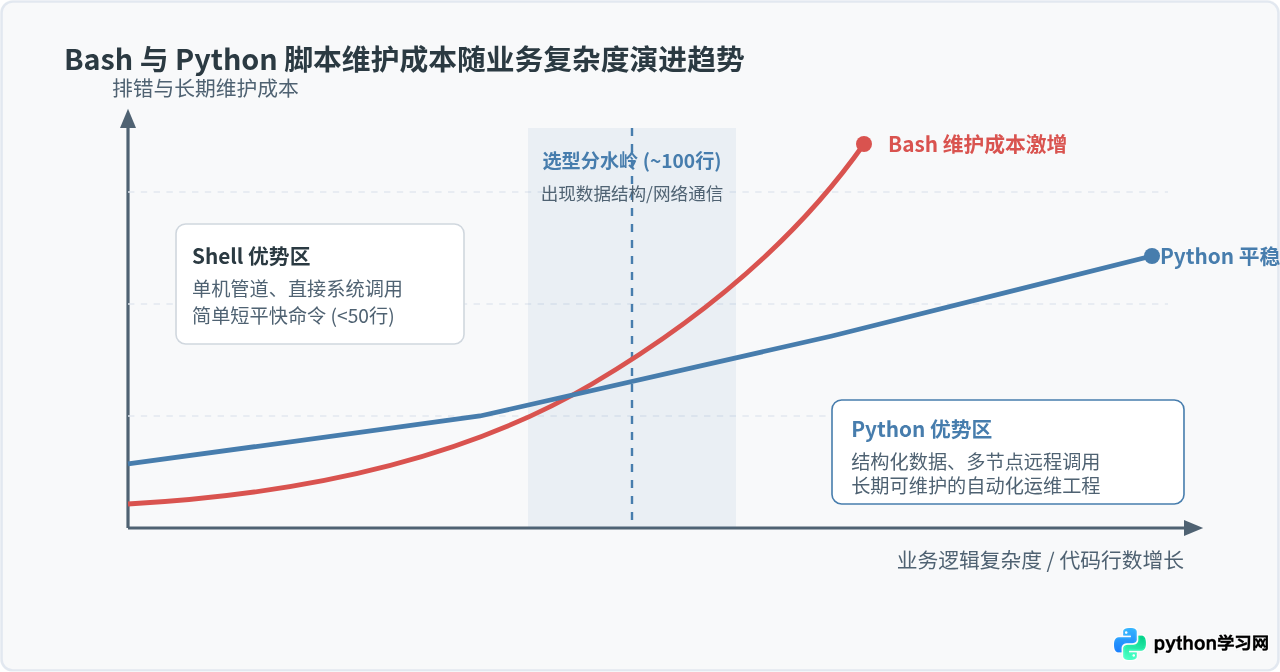
脚本语言的选型分水岭:从临时命令到工程化脚本
在工程实践中,编写脚本通常有两个截然不同的起点:一是快速组合多条系统命令完成临时巡检,二是构建长期运行、需要处理多样输入与错误恢复的自动化任务。对于几十行以内的简单命令串联,Bash 或 PowerShell 具备先天的命令行交互优势;但随着任务逻辑扩充至百行以上,涉及到多层数据解析或跨系统通信时,语言的承载能力便迎来分水岭。
Bash 这类传统外壳脚本的核心是将所有实体视作文本流。当运维脚本需要解析嵌套的 JSON 配置、对多个服务状态做字典映射,或者在网络超时时优雅回滚时,Shell 脚本往往必须拼凑 awk、sed、jq 等外部工具。这种拼凑带来了明显的缺陷:变量作用域模糊、缺乏严谨的数据结构、错误退出状态容易漏捕,且难以跨 Linux 发行版与 macOS 保持行为完全一致。
相比之下,Python 提供了确定性的面向对象与过程式抽象,所有数据结构皆为原生内存对象而非裸字符串,这使得逻辑表达直接且易于长期维护。
自动化运维维度的关键优势与实操范式
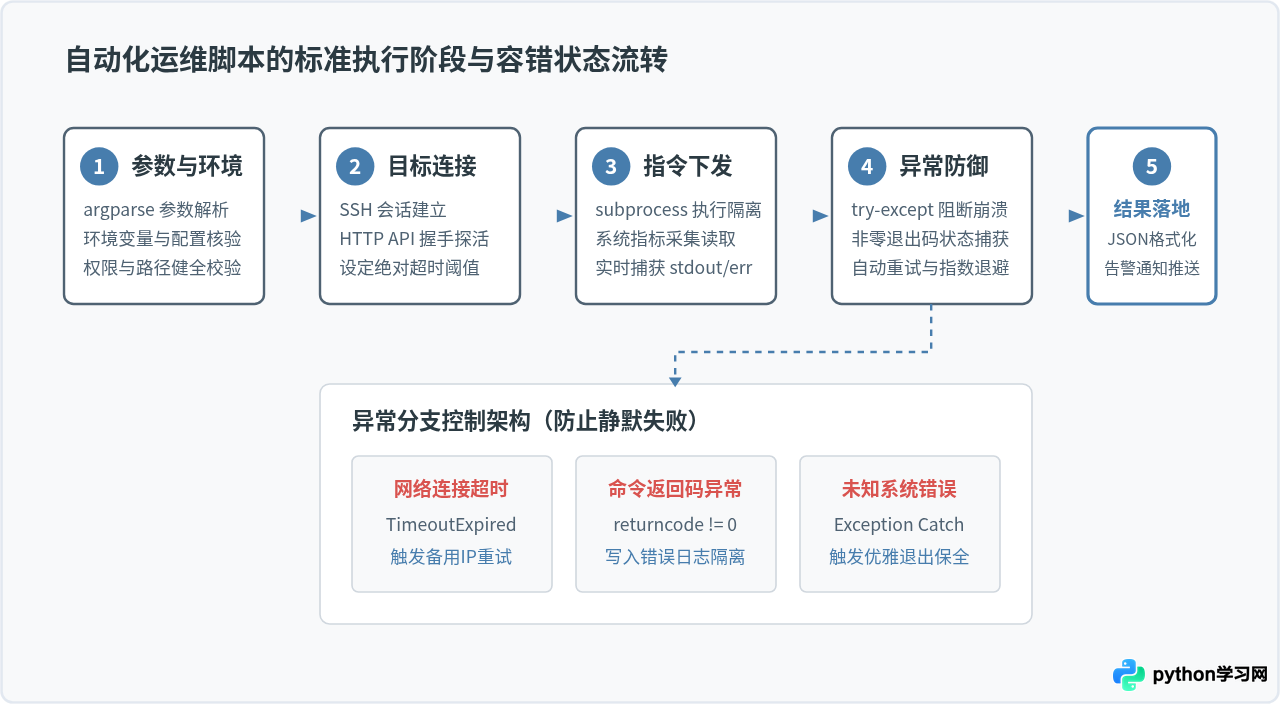
在自动化运维领域,脚本的稳定性和容错能力直接决定了线上设施的安全水平。Python 在这一场景中展现出三大核心优势:
- 完备无依赖的标准库:Python 自带
subprocess、os、pathlib、shutil、argparse等模块。运维脚本在不依赖任何第三方包的前提下,就能完成进程调度、标准输入输出流管控、路径规范化与完备的命令行参数解析。 - 严谨可控的异常捕获机制:在 Shell 中,一条命令失败通常需要显式判断
$?或开启set -e,但set -e很容易因为意料之外的退出码导致脚本提前崩溃。Python 采用标准的try-except-finally机制,能精确定位网络中断、权限不足或磁盘满载,并执行回滚或补救操作。 - 成熟的生产级基础设施生态:当需要扩展时,Python 拥有如
psutil(跨平台系统指标探针)、paramiko(SSH 自动化)、requests/httpx(HTTP API 交互)以及自动化部署工具链(Ansible、Fabric)的原生支持,避免重复造轮子。
实战示例:安全可控的多节点健康探测脚本
以下示例展示了一个规范的运维探活脚本。它使用 subprocess.run 进行具有超时控制的系统命令调用,通过字典结构组织结果,并统一格式化为 JSON 输出:
import argparse
import json
import logging
import subprocess
import sys
from pathlib import Path

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def check_host_ping(hostname: str, timeout_seconds: int = 2) -> dict:
    """执行安全 Ping 探测,捕获各种退出状态与超时异常"""
    cmd = ["ping", "-c", "1", "-W", str(timeout_seconds), hostname]
    result = {
        "target": hostname,
        "is_alive": False,
        "latency_ms": None,
        "error_msg": None
    }
    try:
        proc = subprocess.run(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE, text=True, timeout=timeout_seconds + 1)
        if proc.returncode == 0:
            result["is_alive"] = True
            # 解析延迟输出示例
            for line in proc.stdout.splitlines():
                if "time=" in line:
                    result["latency_ms"] = line.split("time=")[-1].split(" ")[0]
        else:
            result["error_msg"] = f"Ping failed with return code {proc.returncode}"
    except subprocess.TimeoutExpired:
        result["error_msg"] = "Ping operation timed out"
    except Exception as exc:
        result["error_msg"] = str(exc)
    return result

def main():
    parser = argparse.ArgumentParser(description="多主机网络连通性健康探测工具")
    parser.add_argument("--hosts", nargs="+", required=True, help="待检测主机列表,以空格分隔")
    parser.add_argument("--out", type=Path, default=None, help="检测结果输出 JSON 路径")
    args = parser.parse_args()

    reports = []
    for host in args.hosts:
        logging.info(f"正在探测目标节点: {host}")
        rep = check_host_ping(host)
        reports.append(rep)

    output_content = json.dumps(reports, indent=2, ensure_ascii=False)
    if args.out:
        args.out.write_text(output_content, encoding="utf-8")
        logging.info(f"探测报告已持久化至: {args.out}")
    else:
        print(output_content)

if __name__ == "__main__":
    main()
数据处理维度的核心能力与流式处理优势
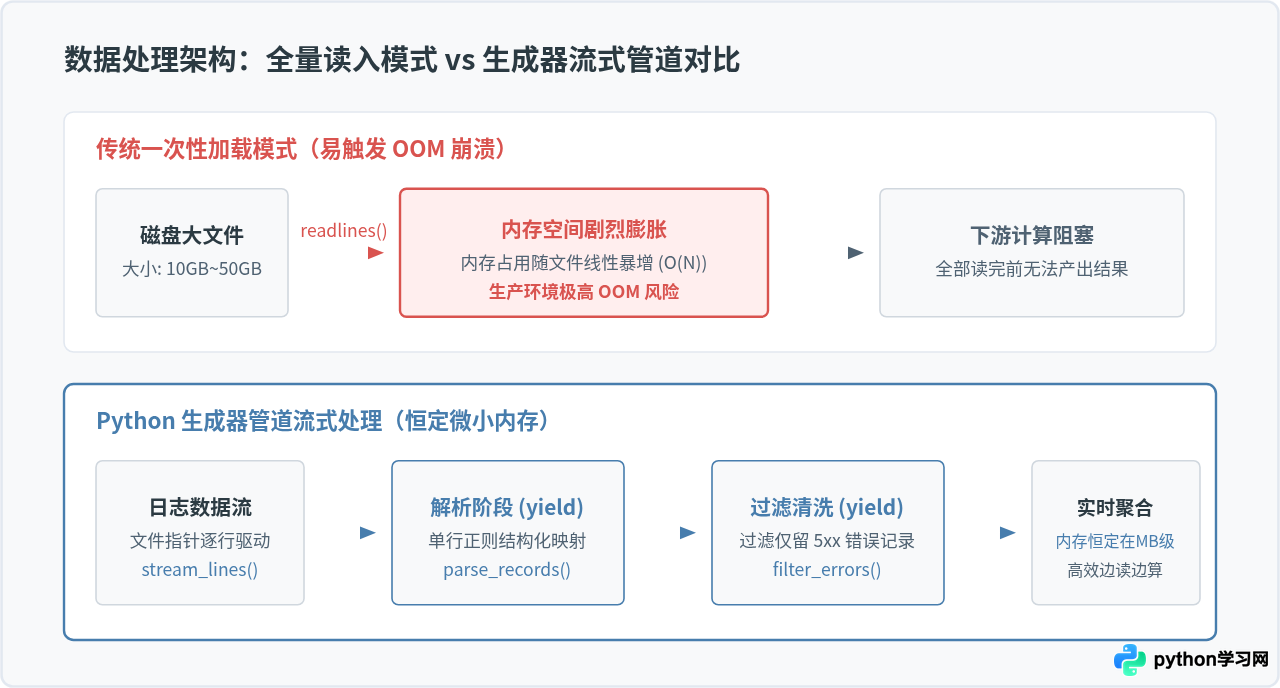
在数据处理场景中,日常脚本经常需要面对各类格式混杂的输入:从服务运行日志、CSV 报表导出,到 RESTful API 响应的复杂 JSON。Python 在数据处理领域的优势,不仅体现在语法糖的简洁,更在于底层对大规模数据流的内存控制能力:
- 结构化解析与内置序列化:Python 原生内置
json、csv、sqlite3模块,开发者无需安装任何外部轮子,即可在 5 行代码内完成“读取 CSV -> 过滤特定字段 -> 转成 JSON API 格式”的转换。 - 生成器(Generator)与流式惰性求值:很多使用脚本处理数吉字节(GB)日志的初学者,容易一次性使用
readlines()把整个文件载入内存,导致服务器触发 OOM(Out Of Memory)。Python 提供了极其简练的生成器语法(yield),允许以管道方式逐行拉取、逐行过滤,将内存开销始终压缩在数兆字节(MB)以内的恒定水平。 - 平滑演进到专业数据分析框架:当脚本从初期的“文本切分”升级到“多表关联、统计分组、趋势图表”时,Python 拥有行业标杆级的
pandas、polars与openpyxl。团队无需推倒重构已有逻辑,即可在同一脚本内直接引入分析工具。
实战示例:流式解析巨型日志文件的恒定内存模式
下面的示例演示了如何通过生成器构建一个流式过滤管道。即使面对一个 50GB 的 access.log,该脚本的内存占用也始终保持平稳:
import re
from typing import Generator, Dict, Any

# 匹配通用 Nginx 日志格式片段:IP [时间] "METHOD URL PROTO" STATUS
LOG_PATTERN = re.compile(r'^(?P<ip>\S+) \S+ \S+ \[(?P<time>[^\]]+)\] "(?P<method>\S+) (?P<path>\S+) \S+" (?P<status>\d{3})')

def stream_log_lines(filepath: str) -> Generator[str, None, None]:
    """生成器:按行惰性流式读取,不一次性占用内存"""
    with open(filepath, "r", encoding="utf-8", errors="replace") as f:
        for line in f:
            yield line

def parse_access_records(lines: Generator[str, None, None]) -> Generator[Dict[str, Any], None, None]:
    """管道阶段:逐行正则解析,过滤并产出结构化字典"""
    for line in lines:
        match = LOG_PATTERN.match(line)
        if match:
            data = match.groupdict()
            data["status"] = int(data["status"])
            yield data

def filter_server_errors(records: Generator[Dict[str, Any], None, None]) -> Generator[Dict[str, Any], None, None]:
    """管道阶段:仅保留 5xx 服务端错误记录"""
    for rec in records:
        if rec["status"] >= 500:
            yield rec

def main():
    # 组装管道:打开数据流 -> 解析记录 -> 过滤错误
    log_source = stream_log_lines("/var/log/nginx/access.log")
    parsed_stream = parse_access_records(log_source)
    error_stream = filter_server_errors(parsed_stream)

    # 消费管道:累计错误计数与 IP 聚合
    error_ip_counts = {}
    for error_record in error_stream:
        ip = error_record["ip"]
        error_ip_counts[ip] = error_ip_counts.get(ip, 0) + 1

    print(f"5xx 故障 IP 统计汇总: {error_ip_counts}")

if __name__ == "__main__":
    main()
脚本工程化落地的实用规范与避坑建议
虽然 Python 门槛较低,但如果不遵循工程规范,脚本很容易沦为难以维护的“玩具代码”。在生产环境中编写运维与数据脚本时,应当遵循以下实践:
os.system("awk ... | grep ...") 的反模式拼凑命令。这种方式既丢失了 Python 的类型与异常控制,又引入了 Shell 注入风险。当需要调用外部工具时,始终优先使用 subprocess.run(..., check=True) 并传入安全的列表参数。
- 合理使用类型注解(Type Hints):给核心函数参数与返回值注明类型(如
hostname: str,timeout: int -> dict)。这不仅能让 IDE 提供精准的代码补全,还能在团队协作中充当最直接的文档。 - 运行环境与依赖隔离:运维脚本尽量优先使用纯标准库编写(Zero-dependency),以便于在各个裸机节点上直接拷贝即用;若必须使用第三方依赖,使用
venv建立独立虚拟环境,或借助pipx运行 CLI 工具,杜绝污染系统自带的 Python 解析器。 - 标准日志代替 print 输出:使用标准库
logging替代无序的print(),确保输出包含时间戳、日志级别(INFO/WARNING/ERROR)与调用模块,为后续的集中式日志收集提供统一格式。
脚本语言综合选型决策指南
在面对具体的项目与任务时,不同语言有着明确的适用场景。下表对比了 Bash、Python 与 Go 在自动化与数据处理场景中的关键属性:
| 评估维度 | Shell (Bash / Zsh) | Python | Go (Golang) |
|---|---|---|---|
| 开发与迭代速度 | 极快(单行命令组合) | 极快(语法简洁,生态开箱即用) | 中等(需定义强类型与编译) |
| 数据结构与解析 | 弱(纯文本流,需依赖 jq/awk) | 极强(原生支持复杂字典/列表/JSON) | 强(强类型结构体定义) |
| 异常与错误排查 | 容易漏捕,调试依赖 set -x | 精确 Traceback,严谨异常处理 | 显式 error 检查,编译期拦截 |
| 部署依赖性 | 系统自带,无需安装 | 依赖解释器(大部分 Linux 默认内置) | 单二进制文件,无外部依赖 |
| 最佳适用场景 | 短平快命令行包装、容器入口引导 | 自动化运维、数据流管道、API 胶水任务 | 高并发守护进程、常驻代理 (Agent) |
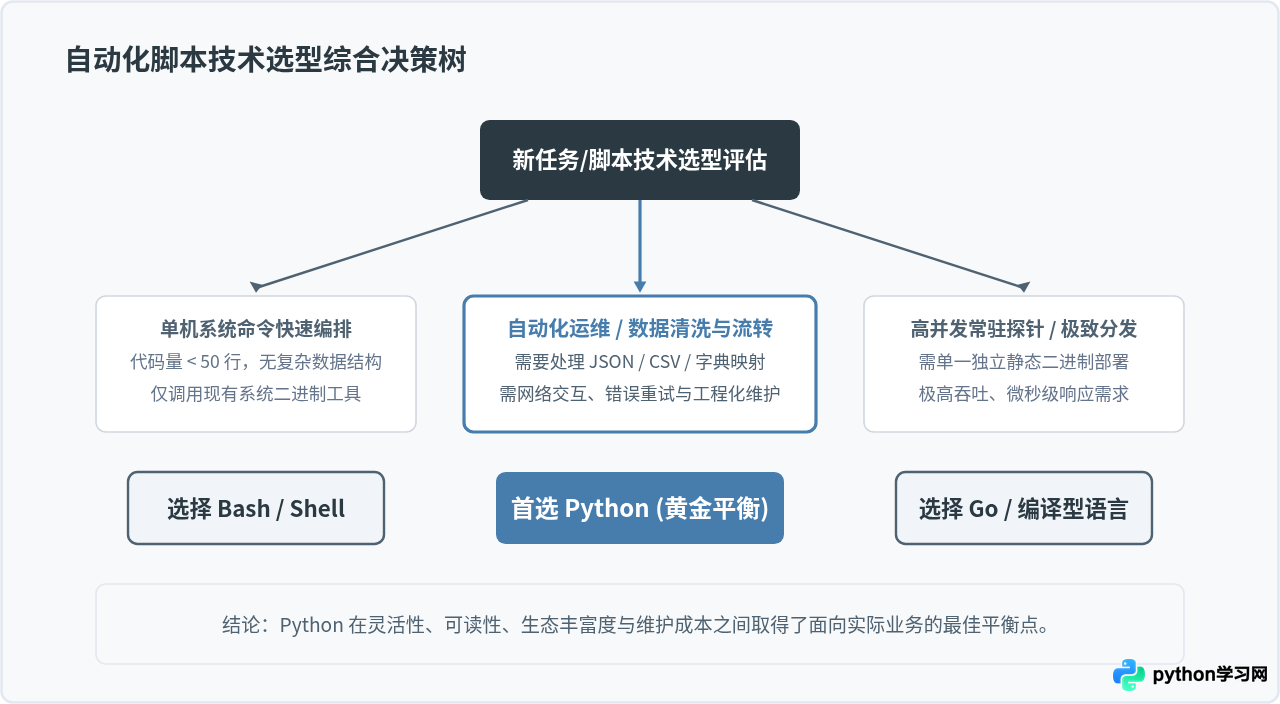
综上所述,选择 Python 作为脚本语言,并非盲目追求语言的全面性,而是基于工程交付效率与系统可靠性的理性权衡。它既能够满足编写脚本时“短平快、立即可见”的快速验证诉求,又具备构建可靠、自愈且易于维护的生产级自动化运维与数据流管道所需的全部底座能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















