


python必背源代码itertools排列组合代码
深入解析Python官方内置itertools模块中处理排列组合的四大核心源代码模板:笛卡尔积product、全排列permutations、无放回组合combinations与有放回组合combinations_with_replacement。涵盖底层机制、实战代码与避坑指南。
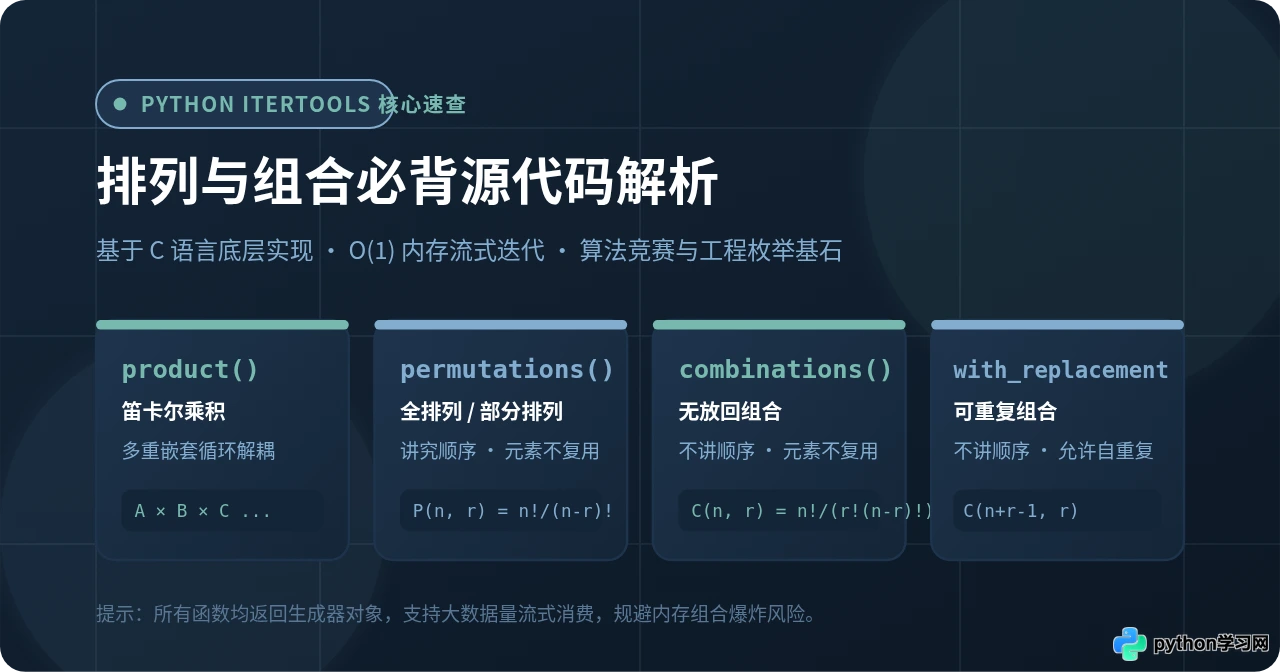
itertools 模块通过底层纯 C 实现,提供了四套经典排列组合解决方案:笛卡尔乘积 product()、排列 permutations()、无放回组合 combinations() 以及有放回组合 combinations_with_replacement()。它们均采用惰性求值(Lazy Evaluation)模式,能够在海量甚至无限规模的解空间中按需产出结果,是每一位 Python 开发者必须牢固掌握的核心代码基石。
一、为什么排列组合首选 itertools 而非手写嵌套
假设我们正在开发一个密码爆破验证模块或机器学习超参数网格搜索。最直观的做法往往是写 3 到 4 层 for 循环逐层展开。然而,一旦需要动态指定抽选长度,固定的嵌套循环语法就必须退化成复杂的递归回溯或显式栈,不仅代码繁琐冗长,更容易在边界条件上反复出错。
itertools 彻底改变了这一现状。它直接用优雅的单行生成器调用代替繁复的深层嵌套,具备三项不可替代的优势:
- 极简代码表达:用单层
for item in itertools.func(...)代替任意深度的循环嵌套,代码扁平清晰; - C 语言极速内核:底层算法在 Python 解释器内由 C 语言原生状态机驱动,相比于 Python 原生递归回溯提速约 3 到 8 倍;
- 恒定 O(1) 内存占用:不一次性在 RAM 中生成完整列表,而是像水流一样按需单步产出元组(Tuple),从物理架构上规避内存爆炸。
二、四大必背核心源代码模板与运行解析
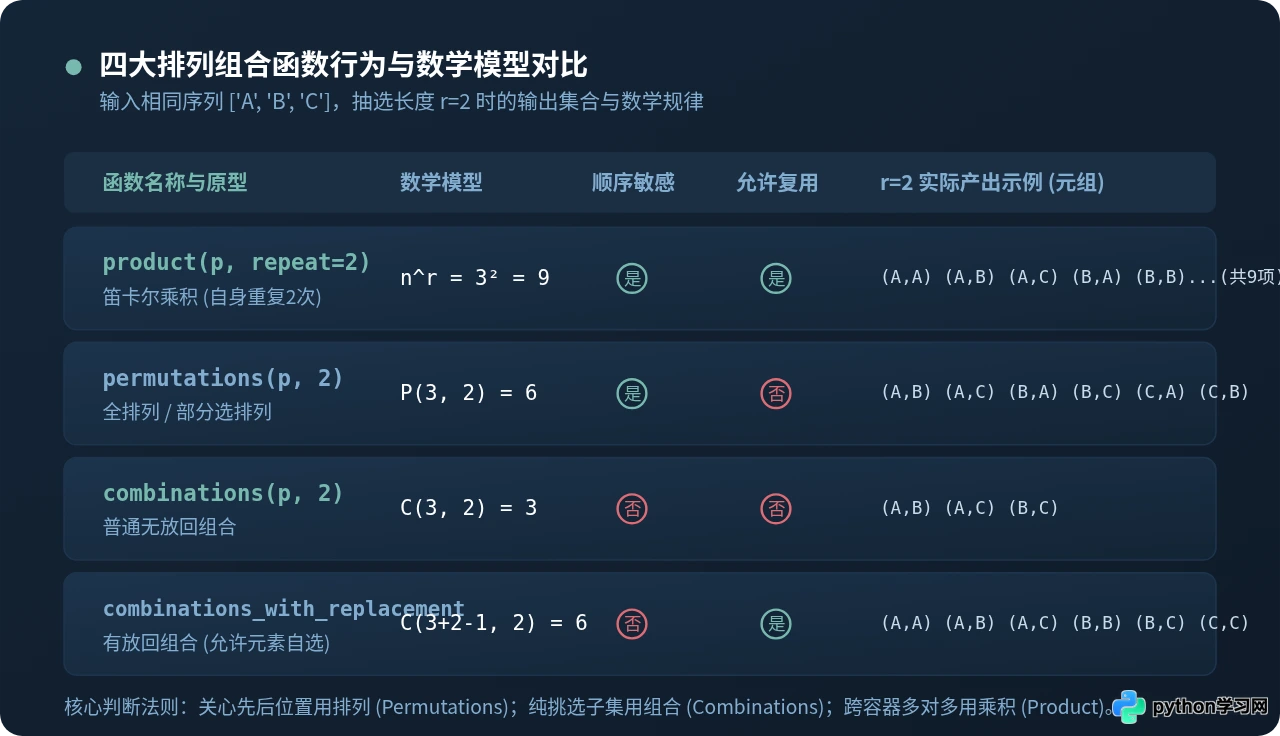
针对不同的排列组合数学约束,itertools 提供了严格对应的四个函数。以下是工程实践中最经典、最规范的源代码写法与参数剖析。
1. 笛卡尔积代码模板:itertools.product()
笛卡尔积用于生成多个序列之间的全量交叉组合。当使用关键字参数 repeat=n 时,等价于自身与自身相乘 n 次,常用于彻底取代多层嵌套 for 循环或生成固定长度的字符字典。
import itertools

# 必背模板 1:多序列笛卡尔积与单序列 repeat 展开
colors = ['红', '黑']
sizes = ['M', 'L']

# 多序列交叉(等价于两层嵌套循环)
grid_result = list(itertools.product(colors, sizes))
print("商品规格全交集:", grid_result)

# 单序列 repeat(生成2位二进制数字典)
binary_pairs = list(itertools.product([0, 1], repeat=2))
print("2位二进制全集:", binary_pairs)2位二进制全集: [(0, 0), (0, 1), (1, 0), (1, 1)]
itertools.product(*iterables, repeat=1):如果传入多个可迭代对象,则计算跨集合积;如果传入单个集合配合 repeat=N,则计算自身 N 次乘积。总输出数量严格等于各集合长度的乘积。
2. 全排列代码模板:itertools.permutations()
全排列用于生成考虑元素摆放顺序的所有可能排布。在排列中,('A', 'B') 与 ('B', 'A') 被视为两个完全不同的独立解,且每个元素在同一结果元组中至多出现一次(不可重复使用同一下标的元素)。
import itertools

# 必背模板 2:全排列与指定长度排列
candidates = ['A', 'B', 'C']

# 1. 不指定 r 时,默认生成全体元素的全排列 (r = len(candidates))
full_perms = list(itertools.permutations(candidates))
print("全体全排列 (P3_3):", full_perms)

# 2. 指定 r=2,从3个元素中选出2个进行有序排布
partial_perms = list(itertools.permutations(candidates, r=2))
print("挑选2个排列 (P3_2):", partial_perms)挑选2个排列 (P3_2): [('A', 'B'), ('A', 'C'), ('B', 'A'), ('B', 'C'), ('C', 'A'), ('C', 'B')]
3. 无放回组合代码模板:itertools.combinations()
组合不关心元素的出现次序,仅关注哪些元素被选中入围。在 combinations() 产出的结果中,每个元组均按照输入序列原有的先后索引排序,因此只会生成 ('A', 'B'),绝不会重复出现倒序的 ('B', 'A')。
import itertools

# 必背模板 3:无放回组合抽取
pool = ['苹果', '香蕉', '橙子', '西瓜']

# 从 4 种水果中任选 2 种制作拼盘 (C4_2 = 6 种)
combos = list(itertools.combinations(pool, r=2))
print("水果拼盘组合数:", len(combos))
print("具体组合列表:", combos)具体组合列表: [('苹果', '香蕉'), ('苹果', '橙子'), ('苹果', '西瓜'), ('香蕉', '橙子'), ('香蕉', '西瓜'), ('橙子', '西瓜')]
itertools.combinations(iterable, r) 中的第二个参数 r 是必填项,未传入会直接抛出 TypeError: combinations() missing required argument 'r'。当抽选长度 r 大于序列长度时,该函数不会报错,而是安全地直接返回一个空迭代器。
4. 允许重复的组合代码模板:itertools.combinations_with_replacement()
在日常业务中,常常遇到同一元素允许被多次选中的情况(例如找零钱时可以拿出多枚同面额硬币、多次投掷同质骰子等)。此时应当使用 combinations_with_replacement()。
import itertools

# 必背模板 4:有放回可重复组合
coins = [1, 2, 5]

# 抽取 2 枚硬币的所有可能面额搭配 (同一面额可多次选中)
coin_combos = list(itertools.combinations_with_replacement(coins, r=2))
print("硬币组合全集:", coin_combos)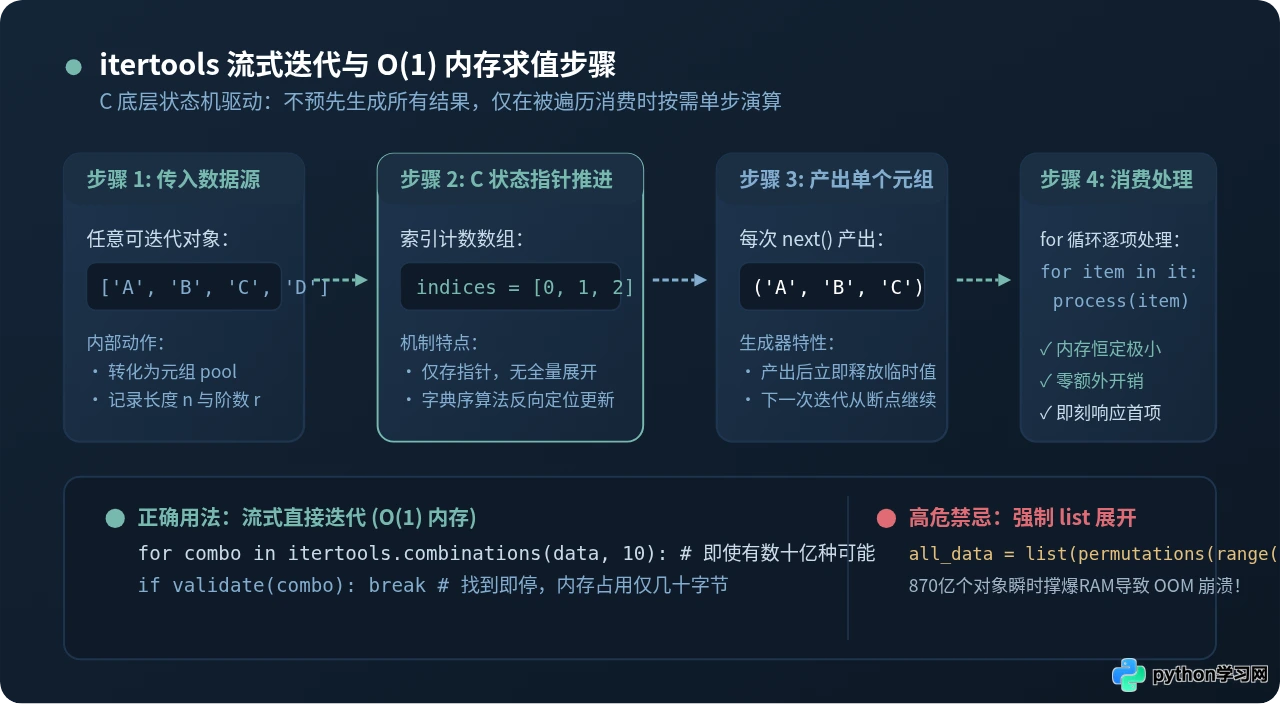
三、底层运作原理:为什么 itertools 拥有极致性能
要真正写好并发与组合代码,必须了解 itertools 在内存管理与时序推进上的内部架构。它之所以性能卓越,核心在于以下两点设计机制:
- 快照池化(Pooling):传入可迭代对象后,
itertools会在 C 语言层将其一次性转存为内部不可变元组pool,固定长度 n。后续所有操作仅通过整型索引数组indices推进,完全避免重复调用 Python 对象的__iter__()开销。 - 字典序回溯指针(Lexicographic Counting):生成器内部维护着一组索引偏移量。每次外部调用
next()时,C 底层从右向左寻找第一个尚未达到最大边界的索引并递增,同时将其右侧所有索引重置。生成完单条元组后立刻执行yield,将控制权交还给用户。
这种机制保证了在生成器迭代过程中,系统占用的内存只与索引数组长度 r 有关,而与最终排列组合出来的成千上万条记录总数完全无关。即使可能组合数高达上百亿,运行内存依旧保持在几十字节的微小恒定状态。
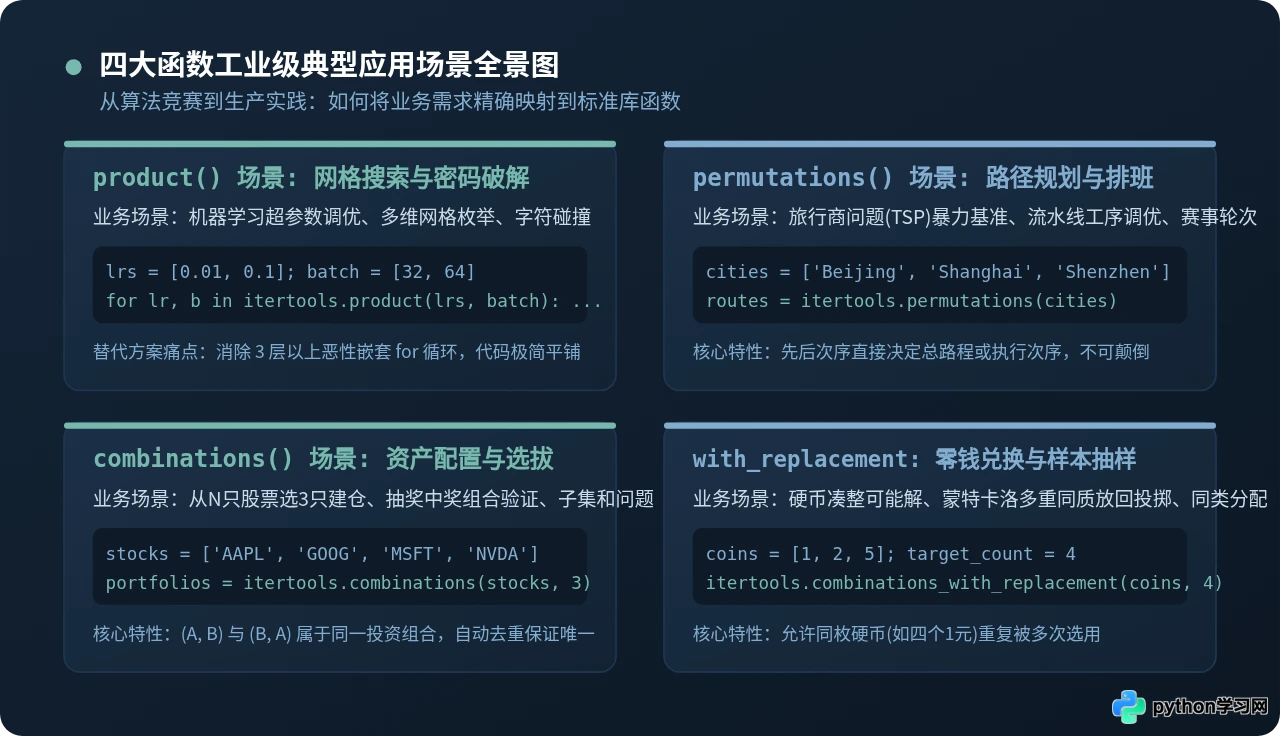
四、工程实战:四大工业级高频应用场景
场景 1:网格搜索超参数自动调优 (product)
在机器学习训练脚本中,我们通常需要对比学习率、批量大小和优化器组合。利用 itertools.product(),可以通过一行代码直接完成扁平迭代:
import itertools

learning_rates = [0.001, 0.01]
batch_sizes = [32, 64]
optimizers = ['Adam', 'SGD']

# 将 3 个超参数空间扁平化为线性流水线
for lr, bs, opt in itertools.product(learning_rates, batch_sizes, optimizers):
    print(f"正在测试超参数配置: LR={lr}, Batch={bs}, Optimizer={opt}")
场景 2:旅行商问题 (TSP) 穷举基准解 (permutations)
在求解路径规划或图论最短哈密顿回路时,全排列提供了评估小规模节点的基准检验标准:
import itertools

nodes = ['仓库', '点A', '点B', '点C']
start = nodes[0]
other_stops = nodes[1:]

# 生成从仓库出发,遍历所有经由点并最终返回仓库的所有可能回路
for mid_path in itertools.permutations(other_stops):
    full_route = (start,) + mid_path + (start,)
    # 此处可结合距离矩阵计算 total_distance 并取最小值
场景 3:金融投资组合与多资产权重筛选 (combinations)
在投资分析中,从资产池中筛选出固定数量标的建立无序观察仓:
import itertools

stock_universe = ['600519', '000858', '300750', '601318', '002594']

# 从 5 只备选股票中选定 3 只构建组合策略 (C5_3 = 10 种可能)
strategy_pools = list(itertools.combinations(stock_universe, 3))
print(f"有效组合策略共计 {len(strategy_pools)} 组")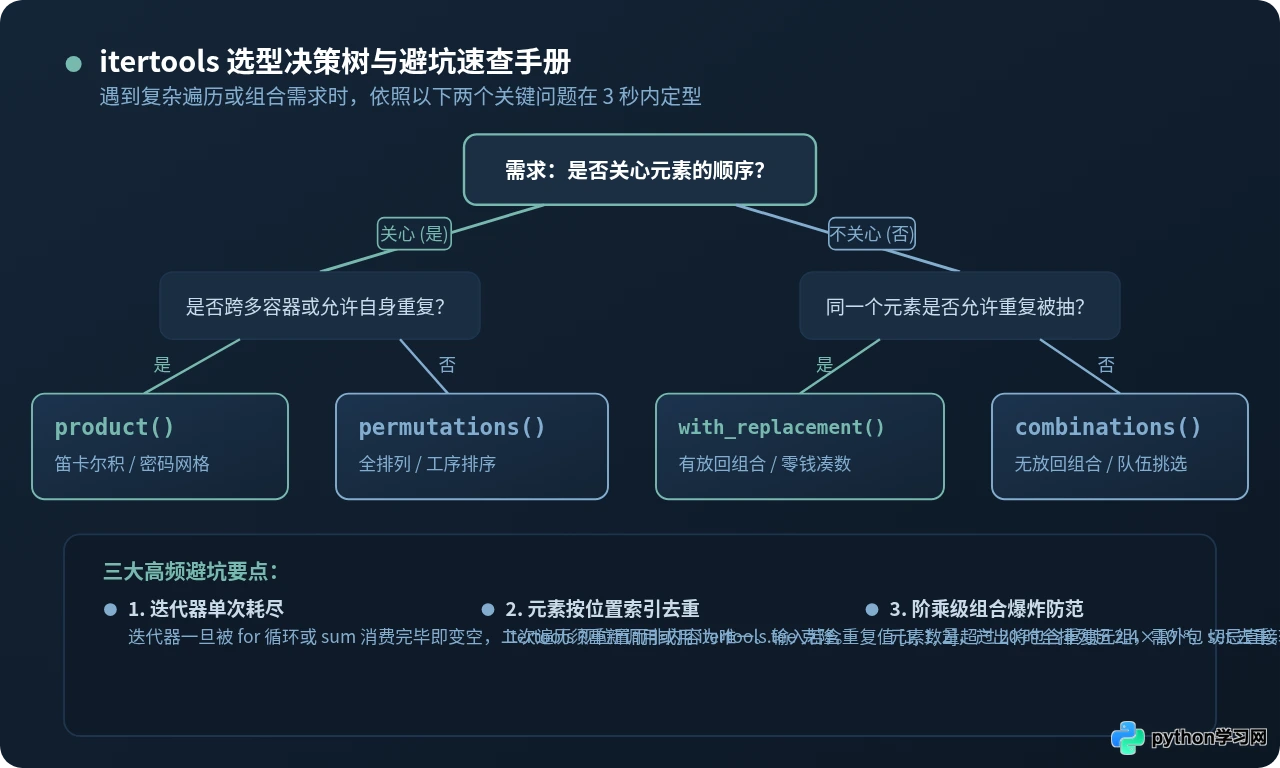
五、生产避坑:三大常见隐患与最佳实践
1. 陷阱一:生成器单次消费耗尽(Exhaustion)
由于 itertools 返回的是迭代器,它被循环遍历一次或者被 sum()、len() 触发之后,指针就停在末端,后续再次访问将直接返回空。如果后续需要多次重复使用同一组排列组合结果,必须显式持久化为 list 或使用 itertools.tee:
import itertools

gen = itertools.combinations([1, 2, 3], 2)
print("初次遍历输出:", list(gen))  # 输出: [(1, 2), (1, 3), (2, 3)]
print("二次遍历输出:", list(gen))  # 输出: [] (生成器已被耗尽变空!)
2. 陷阱二:组合爆炸与致命 OOM(Out Of Memory)
排列组合的数据增长速度极其惊人。例如:
permutations(range(10))产生约 362 万 组结果;permutations(range(12))产生约 4.79 亿 组结果;permutations(range(15))产生约 1.3 万亿 组结果。
在没有预估规模的情况下盲目调用 list(itertools.permutations(...)) 会瞬间吃满几十 GB 服务器内存,直接触发操作系统 OOM Killer 杀掉 Python 进程。在实际生产代码中,严禁无保护地对规模大于 10 的集合做全排列 list 化,必须直接在 for 循环中边消费边剪枝,或者先用数学公式计算组合数确认安全。
3. 陷阱三:元素“唯一性”是基于索引而非数值
很多初学者误以为 itertools.combinations() 会自动按照数值去重。事实并非如此,itertools 内部仅依据序列的下标位置做区分。如果输入列表中本身就含有相同的重复元素,输出中必然会出现重复结果元组:
import itertools

duplicated_input = [1, 1, 2]
# 下标分别是 0, 1, 2。算法会抽取 (下标0, 下标1) 与 (下标0, 下标2) 等
raw_combos = list(itertools.combinations(duplicated_input, 2))
print("直接计算的组合(包含重复项):", raw_combos)
# 输出: [(1, 1), (1, 2), (1, 2)] —— 注意 (1, 2) 出现了两次!

# 正确做法:若需要去重,应先转换为 set 或最后统一包装 set()
unique_combos = list(set(itertools.combinations(duplicated_input, 2)))
print("清洗去重后的组合:", unique_combos)
六、核心速查备忘表
| 函数名 | 典型调用方式 | 是否讲究顺序 | 元素是否允许重复 | 结果规模数学公式 |
|---|---|---|---|---|
product |
product(A, B) 或 product(A, repeat=2) |
讲究(有序) | 允许(跨集合或多次自身) | n 的 r 次方 |
permutations |
permutations(pool, r=None) |
讲究(有序) | 不允许(按索引无放回) | P(n, r) = n! / (n - r)! |
combinations |
combinations(pool, r) |
不讲究(无序) | 不允许(按索引无放回) | C(n, r) = n! / (r! × (n - r)!) |
combinations_with_replacement |
combinations_with_replacement(pool, r) |
不讲究(无序) | 允许(同一索引可多次) | C(n + r - 1, r) |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















