


为什么pandas3.0推荐配合PyArrow使用?
深入解析pandas 3.0推荐使用PyArrow后端的底层原因,全面对比NumPy与Arrow在内存布局、字符串处理、缺失值支持与Parquet零拷贝I/O上的核心差异,并提供详细的启用与迁移操作步骤。
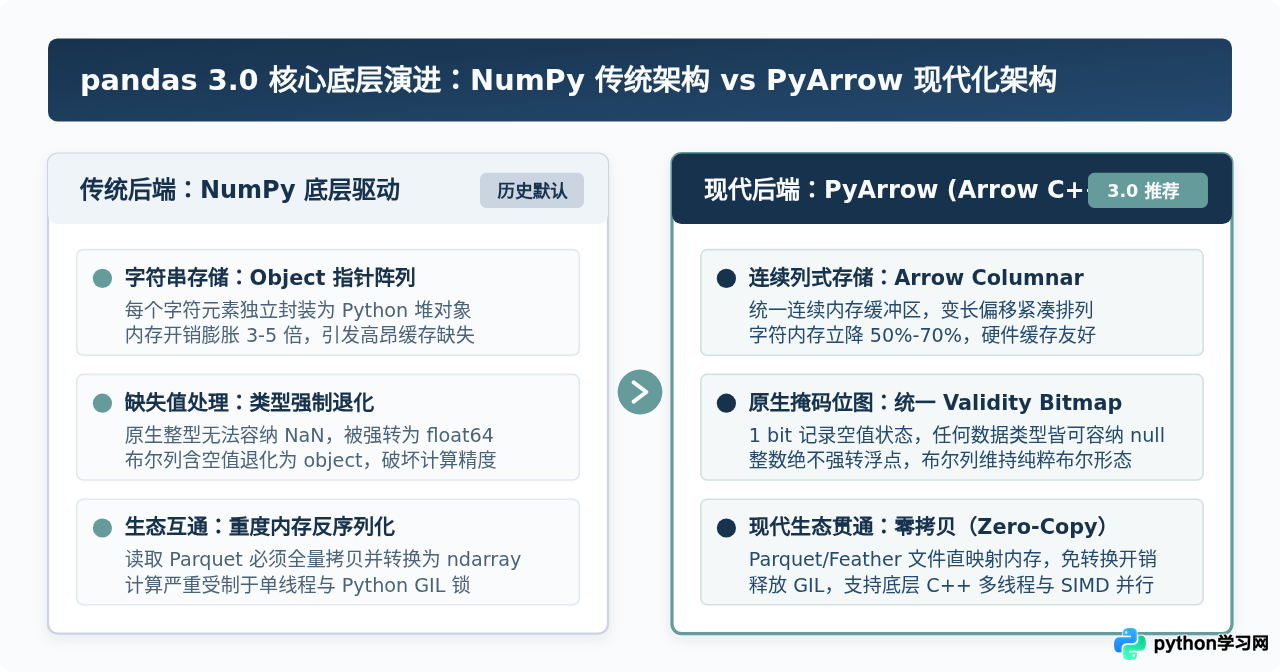
pandas 3.0 推荐配合 PyArrow,主要是为了彻底解决长期由 NumPy 驱动所带来的四大性能与设计瓶颈:字符串采用 Python Object 指针数组导致的内存膨胀与运算迟缓、缺乏原生缺失值导致整型强制转浮点的类型失真、读写 Parquet 等现代文件格式时高昂的双重内存拷贝,以及高级复杂数据类型表达能力的不足。通过将底层数据表示无缝迁移至 Apache Arrow 标准的列式内存模型,pandas 能够在保持现有 API 习惯的前提下,将内存占用降低 50% 至 70%,数据载入与字符串处理速度成倍提升,并与 DuckDB、Polars 等现代分析引擎实现零拷贝互通。
一、内存与运算瓶颈:NumPy Object 存储字符串的局限
NumPy 最初是为密集的定长同质数值数组设计的,底层通过一片固定跨度(stride)的连续 C 数组来保证计算效率。然而,现实数据分析场景中充斥着大量的文本、标识符和类别数据。NumPy 本身缺乏原生的变长 UTF-8 字符串类型,传统 pandas 只能退而求其次,将所有的字符串列标记为 object 类型。
在 object 类型下,pandas 内部存储的并不是紧凑的字符文本,而是一个指针数组。数组里的每个元素都是一个 8 字节的指针,分别指向 Python 堆中分散独立分配的 PyUnicodeObject(Python 原生字符串对象)。这种机制在处理大规模数据时暴露出极其昂贵的代价:
- 不可承受的内存开销:每个独立的 Python 字符串除了实际的文本字符外,还要携带垃圾回收、引用计数以及类型元数据等对象头信息(通常每个对象额外占据 48 至 80 字节)。处理一百万行短字符串,实际纯文本可能只有几兆字节,但在内存中往往会膨胀到数十甚至上百兆字节。
- CPU 缓存命中率极低(Cache Miss):指针指向离散分布在内存堆各处的 Python 对象。当对整列执行过滤、匹配或大小写转换时,CPU 无法进行线性预取,指针反引用(Pointer Indirection)引发了密集的硬件级缓存未命中。
- 无法向量化,受制于 Python GIL:传统
.str算子内部实际上只能通过 Python 解释器进行循环解包执行,无法使用现代 CPU 的 SIMD(单指令多数据流)指令集进行硬件级并行加速。
PyArrow 彻底改变了这一现状。它严格实现 Apache Arrow 的列式内存规范:变长字符串在内存中被规整组织为三个连续的内存缓冲区——有效性位图(Validity Bitmap)、偏移量数组(Offsets Buffer)和纯字节数据区(Data Buffer)。
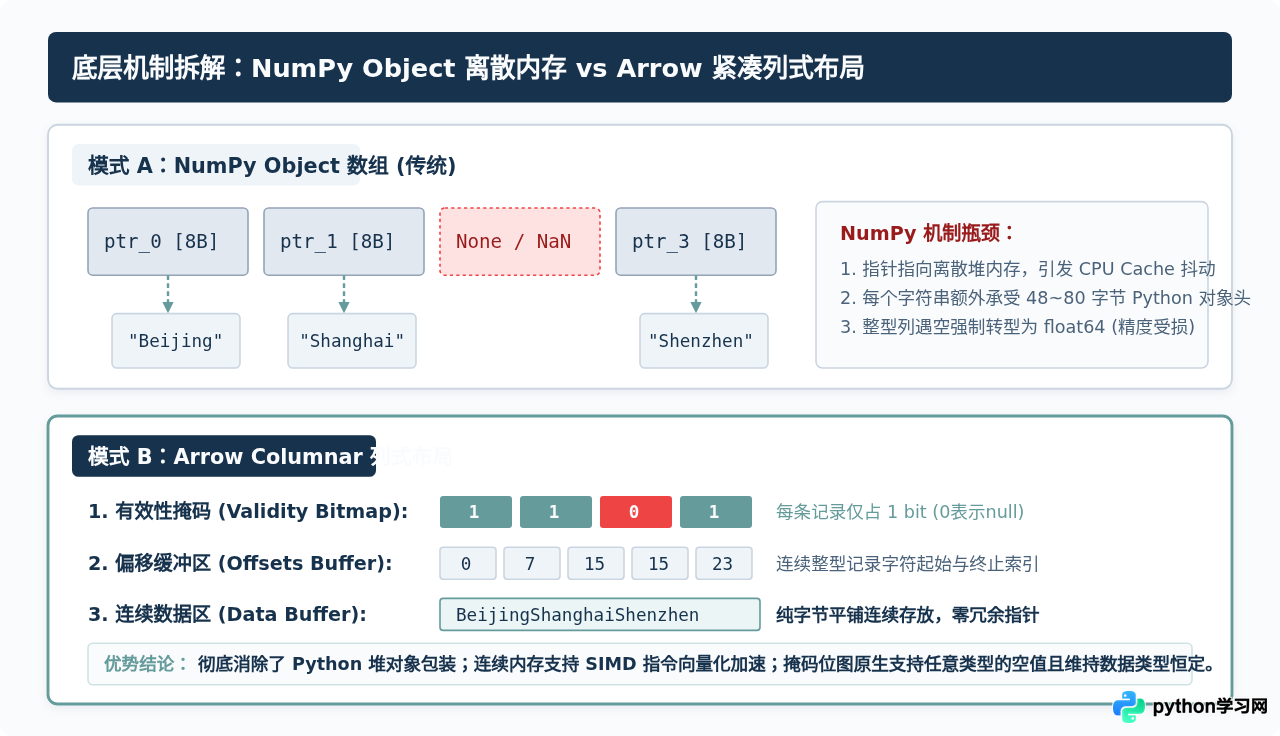
在 Arrow 模式下,整列的所有字符紧凑连续地平铺在 Data Buffer 中,中间没有任何 Python 对象包装。查找某一行只需通过 Offsets Buffer 对应的下标瞬间截取,内存利用率大幅提高,同时完全规避了 Python 对象头的浪费。
下面是一个具体的内存占用对比示例。创建一个包含 100 万行字符串的测试 Series:
import pandas as pd

# 准备 100 万条示例短文本
raw_data = ["category_alpha", "order_event_click", "region_east"] * 333333

# 1. 传统 NumPy object 存储方式
s_numpy = pd.Series(raw_data, dtype="object")
mem_numpy = s_numpy.memory_usage(deep=True) / (1024 * 1024)

# 2. PyArrow string 存储方式
s_arrow = pd.Series(raw_data, dtype="string[pyarrow]")
mem_arrow = s_arrow.memory_usage(deep=True) / (1024 * 1024)

# 示例运行结果:
# s_numpy 真实占用: ~76.2 MB
# s_arrow 真实占用: ~22.8 MB (内存立降约 70%)
二、原生缺失值支持:告别“整数遇空变浮点”的妥协
长久以来,许多初学 pandas 的开发者都会遇到一个经典困惑:为什么一列本来是整数(如用户 ID、订单数量),只要其中夹杂了一个空值(None 或 np.nan),整个列的 dtype 就会莫名其妙地变成 float64?
这是因为 NumPy 的连续数值结构中没有为整型定义“缺失”这个特殊标量,只能依赖 IEEE 754 浮点数规范中的 NaN(Not a Number)。而 NaN 在底层是一个浮点数,要把它放入整数列,NumPy 必须把整列所有数据强制类型转换(Upcasting)为浮点类型。这种妥协带来了两个显著缺陷:
- 破坏计算语义与精度:浮点数在表示超过 53 位的超大整数时会丢失末位精度,使得大整数 ID 匹配出现难以排查的隐蔽 Bug。
- 布尔类型退化:含有空值的布尔列无法使用
NaN,只能被迫退化为object类型,导致原本只占 1 字节的布尔列内存暴增数倍。
PyArrow 从数据结构的根本设计上终结了这个问题。在 Arrow 的体系中,任何数据类型都配备一个独立的 Validity Bitmap(有效性位图)。如果某一行数据有效,对应的位记为 1;如果为 null,对应的位记为 0。
因为判定缺失值的工作由独立的位图承担,底层的数值缓冲区根本不需要被强转类型。整型数据列包含空值时依然是原生的 int64[pyarrow],布尔列依然是纯粹的 boolean[pyarrow]。数据语义清晰一致,避免了在清洗数据时繁琐的类型重铸工作。
三、现代数据格式读取与零拷贝(Zero-Copy)生态互通
在大数据分析和现代数据仓库中,Parquet 和 Feather(Arrow IPC)已经成为主流的持久化列式文件格式。了解传统 pandas 与使用 PyArrow 后端在读取这些文件时的区别,能直接解释为什么 pandas 3.0 要大力拥抱 PyArrow。
在传统 NumPy 模式下,读取 Parquet 文件必须经过一段“昂贵的中间旅程”:
- 磁盘上的列式 Parquet 数据首先由底层的 C++ Arrow 库读取到临时内存中。
- 紧接着,pandas 需要将这些 Arrow 内存块一列一列地全量反序列化并拷贝为 NumPy 的
ndarray结构。 - 如果包含大量文本,还必须在 Python 虚拟机中为每一行实例化
str对象并构建指针数组。
这个二次转换过程不仅消耗巨量的 CPU 算力,还会导致内存占用瞬间达到峰值(原 Arrow 结构与新 NumPy 结构同时存在),极易在容器或小内存机器中触发内存溢出(OOM)。
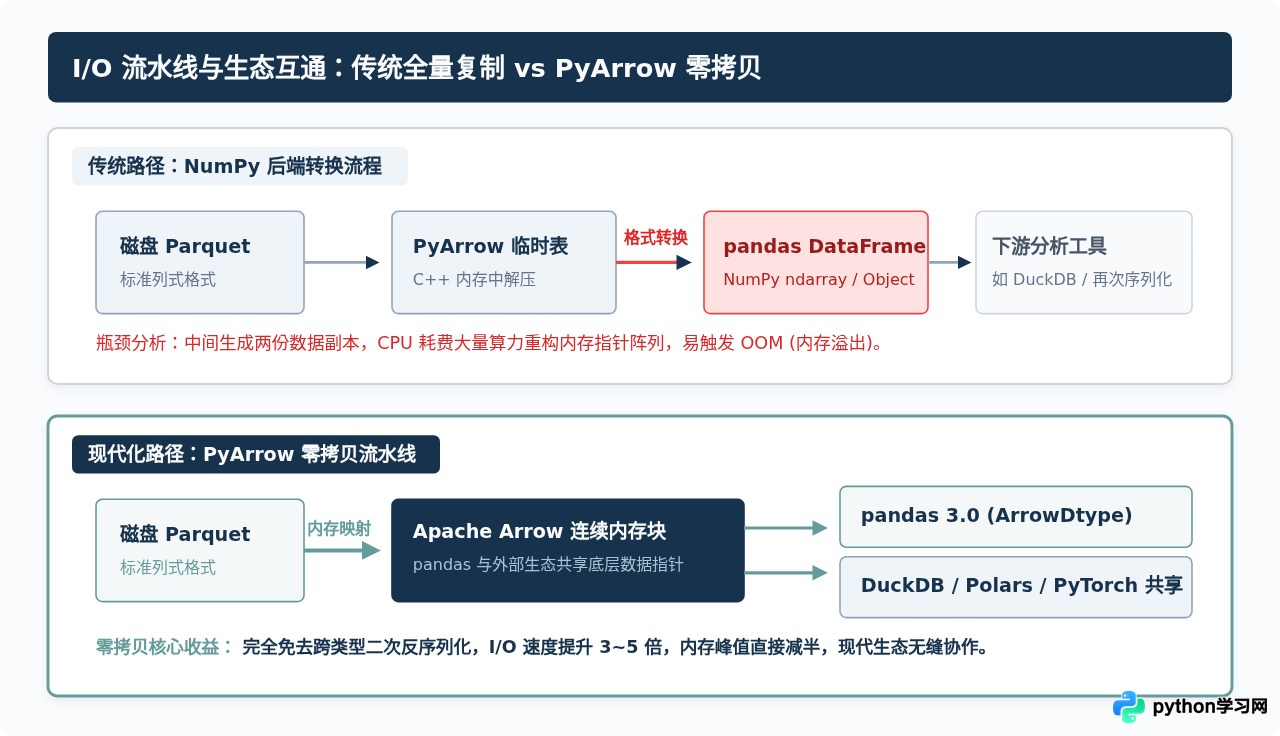
而在使用 PyArrow 后端时,pandas 3.0 的 DataFrame 直接基于 Arrow 内存结构封装。Parquet 文件被读取后,底层内存直接通过缓冲区指针共享给 pandas 使用,实现了真正的零拷贝(Zero-Copy)或近乎零代价的指针引用。
更为关键的是,这种基于标准 Arrow 协议的内存布局打通了现代 Python 数据生态。当你把 pandas 数据传递给 DuckDB、Polars、PyTorch 或分布式计算框架时,它们可以在统一的 Arrow 内存协议下直接读取同一个数据块,彻底省去了跨工具交互时无休止的序列化与反序列化损耗。
四、在日常开发中启用与配合 PyArrow 的操作指引
为了让现有的业务项目能够平滑享受到 PyArrow 带来的性能和内存红利,pandas 提供了循序渐进的启用途径。以下是四个标准的操作与验证步骤:
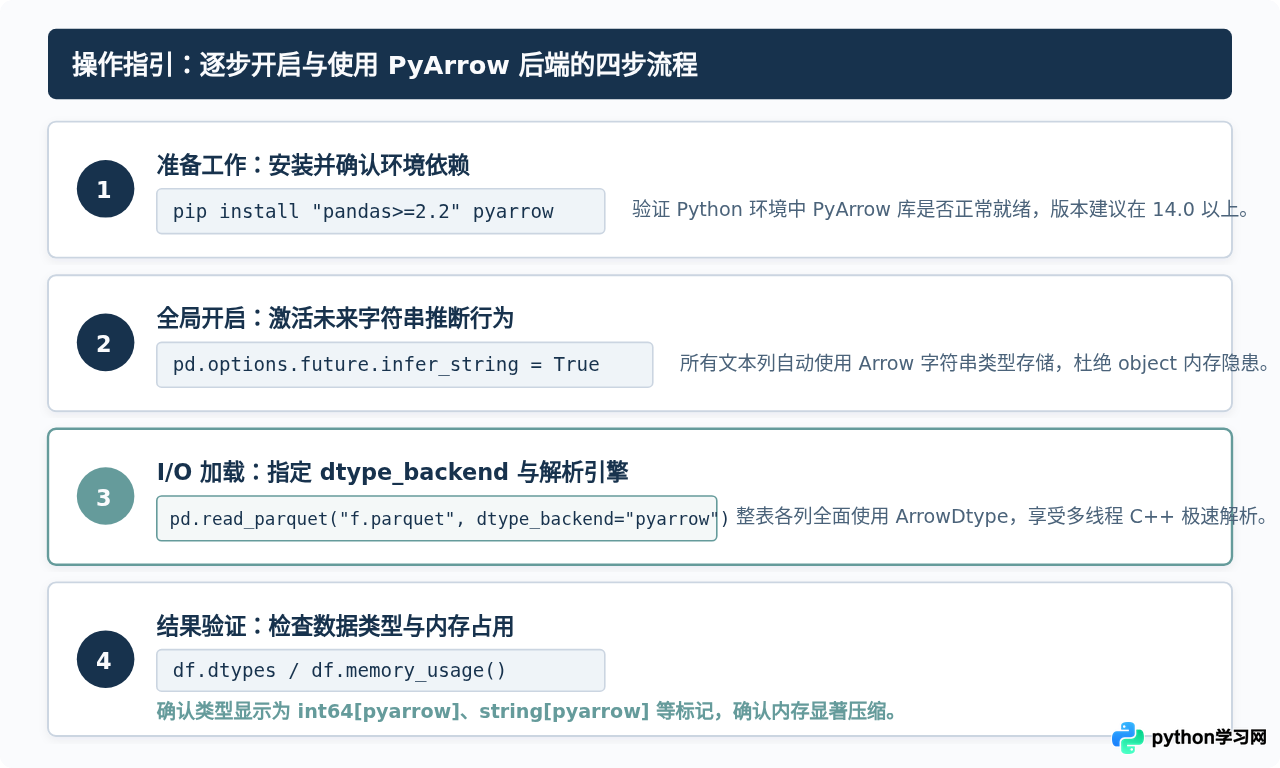
步骤 1:安装并确认 PyArrow 依赖
PyArrow 是 Apache Arrow 的官方 Python 绑定,作为可选但强力推荐的依赖库存在。首先确保已安装兼容的较新版本:
# 在终端中执行安装命令
pip install "pandas>=2.2" "pyarrow>=14.0"
步骤 2:全局开启 Arrow 字符串推断(最推荐的平滑实践)
如果你不想一次性重构整个项目的全部数值类型,但希望立刻解决占据内存大头的字符串 object 问题,可以在程序入口处开启全局选项。这个选项也是 pandas 迈向 3.0 的核心默认行为之一:
import pandas as pd

# 开启全局字符串自动使用 Arrow 存储
pd.options.future.infer_string = True

# 后续创建或读取的文本列,会自动变为 string[pyarrow_numpy] 或 string[pyarrow]
df = pd.DataFrame({"city": ["北京", "上海", "深圳"]})
print(df["city"].dtype)
# 输出示例: string[pyarrow]
步骤 3:在数据加载时显式指定 PyArrow 后端与解析引擎
在从 CSV、JSON 或 Parquet 文件读取大规模数据集时,通过传入 dtype_backend="pyarrow" 和 engine="pyarrow",让整张表直接以 Arrow 类型载入,充分发挥 C++ 多线程解析性能:
import pandas as pd

# 1. 高速读取 CSV 文件(启用多线程 C++ 解析器并使用 Arrow 类型)
df_csv = pd.read_csv(
    "large_dataset.csv",
    engine="pyarrow",
    dtype_backend="pyarrow"
)

# 2. 读取 Parquet 文件(零拷贝方式快速构建 ArrowDataFrame)
df_parquet = pd.read_parquet(
    "events.parquet",
    dtype_backend="pyarrow"
)
步骤 4:验证数据类型与内存收益
数据加载完成后,通过检查各列的 dtypes 和整体内存,确认 Arrow 后端已成功生效:
# 打印列类型信息
print(df_parquet.dtypes)
# 输出示例:
# user_id       int64[pyarrow]
# event_name    string[pyarrow]
# is_active     boolean[pyarrow]
# timestamp     timestamp[us][pyarrow]

# 评估深层内存消耗
print(df_parquet.memory_usage(deep=True).sum() / (1024 * 1024), "MB")
如果你手头已经有一个基于传统 NumPy 构建的 DataFrame,可以使用 df.convert_dtypes(dtype_backend="pyarrow") 方法。pandas 会自动扫描各列,并在保留数据内容的同时将其安全转换为对应的 ArrowDtype。
五、特性对比与技术选型决策
为了在实际工程中做出合理的架构选型,我们需要客观评估 NumPy 传统后端与 PyArrow 后端在具体指标上的对照表现:
| 对比维度 | 传统 NumPy 后端 | PyArrow 后端 (pandas 3.0 推荐) |
|---|---|---|
| 字符串存储模型 | Object 指针阵列 (高额内存开销) | Arrow 列式内存连续缓冲区 (节省 50%-70%) |
| 缺失值处理机制 | 依赖 float NaN (整数被迫转浮点) | 独立 Validity Bitmap (全类型无损支持 null) |
| Parquet / Feather I/O | 多次复制反序列化 (CPU 与内存双重峰值) | Zero-Copy 零拷贝直通 (加载提速 3-5 倍) |
| 复杂数据类型 | 仅能存为通用 object | 原生支持 List、Struct、Map、Decimal |
| 多线程与硬件加速 | 受 Python GIL 限制 (部分纯数值支持) | C++ 底层多线程并发与 SIMD 指令向量化 |
| 第三方机器学习库生态 | 历史原生兼容性极佳 | 老旧库需显式调用 .to_numpy() 转换 |
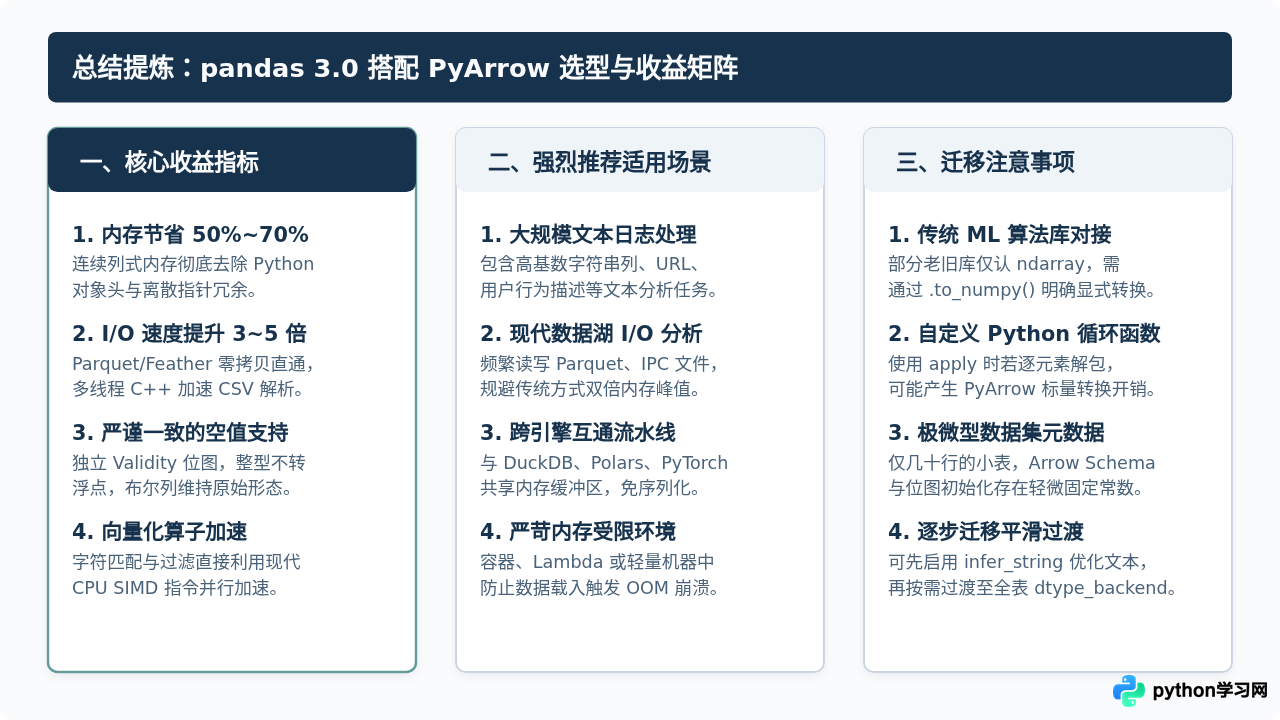
迁移过程中的注意事项与边界条件
虽然 PyArrow 带来了跨越式的性能飞跃,但在生产环境中进行系统升级时,仍需注意以下两个边界条件:
- 老旧算法库的兼容调用:部分历史悠久的第三方机器学习或数值计算工具可能只认
np.ndarray。在将数据送入这些特定函数之前,需通过df['col'].to_numpy()进行显式转换。 - 避免在纯 Python 循环中逐行拆箱:如果你的业务代码中大量使用了
for row in df.itertuples()或自定义的apply(lambda x: ...),逐元素从 Arrow 结构解包为 Python 标量会产生微量的类型包装开销。应当尽可能优先使用 pandas 内置的向量化方法或 PyArrow 提供的计算函数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















