


为什么Java通常比Python快?解析JIT编译、GIL锁与内存管理机制
深入解析为什么Java通常比Python运行更快。从JIT即时分层编译、CPython全局解释器锁(GIL)、对象内存布局与垃圾回收机制三大核心维度,系统拆解两者的底层性能根因与架构权衡。
核心结论速览:在数值计算与高吞吐后台服务中,纯 Java 实现的代码运行耗时往往只有 CPython 的 1/5 到 1/50。造成这种速度鸿沟的根本原因,不在于语法优雅与否,而在于底层三大体系架构的抉择:HotSpot 的分层 JIT 编译将热点字节码直接转化为高优化宿主机原生机器指令;操作系统 1:1 内核线程模型赋予了 Java 真正的多核多线程并发能力,摆脱了 CPython 全局解释器锁(GIL)的单核互斥瓶颈;以及紧凑连续的原始类型内存布局与现代化低延迟 GC,大幅削减了多级指针寻址导致的 CPU 缓存失效与对象分配损耗。
假设我们编写两个逻辑完全相同的程序,在单线程环境下分别循环执行一亿次简单的算术运算或斐波那契数列计算。在标准开发机上运行,Java 通常只需约 0.2 到 0.4 秒即可完成,而使用官方默认的 CPython 解释器运行 Python 脚本,耗时往往在 4 到 8 秒之间。这种十倍以上的性能差距,既非偶然,也非单纯的语法差异所致。要真正理解两者的性能分水岭,必须深入到程序执行流的底层生命周期中去考察。
一、执行引擎差异:JIT 分层即时编译 vs CPython 逐条解释循环
衡量一门语言运行快慢,首要考量的是其源代码最终如何交给 CPU 执行。CPU 只能执行对应架构的二进制机器指令,而高级语言代码转化为机器指令的方式决定了计算吞吐量的上限。
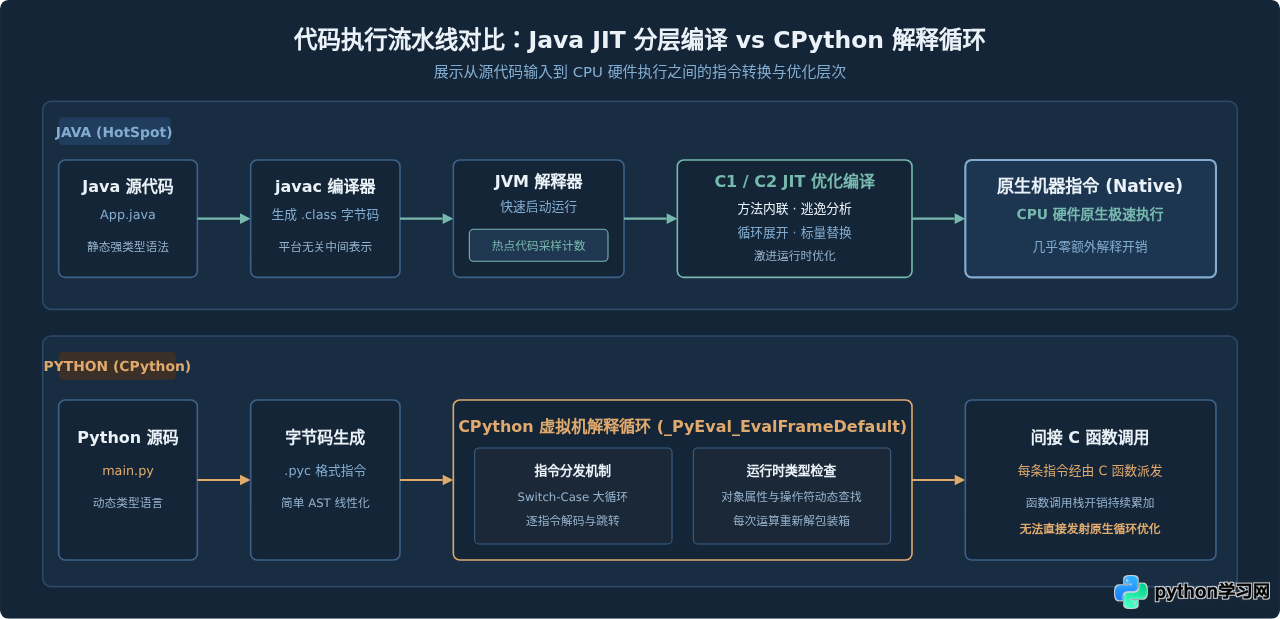
1. Java 的执行路径:静态编译、解释启动与 JIT 分层加速
Java 采用的是“先编译为平台无关字节码,再由虚拟机动态优化执行”的混合模型:
- 前端编译:开发者编写的
.java源码由javac静态编译器编译成规范的.class字节码。这一步只做语法检查和简单的语法糖展开,不直接生成机器指令。 - 解释执行起步:程序启动时,HotSpot JVM 通过模板解释器快速逐条执行字节码,保证程序无需长时间预编译就能秒级启动。
- 热点代码探测与分层 JIT:在执行过程中,JVM 内部维护方法调用计数器和循环回边计数器。当某段代码执行频率超过阈值(被判定为热点代码 Hot Spot),即时编译器(JIT, Just-In-Time Compiler)便会在后台线程被触发。HotSpot 采用 C1(客户端编译器) 进行快速编译和基础优化,随着代码进一步变热,C2(服务端编译器) 会介入执行深度的全局优化,包括方法内联(Method Inlining)、逃逸分析(Escape Analysis)、标量替换(Scalar Replacement)、死代码消除以及循环展开(Loop Unrolling)。
- 原生机器指令执行:被 C2 优化后的代码直接替换解释执行栈帧(OSR, On-Stack Replacement),CPU 能够以全速直接执行宿主机汇编指令,效率与 C/C++ 优化后的二进制程序极为接近。
2. CPython 的执行路径:动态类型评估与巨型解释循环
作为 Python 的官方主流实现,CPython 同样会先把 .py 源码编译为 .pyc 字节码,但其后续的执行方式与 Java 截然不同:
- 解释器核心循环:CPython 依靠一个巨大的 C 语言
for/switch状态机(在 CPython 源码中对应ceval.c中的_PyEval_EvalFrameDefault函数)逐条读取字节码指令并分发执行。 - 动态类型的持续开销:在 Python 中,变量只是对象的引用,并不具备固定类型。执行一次看似简单的
c = a + b,CPython 无法直接发射一条 CPU 级别的ADD指令,而是必须在运行时经历:检查a和b的对象类型、查找类型的__add__槽函数、分配新的对象保存结果、更新引用计数等漫长流程。 - 缺乏默认 JIT(Python 3.12 之前):传统的 CPython 并没有常驻的高性能机器码 JIT 编译器,这意味着即使某段循环被执行了一亿次,CPython 依然需要老老实实地走上一亿次解释器分发与动态类型派发流程。
二、并发模型与多核利用:内核级 1:1 线程 vs CPython GIL 互斥
现代服务器普遍具备数十甚至上百个物理 CPU 核心。单核算力增长放缓的背景下,能否把计算负载均匀摊平到所有 CPU 核心上,直接决定了系统的吞吐峰值。
1. Java 的并发架构:原生 1:1 映射与多核真并行
自 JDK 1.2 废弃早期的绿色线程(Green Threads)以来,Java 的 java.lang.Thread 在绝大多数主流操作系统(Linux、Windows、macOS)上均采用 1:1 内核级线程模型。一个 Java 线程直接对应一个操作系统原生的轻量级进程(LWP)。
操作系统的任务调度器(如 Linux CFS 调度器)能够感知到每个 Java 线程的存在,并将其直接调度分发到不同的物理 CPU 核心上同时运行。当我们在 16 核服务器上启动 16 个计算密集型 Java 线程时,系统监控工具(如 htop)会显示 CPU 利用率能够稳定达到 1600%,各核心算力得以完全释放。
2. CPython 的并发困境:全局解释器锁(GIL)
Python 语言本身支持通过 threading 模块创建多线程,这些线程在操作系统层面也是真实的内核线程。然而,CPython 解释器的内部实现引入了一把臭名昭著的互斥锁——全局解释器锁(Global Interpreter Lock, GIL)。
- 为什么存在 GIL? CPython 内部大量使用引用计数来管理对象内存(每个对象都有一个
ob_refcnt计数器)。为了防止多个线程在并发修改引用计数或 C 扩展全局变量时引发数据竞争导致内存泄漏或崩溃,CPython 选择在解释器级别加上一把大粗粒度锁。 - 锁对计算密集型任务的影响:在任何给定的时刻,只能有一个线程持有 GIL 并执行 Python 字节码。即使物理主机拥有 64 个 CPU 核心,启动 64 个处理数值计算的 Python 线程,它们也必须在操作系统层面不断进行“请求 GIL -> 抢占锁 -> 执行少量字节码 -> 释放 GIL -> 挂起等待”的恶性循环。
- 性能反向衰减:由于频繁的线程上下文切换、唤醒抖动与互斥锁竞争开销,多线程执行纯 Python 计算任务时,总运行耗时甚至常常比单线程运行还要慢上 30% 到 50%。
# 单线程执行两段一亿次累加
def count():
    n = 100000000
    while n > 0:
        n -= 1

# 单线程顺序执行耗时约: 7.2 秒
count()
count()

# 开启两个线程同时执行计算密集任务
import threading
t1 = threading.Thread(target=count)
t2 = threading.Thread(target=count)
t1.start(); t2.start()
t1.join(); t2.join()
# 实际执行耗时约: 9.8 秒(不仅没有减半,反而因为 GIL 竞争与上下文切换增加了 36% 耗时!)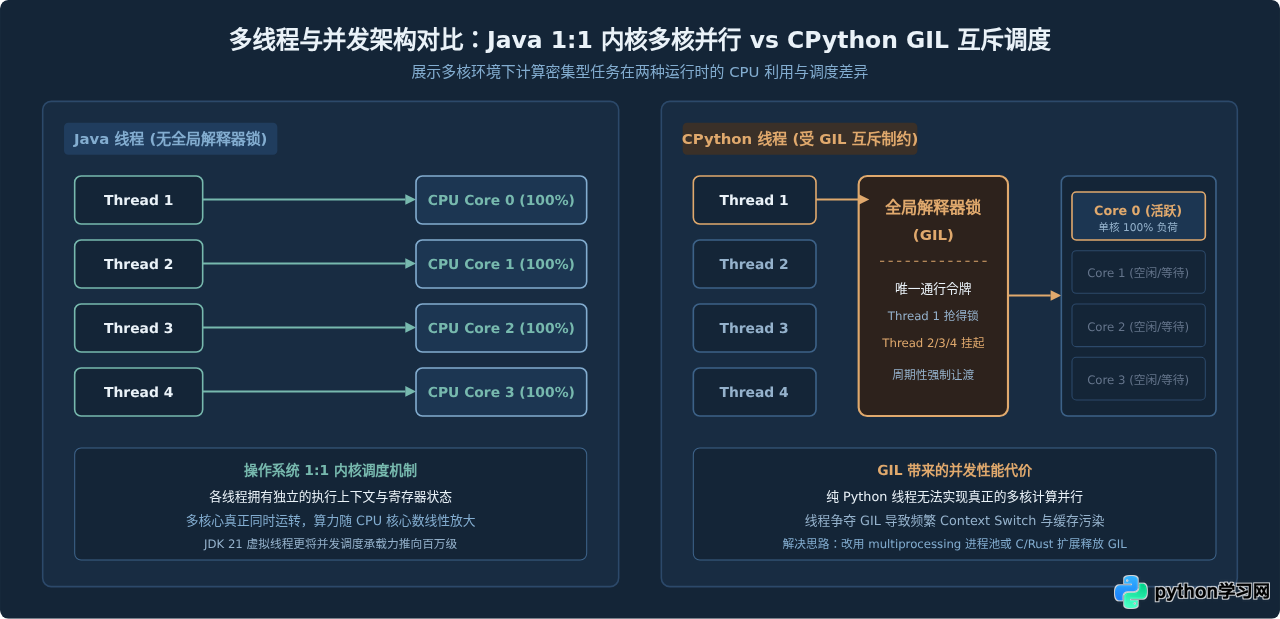
三、内存管理与对象开销:紧凑数据结构 vs 万物皆 PyObject 封装
CPU 的运算频率高达数 GHz,但主内存(DRAM)的访问延迟相对而言极其漫长。现代处理器的实际性能很大程度上取决于 CPU L1/L2/L3 高速缓存的命中率。在内存布局与回收机制的设计上,Java 与 Python 选择了截然相反的哲学。
1. 内存排布与缓存局部性(Cache Locality)
在 Java 中,数据类型被严格划分为基本数据类型(Primitive Types)和引用类型(Reference Types):
- 一个
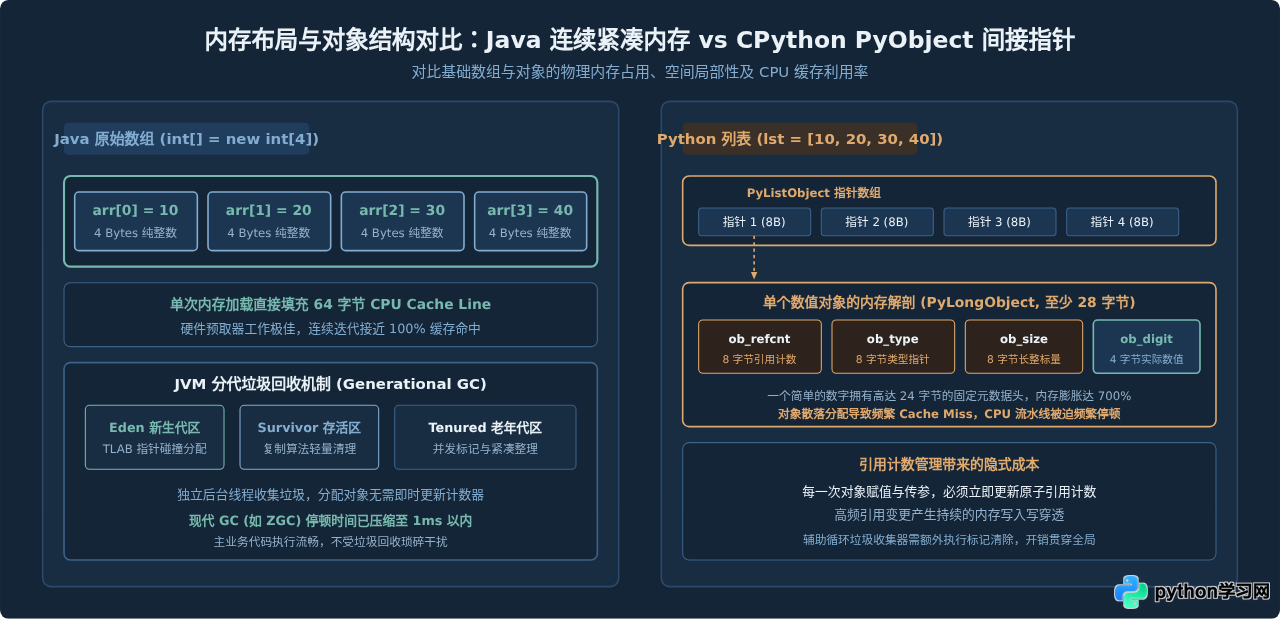
int变量在内存中精确占用 4 个字节,long和double占用 8 个字节。 - 定义一个包含 1000 个整数的 Java 数组
int[] arr = new int[1000];,JVM 会在内存堆中分配一段完全连续的 4000 字节内存空间。CPU 在访问arr[0]时,硬件预取单元(Hardware Prefetcher)会自动将紧随其后的数十个连续整数顺带预载进 L1/L2 缓存行(Cache Line,通常为 64 字节)。这使得连续迭代几乎能做到 100% 缓存命中,计算指令流水线完全无需停顿等待内存返回。
反观 Python,“一切皆对象”是其核心设计理念,但这在计算密集型场景下带来了巨大的内存膨胀与缓存失效开销:
- 在 64 位 CPython 中,哪怕只是一个数字
1,也不是纯粹的 4 字节整数,而是一个完整的PyLongObject结构体。它必须包含:8 字节引用计数(ob_refcnt)、8 字节类型对象指针(ob_type)、8 字节数值大小(ob_size)以及实际数值数组(ob_digit)。一个简单的整数实际占用至少 28 个字节! - 定义一个 Python 列表
lst = [10, 20, 30, 40],系统分配的并不是连续的数字内存,而是一个存放指针的列表对象。列表中存储的是 4 个指针,分别指向散落在堆内存不同位置的 4 个独立PyObject。 - 当程序遍历这个列表时,每一次获取元素都会经历至少一次间接指针跳转。这种在内存中“跳跃式”的寻址行为直接破坏了 CPU 空间局部性,导致高频的 Cache Miss(缓存未命中),CPU 绝大部分时间不得不处于等待内存数据到达的空转状态。
2. 垃圾回收机制与分配开销
两者在内存回收的成本摊销上也存在本质差别:
- Java 现代化分代 GC:HotSpot 采用基于代际假说(Generational Hypothesis)的垃圾收集器(如 G1、ZGC、Parallel GC)。新对象在年轻代的 Eden 区通过“指针碰撞”(Bump-the-pointer)与线程本地分配缓冲区(TLAB)分配,其分配开销只需轻量递增指针,成本与 C 语言栈分配相差无几。回收过程由独立的后台 GC 线程执行,在 ZGC 中,即使堆内存高达数百 GB,垃圾回收引起的停顿时间(STW)也能压制在 1 毫秒以内。
- Python 引用计数与循环垃圾检测:CPython 的主要回收手段是直接引用计数。每一次变量赋值、函数传参、列表追加或离开作用域,都会立即伴随着对
ob_refcnt的增加或减少操作。这些细碎的内存写操作始终穿插在主逻辑之中,无法被硬件批量化。为了处理对象间循环引用问题,Python 还需要定期挂起并运行辅助的分代循环垃圾收集器。
四、全景维度横向对比:Java 与 Python 的架构性能矩阵
为了帮助开发者更直观地把握两门语言的底层差异,我们将两者的关键指标归纳对比如下:
| 技术维度 | Java (HotSpot JVM) | Python (CPython) | 对性能的决定性影响 |
|---|---|---|---|
| 编译与执行阶段 | 静态编译为字节码 + JIT 运行时直接生成原生机器码 | 编译为字节码 + C 解释循环逐条解码分发 | JIT 支持方法内联与激进优化,机器码执行效率比解释分发高 10~50 倍。 |
| 类型系统 | 静态强类型(编译期即确定所有变量类型与方法偏移量) | 动态类型(运行时每次运算均需动态检查与派发) | Java 避免了运行时的属性字典查找与虚表动态解析损耗。 |
| 多线程并发能力 | 1:1 内核线程映射,支持多核心真正的并行计算 | 受 GIL 锁全局互斥制约,同一时刻单核运行 | 在多核服务器上,计算密集型 Java 任务可近乎线性加速,Python 出现负优化。 |
| 内存数据布局 | 支持原生紧凑基本数据类型(如 int 仅 4 字节连续存储) | 万物皆对象,简单整数亦需 28 字节封装头 | Java 具备极高的 CPU 空间局部性与缓存命中率,Python 指针跳转导致频繁 Cache Miss。 |
| 垃圾回收机制 | 成熟的分代 GC(G1/ZGC),独立后台线程低延迟收集 | 即时引用计数为主 + 分代标记清除为辅 | Java 对象通过 TLAB 指针碰撞极速分配,Python 频繁修改引用计数带来持续写开销。 |
五、实战视角:Python 何时能追平甚至反超 Java?
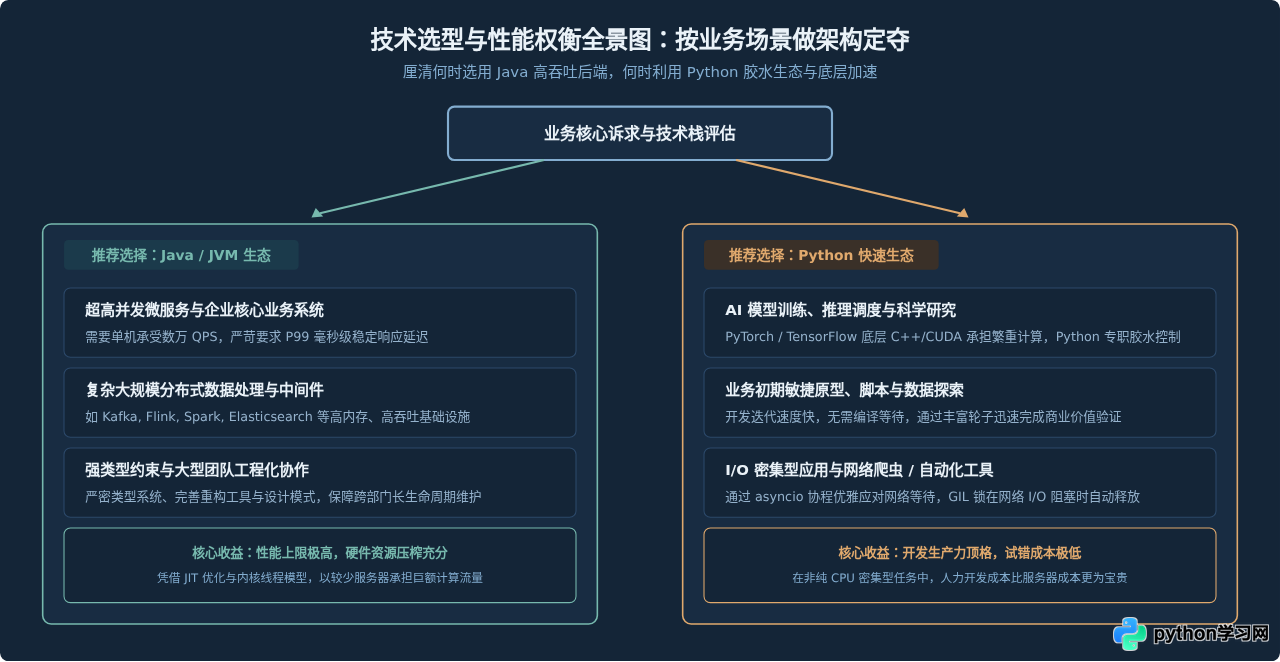
既然 Java 在架构层面上拥有如此压倒性的底层性能优势,为什么今天以算力消耗著称的人工智能(AI)、机器学习与科学计算领域,却几乎被 Python 全面垄断?
关键认知:“Python 的速度”需要严格区分为“纯 Python 解释器执行速度”与“以 Python 为控制胶水调用底层的系统性能”。当 Python 用作外部强力引擎的编排界面时,其劣势被降至最低,而开发灵活性达到了顶峰。
Python 在特定场景下能够实现极高执行效率的核心路径包括:
- C/C++ 底层向量化加速(如 NumPy):NumPy 的底层数组(
ndarray)并非 Python 原生列表,而是一段连续的 C 语言原生内存缓冲区。在进行矩阵运算时,NumPy 直接调用经底层高度优化的 BLAS/LAPACK、Intel MKL 库,甚至利用 AVX-512 SIMD 硬件指令集进行单指令多数据运算,其性能等同于纯 C,甚至超越未做 SIMD 优化的普通 Java 循环。 - 释放 GIL 的密集计算扩展:成熟的科学计算库(如 PyTorch、TensorFlow、OpenCV)在进入耗时计算时,会在 C/C++ 层面显式调用宏
Py_BEGIN_ALLOW_THREADS释放 GIL,使多个底层工作线程能够不受拘束地在所有 CPU 或 GPU 硬件加速单元上完全并行。 - 开发效率与计算瓶颈的权衡:在深度学习训练中,99% 的计算耗时都发生在 GPU 或 TPU 的张量计算内核中,Python 仅负责组织计算图、读取配置和打印日志。在此场景下,即使 Python 慢 10 倍,其对整体训练耗时的影响也微乎其微,而其灵活的动态语法为算法探索节省了大量开发周期。
六、总结与技术展望
回顾“为什么 Java 通常比 Python 快”这一问题,其本质是工程世界中“运行性能优先”与“开发效率优先”两种设计哲学的具象体现:
- JIT 编译器 vs 解释循环:Java 愿意付出 JVM 内存预留与启动预热的代价,换取热点代码全速运行在裸机汇编级别的极致性能;而 CPython 坚持轻量易启动的解释大循环,牺牲了计算执行上限。
- 内核级并发 vs 全局解释器锁:Java 实现了多核 CPU 的全速多线程并发;CPython 为了保护内部引用计数的简单性保留了 GIL,限制了纯 Python 逻辑利用多核的能力。
- 紧凑连续内存 vs 动态对象装箱:Java 保留了基本数据类型与紧凑数组排布,极好迎合了现代 CPU 的高速缓存预取机制;Python “万物皆对象”的抽象虽然带来了高度的灵活性,却付出了内存膨胀与频繁 Cache Miss 的代价。
值得注意的是,编程语言的发展从未停滞。Python 官方自 3.12 起逐步实验性引入专项 JIT 编译器,并在 3.13 版本中正式推出了自由线程(Free-threaded, No-GIL)构建选项,致力于从根本上移走 GIL 这座大山;而 Java 也在通过 Project Valhalla 推进内联值类型(Value Objects)、通过 GraalVM 提供原生静态镜像(AOT),不断向着更低内存占用与更快启动时间迈进。理解两者的底层底层机制,有助于我们在实际架构设计中不盲从、不迷信,根据业务真实瓶颈作出最理性的技术选型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















