


python必背源代码定时任务schedule代码
针对Python初学者与自动化开发者必背的schedule定时任务源代码解析,涵盖每秒、每分、每日定点执行、参数传递、多线程防阻塞及取消任务等核心代码模式与落地规范。
在 Python 脚本开发中,如果需要实现一个“每隔10秒抓取一次数据”或“每天早上9点生成日报”的定时任务,最轻量、直观且无需搭建独立调度服务的解决方案就是第三方库 schedule。通过类似英语自然语言的链式调用,初学者只需牢记一套标准循环模板,就能在几分钟内写出稳定运行的自动化定时任务。
一、schedule 核心安装与必背最简代码骨架
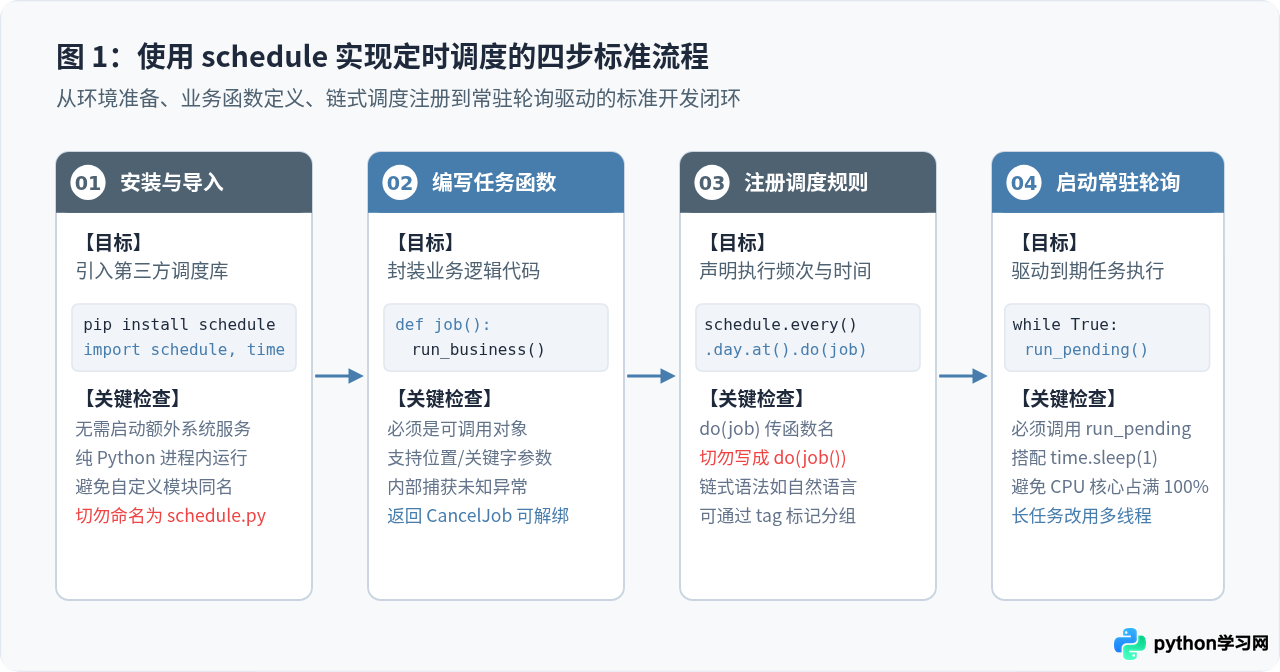
在使用 schedule 之前,需要先通过 pip 工具完成依赖安装。由于 schedule 是一个纯 Python 编写的轻量库,它不依赖系统的 Crontab 守护进程,也不依赖 Redis 或数据库,所有任务配置均存放在当前 Python 进程的内存队列中。
schedule.py。如果文件名与库名重名,Python 会优先导入当前脚本自身,导致报出 AttributeError: module 'schedule' has no attribute 'every' 的循环导入错误。建议保存为 task_runner.py 或 my_schedule.py。
下面是每一个开发者都必须牢记在心的最简定时任务代码骨架。无论后续编写多复杂的业务调度,整体骨架都由“定义任务、注册规则、心跳循环”三部分组成:
import schedule
import time

# 1. 定义具体要执行的任务函数
def heartbeat_job():
    print(f"[{time.strftime('%Y-%m-%d %H:%M:%S')}] 心跳检测正常,服务运行中...")

# 2. 声明定时调度规则(链式调用)
schedule.every(5).seconds.do(heartbeat_job)

# 3. 必须通过常驻死循环驱动到期任务
while True:
    schedule.run_pending()  # 核心:检查所有任务,执行已到期的任务
    time.sleep(1)           # 核心:防止空循环耗尽单核 CPU 算力
上述代码的执行结果示例如下:
[2026-11-19 09:00:10] 心跳检测正常,服务运行中...
[2026-11-19 09:00:15] 心跳检测正常,服务运行中...
二、高频必背场景代码:固定间隔与定点时间
schedule 最核心的优势在于其直观的链式语法(Method Chaining)。日常工作中最常用的五种调度场景涵盖了秒、分、小时、每日定点以及按星期循环:
import schedule
import time

def task_report():
    print("执行日报统计任务")

def task_backup():
    print("执行数据库备份任务")

# 模式 1:固定秒级/分钟级间隔
schedule.every(10).seconds.do(task_report)        # 每 10 秒
schedule.every(30).minutes.do(task_report)        # 每 30 分钟

# 模式 2:随机区间间隔(特别适用于爬虫防风控)
schedule.every(5).to(10).seconds.do(task_report)  # 每次随机隔 5 到 10 秒

# 模式 3:每日固定时间点(注意时间字符串必须补零对齐)
schedule.every().day.at("09:30").do(task_report)  # 每天早上 09:30
schedule.every().day.at("23:59:50").do(task_backup) # 每天 23:59:50(支持精确到秒)

# 模式 4:每小时的固定第几分钟
schedule.every().hour.at(":15").do(task_report)   # 每个小时的第 15 分钟触发

# 模式 5:每周固定星期与时间点
schedule.every().monday.at("10:00").do(task_report)   # 每周一上午 10:00
schedule.every().friday.at("18:00").do(task_backup)   # 每周五下午 18:00

while True:
    schedule.run_pending()
    time.sleep(1)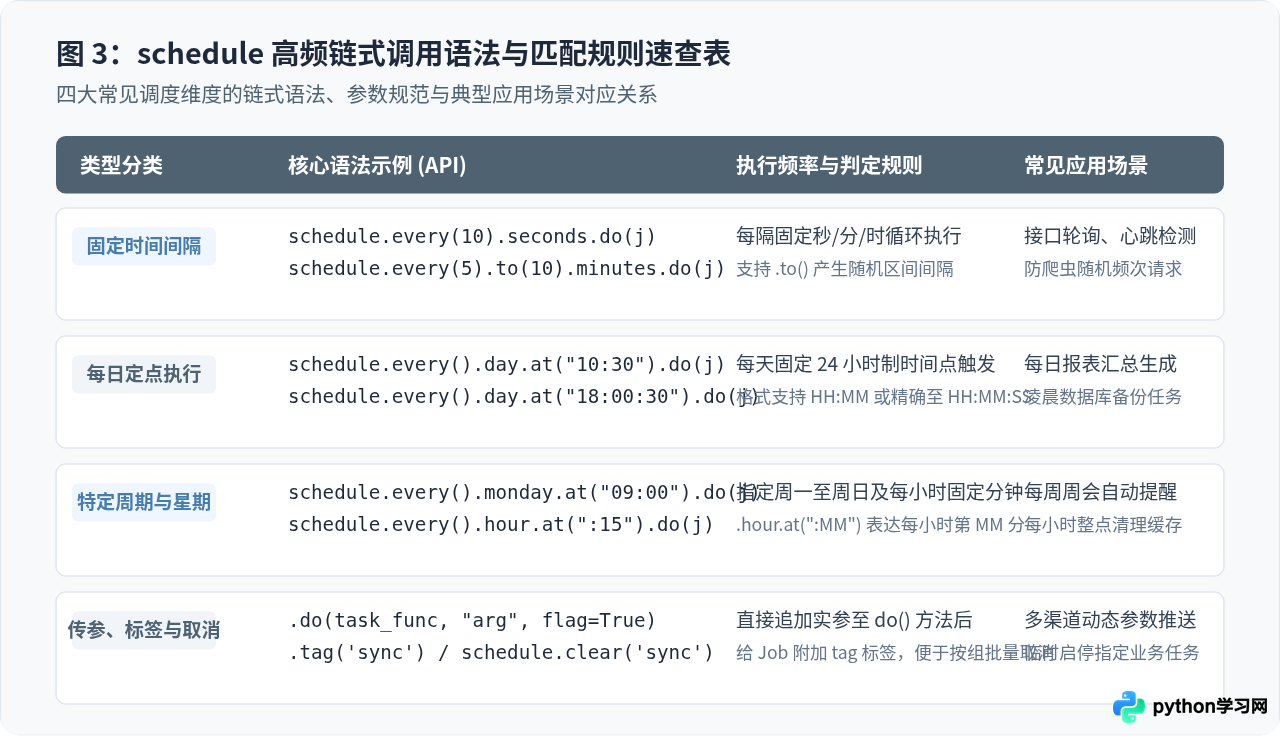
三、进阶必背技巧:参数传递、单次执行与标签管理
实际开发中,我们很少执行完全无状态、无参数的空函数。很多时候需要将用户 ID、文件路径或数据库连接传递给定时函数,或者在某些条件满足时动态取消特定任务。
1. 向任务函数传递位置参数与关键字参数
在 schedule 中传参非常直接:只需将实参直接放在 .do() 方法的函数名之后即可,千万不要给任务函数加上括号:
import schedule
import time

def send_email(recipient, subject, is_urgent=False):
    flag = "【加急】" if is_urgent else ""
    print(f"向 {recipient} 发送邮件{flag}:{subject}")

# 传参写法:do(函数名, 位置参数1, 位置参数2, 关键字参数=值)
schedule.every(10).minutes.do(
    send_email,
    "admin@company.com",
    "系统状态通报",
    is_urgent=True
)
2. 仅执行一次后自动注销(CancelJob)
如果希望某个任务只在特定时间运行一次便自动销毁,不需要一直驻留内存,只要在函数内部返回 schedule.CancelJob 即可:
def one_time_migration():
    print("执行单次历史数据清洗...")
    # 业务完成后返回取消标识
    return schedule.CancelJob

# 每天执行一次,但第一次执行完毕后便会自动从任务列表中剔除
schedule.every().day.at("02:00").do(one_time_migration)
3. 使用标签(Tag)批量管理和取消任务
当项目包含数十个任务时,可以通过 .tag() 给任务分类打标,例如区分 data_sync 和 mail_push,后续可按组单批清理:
# 给任务打上标签
schedule.every().hour.do(task_report).tag('hourly-group', 'monitoring')
schedule.every().day.do(task_backup).tag('daily-group', 'monitoring')

# 1. 批量取消所有带有 'hourly-group' 标签的任务
schedule.clear('hourly-group')

# 2. 清空全部注册的所有定时任务
schedule.clear()
四、生产级关键防踩坑:多线程防阻塞与异常兜底
很多初学者在使用 schedule 时会遇到一个典型问题:“明明设置了每10秒执行一次任务A,每10秒执行一次任务B,为什么任务B总是延后几十秒才执行?”
其根本原因在于:schedule 本身是单线程串行执行的。如果任务A内部包含了网络请求、长时间计算或 time.sleep(15),它就会直接霸占 Python 解释器的主线程,导致后续的 schedule.run_pending() 无法按时调用,从而引发任务排队与时间漂移。
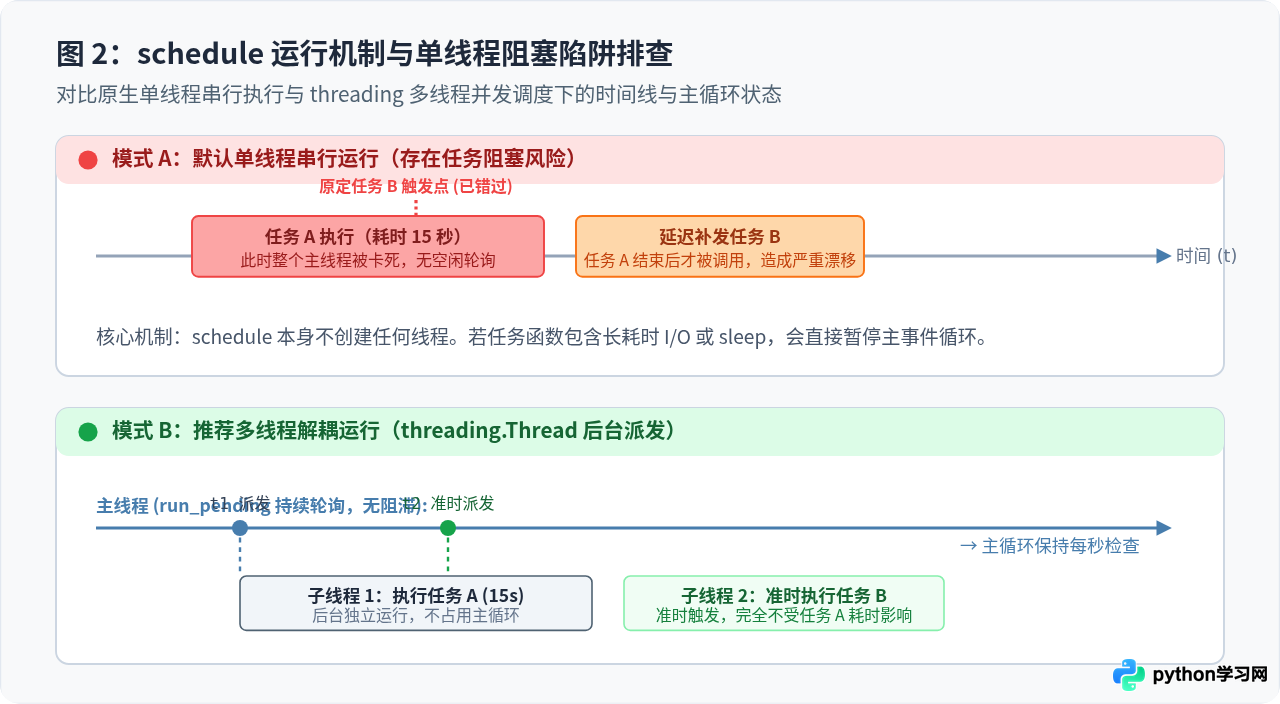
解决这个问题的标准生产方案是:将每个到期任务放入独立的后台子线程(或线程池)中异步执行,主循环只负责每秒轻量轮询与分发任务,不参与任何耗时业务逻辑:
import schedule
import time
import threading

# 装饰器或包装函数:把普通阻塞任务转换为后台多线程执行
def run_threaded(job_func, *args, **kwargs):
    def wrapper():
        try:
            job_func(*args, **kwargs)
        except Exception as e:
            print(f"[异常捕获] 任务执行失败: {e}")

    job_thread = threading.Thread(target=wrapper, daemon=True)
    job_thread.start()

# 模拟一个耗时 8 秒的长任务
def slow_crawler():
    print("【开始】爬虫任务正在下载大文件...")
    time.sleep(8)
    print("【完成】爬虫任务文件保存完毕")

# 模拟一个每 2 秒就要执行一次的高频心跳任务
def fast_ping():
    print(">>> 高频心跳正常")

# 注册时通过 run_threaded 派发,长任务不会再卡死高频心跳
schedule.every(10).seconds.do(run_threaded, slow_crawler)
schedule.every(2).seconds.do(run_threaded, fast_ping)

while True:
    schedule.run_pending()
time.sleep(1)try...except 异常捕获块。如果在单线程模式下任务抛出未捕获的严重异常,整个 while True 循环会直接中断退出,导致所有的后续定时任务彻底瘫痪。
五、适用边界与技术选型建议
尽管 schedule 库极其简单实用,但每一种工具都有明确的适用边界。在确定技术栈之前,可以参考以下选型对比:
| 对比维度 | schedule (本文方案) | APScheduler | Celery Beat | Linux Crontab |
|---|---|---|---|---|
| 部署依赖 | 零额外依赖(纯 Python 内存) | 轻量,可外接数据库 | 重度(需 Redis / RabbitMQ) | 操作系统自带 |
| 学习成本 | 极低(10分钟掌握链式语法) | 中等(需理解 JobStore 与触发器) | 较高(需配置 Broker 与 Worker) | 中等(需掌握 Cron 表达式) |
| 持久化支持 | 不支持(进程重启即重置) | 支持(可存入 SQLite/MySQL) | 完全支持分布式持久化 | 操作系统文件持久化 |
| 并发与分布式 | 单机进程(需手动套用多线程) | 单机自带线程池/进程池 | 天生支持多节点分布式集群 | 单机操作系统级多进程 |
| 最佳应用场景 | 个人小工具、单机爬虫、微信机器人 | 企业后台管理系统内嵌定时服务 | 大型高并发互联网服务异步队列 | 服务器系统运维、日志轮转与备份 |
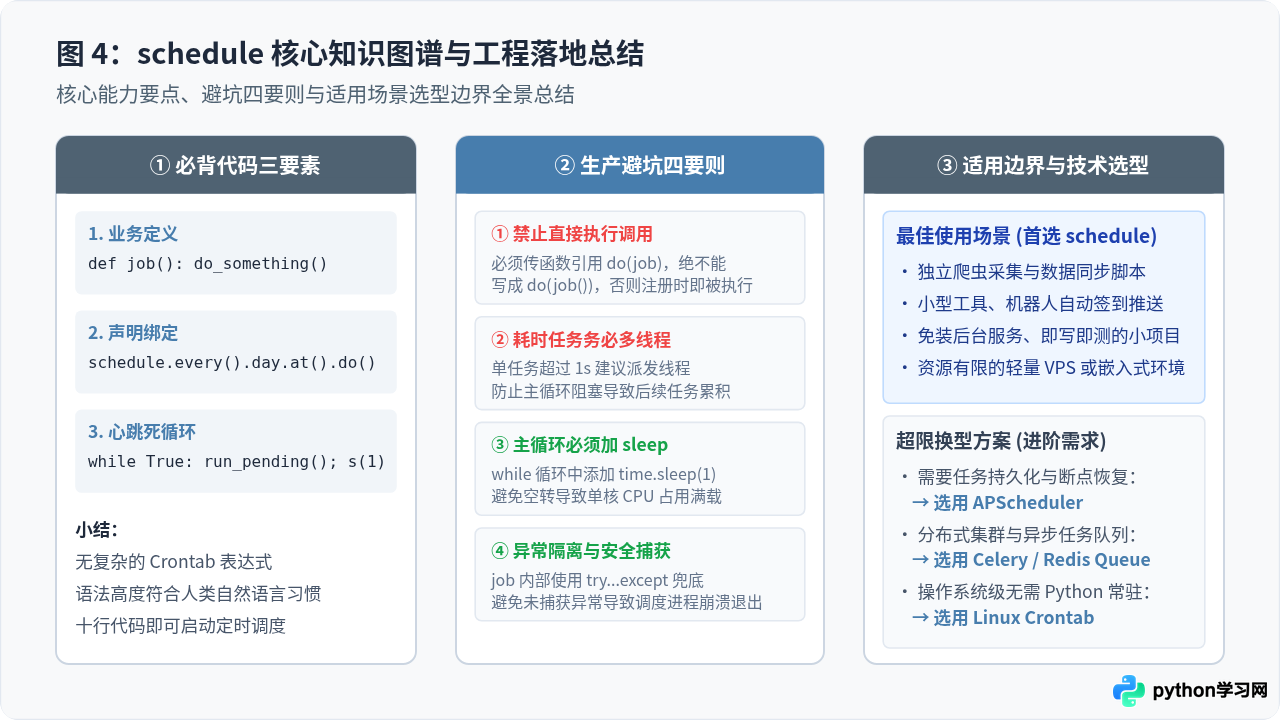
六、总结速记清单
掌握 schedule 库,核心在于记住以下三点:
- 一套骨架:
import schedule, time→schedule.every()....do(func)→while True: schedule.run_pending(); time.sleep(1)。 - 一个规范:
.do(func)传递的是函数名,而非函数调用func();传递参数时直接顺延写在do(func, arg1, kw=1)之中。 - 一条红线:若有耗时超过 1 秒的任务,务必借助
threading.Thread异步执行,并配合try...except做好异常捕获,确保调度主循环永远健康运转。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















