


Python列表与字典有什么区别?数据结构入门解析
深入解析Python列表与字典的核心区别,涵盖语法定义、内存模型、访问机制、操作复杂度及选型场景,帮助初学者建立扎实的数据结构认知。
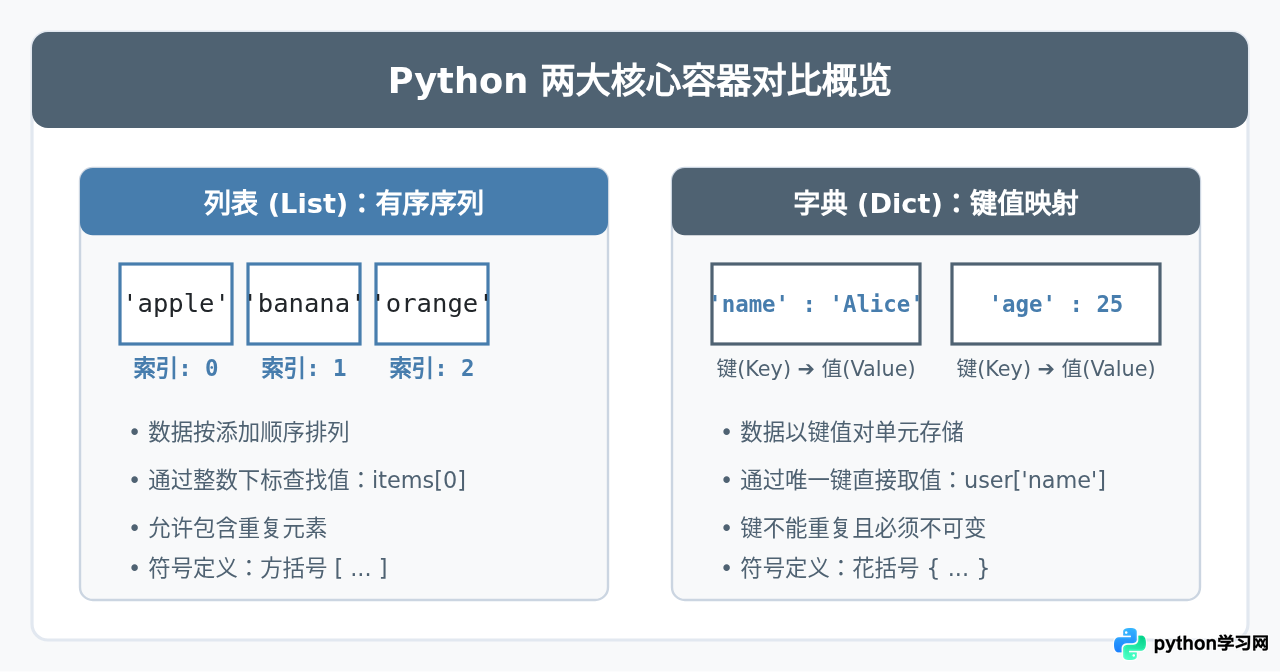
list)与字典(dict)是两种核心内置容器,它们最根本的区别在于数据组织形式与检索机制:列表是以连续位置为基础的有序序列,通过从 0 开始的整数索引读取;字典则是以键值映射(Key-Value)为基础的数据结构,通过唯一不可变的键直接定位对应的值。需要保持固定顺序或按位置读取数据时使用列表,需要通过名称、标识符建立明确属性对应时使用字典。
一、定义方式与基本形态的区别
在编写 Python 代码时,最直观的差异体现在定义符号和数据形式上:
- 列表(List):使用方括号
[]定义,元素之间用英文逗号隔开。列表中的每个元素只代表单独的数据项,元素在列表中的物理与逻辑位置固定。 - 字典(Dictionary):使用花括号
{}定义,存储的是成对出现的“键值对”(Key-Value),键与值之间用冒号:连接,每组键值对之间用英文逗号分隔。
# 示例:列表的声明与基本索引
scores = [92, 85, 98, 77]
print(scores[0])   # 输出:92(获取第 1 个元素)
print(scores[2])   # 输出:98(获取第 3 个元素)

# 示例:字典的声明与基于键的访问
student_scores = {
    "Alice": 92,
    "Bob": 85,
    "Charlie": 98,
    "David": 77
}
print(student_scores["Alice"])    # 输出:92(通过名字查找成绩)
print(student_scores["Charlie"])  # 输出:98
从上面的代码可以看出,列表通过整型数字下标(0, 1, 2...)来表达“排在第几个”,而字典通过具有业务含义的字符串键来表达“属于哪一项”。
二、底层结构与查找原理深度对比
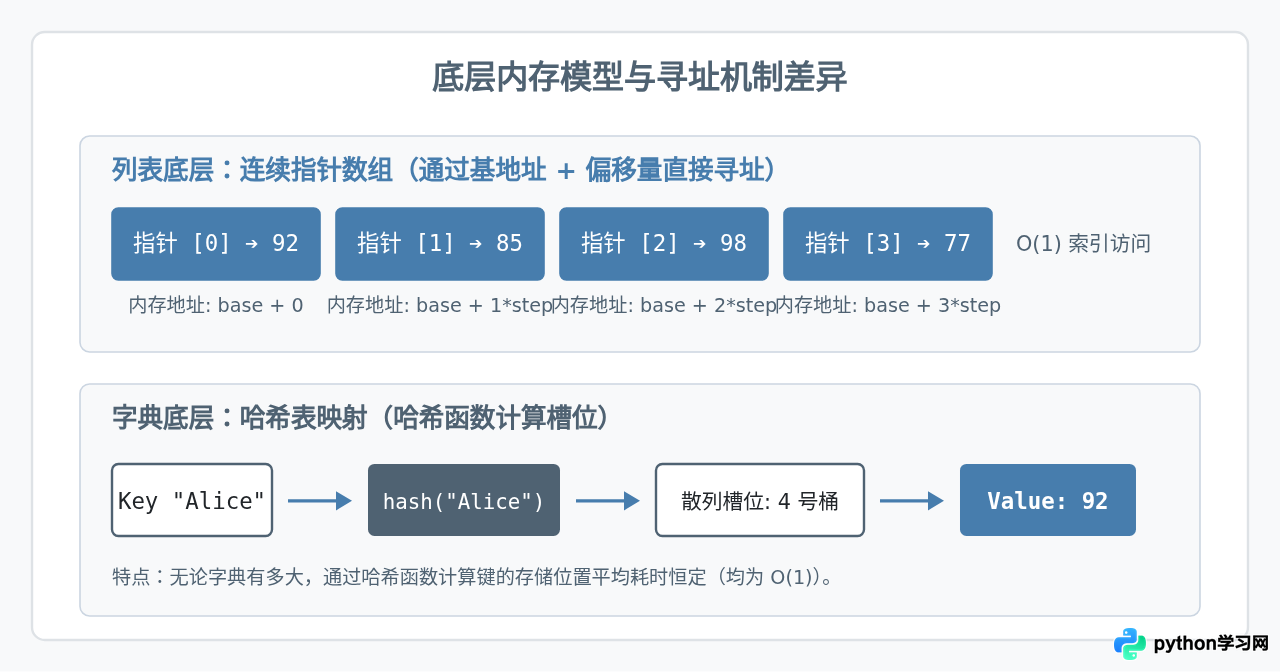
理解列表与字典运行机制的关键在于其底层的内存布局与寻址逻辑。
1. 列表基于连续指针数组
在 CPython 解释器中,列表本质是一个长度可变的动态数组,内部存放的是指向各个对象的指针列表。由于指针大小相同且在内存中连续排列,当通过 list[i] 访问元素时,计算机只需执行一次基础乘加运算(起始地址 + i * 指针步长),即可瞬间定位元素内存地址。因此,列表根据**索引**读取元素的时间复杂度是 O(1)。
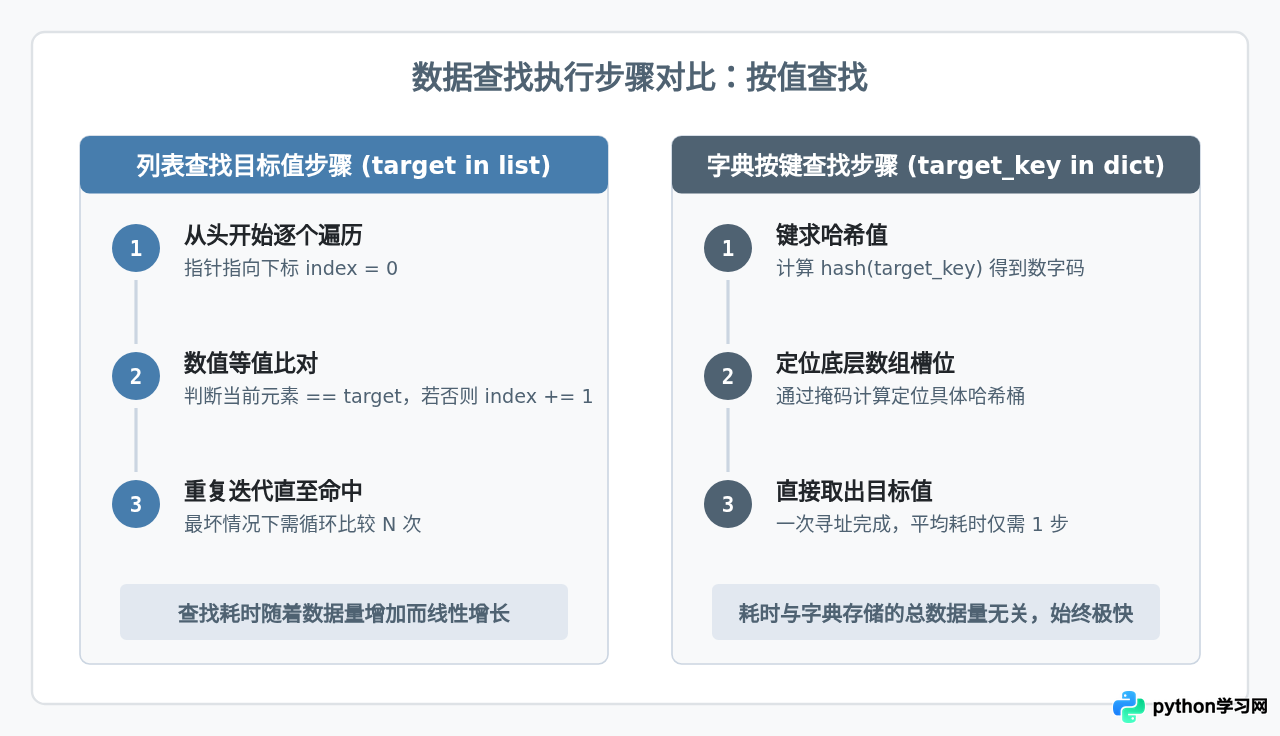
但是,如果要在列表中查找“某个特定值”(例如查询 98 in scores),系统只能从第 0 项开始逐项对比,直到找到目标或扫描完整列表。数据量越大,耗时越长,这种线性查找的时间复杂度是 O(n)。
2. 字典基于哈希表(Hash Table)
字典利用哈希算法建立映射。当你执行 student_scores["Alice"] 时,Python 会对键 "Alice" 调用哈希函数,根据生成的哈希值直接计算出存储桶(Bucket)的位置,直接取出对应的值。无需遍历其它数据,平均查找时间复杂度同样是 O(1)。
三、查找操作的操作步骤演示
为了直观展现两者在查询时的步骤区别,我们可以对比从含有千条记录的集合中查找具体数据的流程:
四、元素的约束条件与唯一性规则
除了访问方式,两者对存储元素本身的约束也有明显分界:
1. 列表包容度极高
列表中的元素可以是任何 Python 对象(整数、浮点数、字符串、其他列表、字典等),并且**完全允许元素重复**。同一个值在列表中出现多次是合法的,每次添加都会分配一个独立的递增索引。
# 列表中允许重复值和任意混合类型
mixed_list = [10, "text", [1, 2], 10, True, 10]
print(mixed_list.count(10))  # 输出:3
2. 字典对“键”有严格限制
在字典中:
- 键必须唯一:如果在初始化或赋值时出现相同名称的键,后出现的键值会直接覆盖前面的值。
- 键必须是“可哈希”(Hashable)对象:这意味着键必须是不可变数据类型(如
str、int、float、tuple)。不能用列表或字典作为字典的键,否则会直接引发运行时异常。 - 值(Value)没有限制:值可以是任意对象,包括列表、嵌套字典或重复的值。
如果尝试使用列表作为字典的键:
bad_dict = {[1, 2]: "data"},Python 会抛出 TypeError: unhashable type: 'list'。这是因为列表本身是可变的,如果允许作为键,其内容发生改变后会导致哈希值变化,从而破坏哈希表的一致性。
五、选型指导:在实际开发中如何选择?
初学者在编写程序时,常常纠结于当前这组数据该用列表保存还是用字典保存。可以通过以下判定逻辑进行决断:
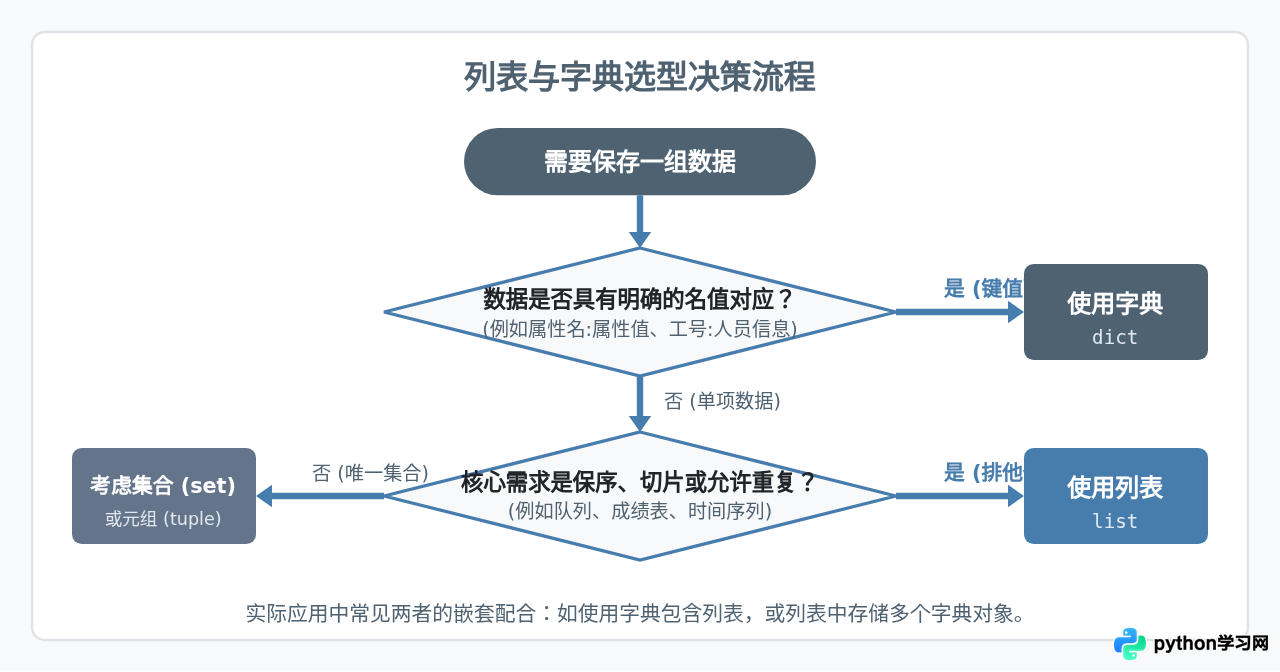
典型场景实测与选择:
- 优先选列表的场景:
- 处理具有天然先后顺序的数据流(如用户操作日志、时间戳队列、撤销操作的历史栈)。
- 需要对元素做数学切片(Slicing),例如取出前 5 名:
scores[:5]。 - 允许并需要保留完全相同的重复值。
- 优先选字典的场景:
- 结构化对象数据,例如描述一个商品:
{"sku": "A102", "title": "Keyboard", "price": 199}。如果用列表["A102", "Keyboard", 199],代码阅读者无法直观知晓 199 代表什么。 - 需要高频次、大规模地通过唯一标识(如身份证号、用户ID、单词名)查找对应数据。
- 构建计数器或分类索引系统。
- 结构化对象数据,例如描述一个商品:
六、全维度对比总结
为了加深理解,我们将两者的关键指标总结为下表及对比速查图:
| 对比维度 | 列表 (List) | 字典 (Dictionary) |
|---|---|---|
| 语法符号 | 中括号 [item1, item2] |
花括号 {key: value} |
| 数据组织 | 单项序列,依靠位置排列 | 双项键值对(Key ➔ Value) |
| 索引依据 | 整数索引(从 0 开始) | 不可变键(如字符串、整数、元组) |
| 元素重复性 | 允许完全重复 | 键绝对唯一(后写覆盖先写),值可重复 |
| 按索引/键访问耗时 | O(1) | O(1)(平均) |
| 按内容查找耗时 | O(n)(需要从头遍历比对) | O(1)(直接对键哈希定位) |
| 内存开销 | 相对紧凑,仅存储连续指针 | 稍大(需维护哈希表结构及稀疏索引桶) |
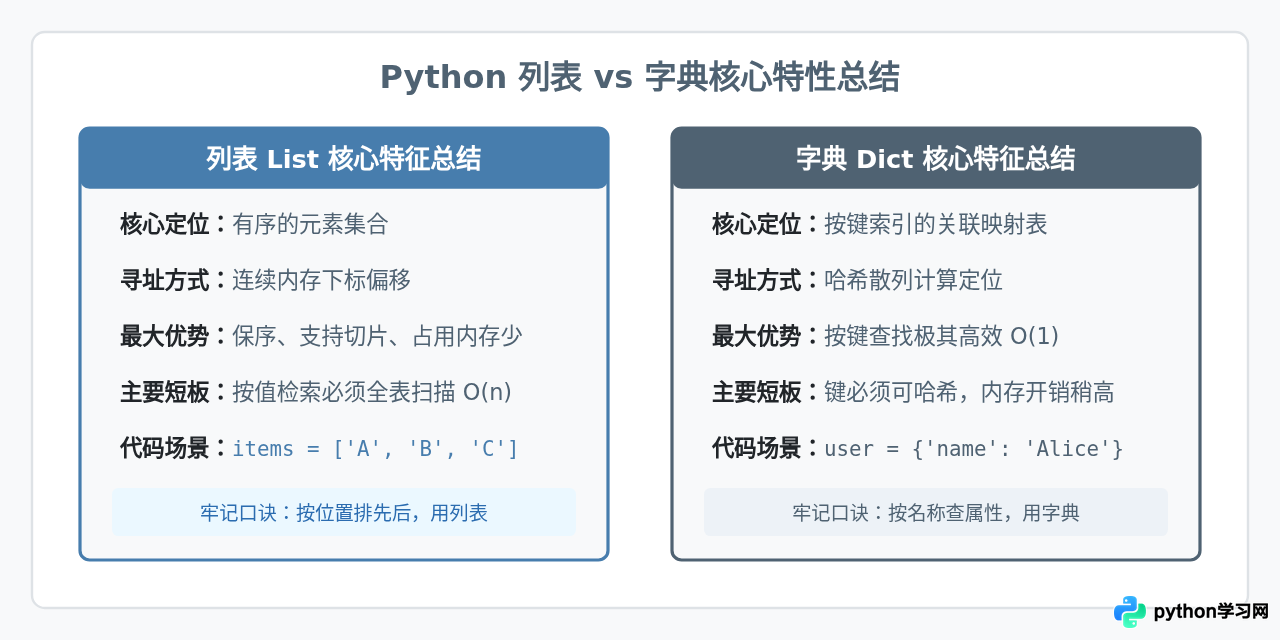
综上所述,列表与字典各有所长。在日常开发中,二者往往并不是非此即彼的对立关系,而是配合使用:用列表组织一批具有先后关系的事物,用字典描述每个事物内部的具体字段与属性,从而高效、清晰地表达复杂的业务数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















