


面试题:NumPy2.4相比2.3性能提升点在哪里?
深入解析面试高频题:NumPy 2.4 相比 2.3 在底层性能上的关键提升点,涵盖 Google Highway SIMD 指令集泛化、Free-threaded 无 GIL 线程并发优化、StringDType 原生操作向量化以及内部调用开销削减。
一、核心定调:如何专业回答这道面试题
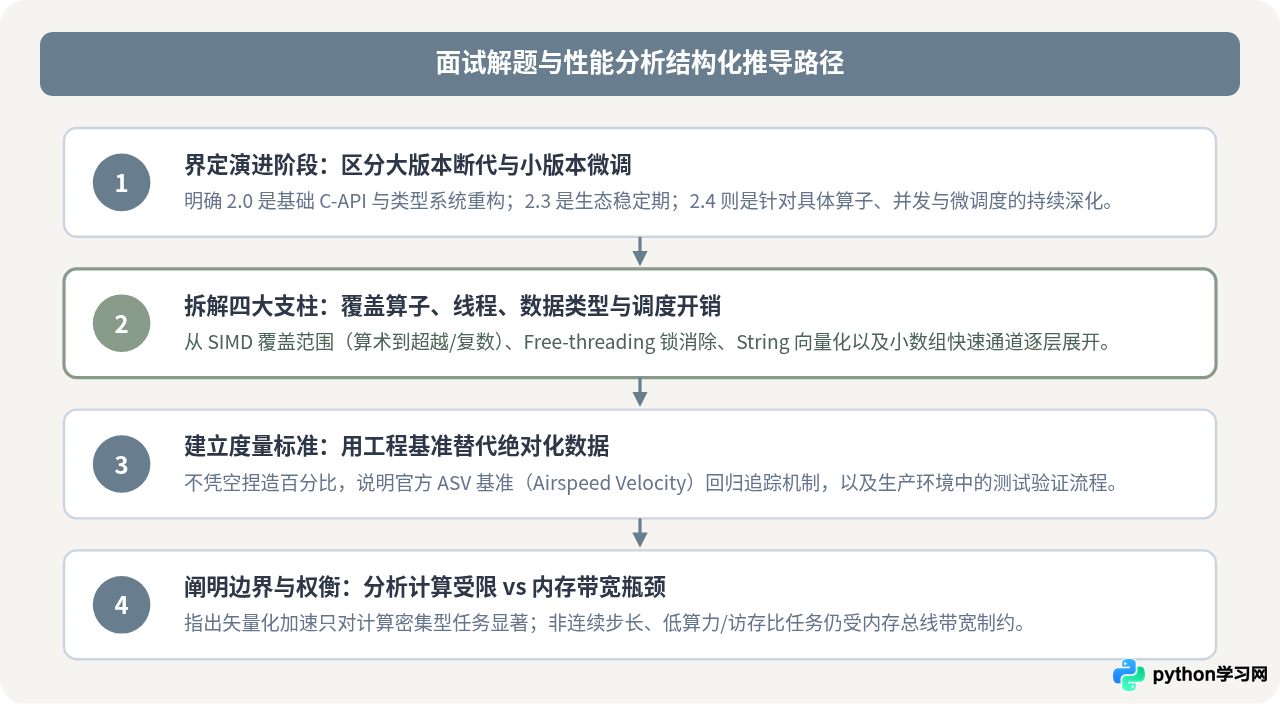
当面试官提出这道题时,最忌讳的是背诵泛泛的“速度提升了 30%”等虚构数据,或者把 NumPy 2.0 基础架构的重构(例如 NEP 50 标量提升规则、全新的 C-API 规范)生搬硬套到小版本迭代中。
回答应把握一个基本认知前提:NumPy 2.0 完成了整个项目的底层奠基(引入了 NEP 54 跨平台 SIMD 架构 Highway、规范化 DType 系统及 C-API);而 2.1 到 2.3 主要是生态兼容与基础功能落地;到了 NumPy 2.4,开发重心全面转移到对高阶算子、新兴并发运行环境和内存分发微路径的细粒度深挖。
建议采用“底层机制 + 具体算子 + 适用场景”的层次结构作答,展现对底层硬件指令、线程模型与内存局部性的技术掌控力。
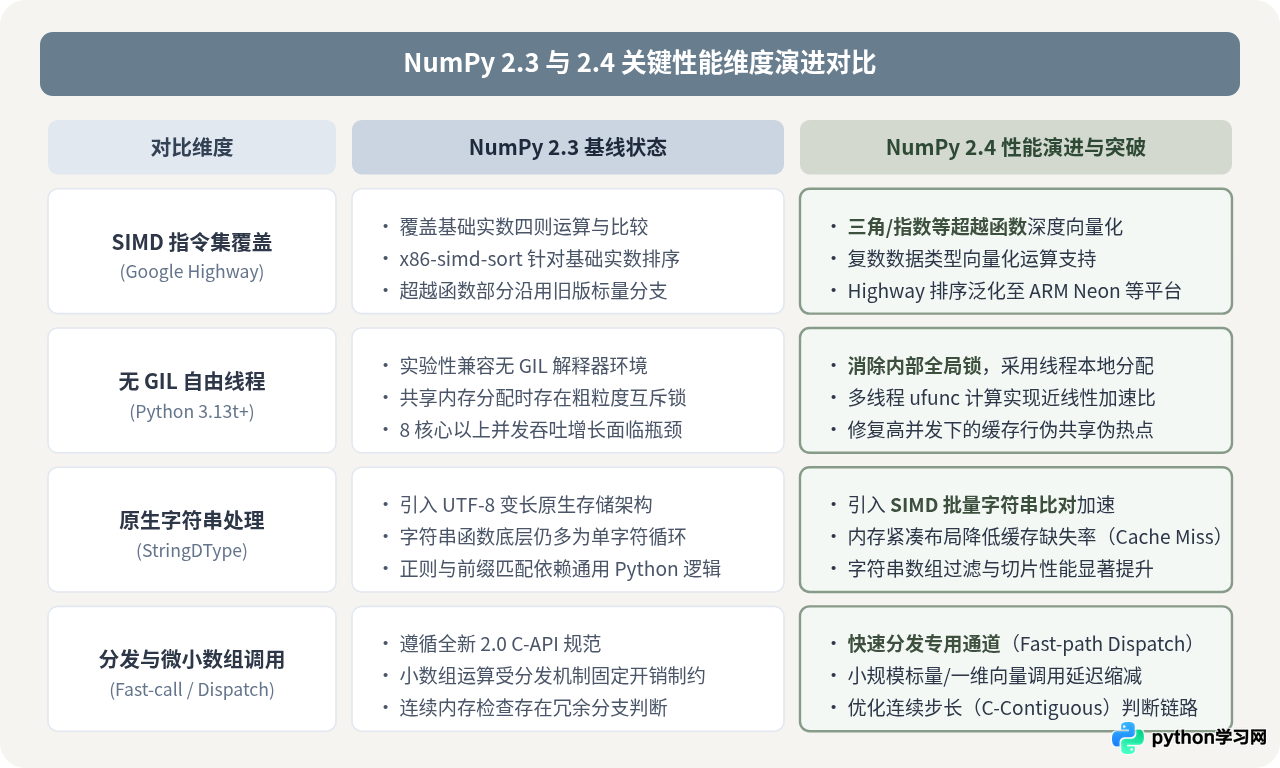
二、提升点一:Google Highway SIMD 指令集覆盖面的深化扩展
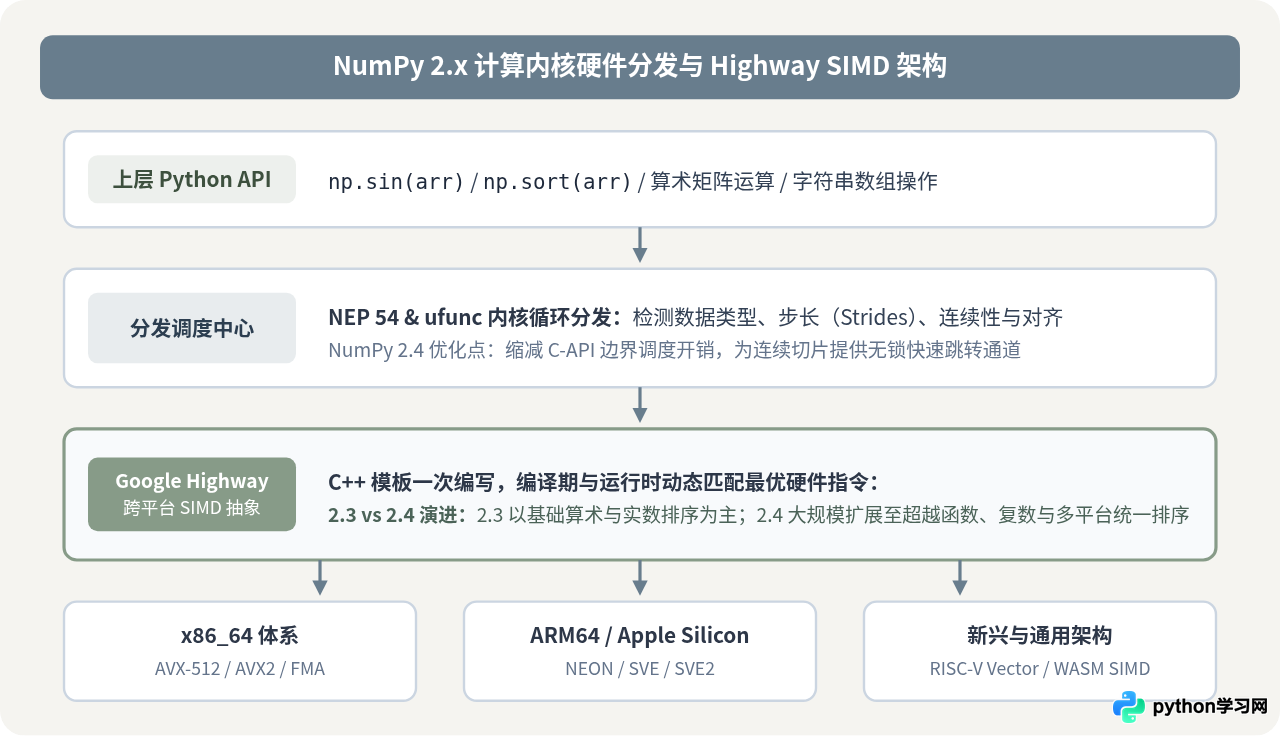
NumPy 2.x 时代彻底重构了以往零散、手写的 SIMD 指令分派机制,全面基于 Google Highway 库构建统一的跨平台向量化加速层。Highway 允许 NumPy 开发者只编写一次 C++ 模板逻辑,即可在编译期和运行时自动派发适配目标机器的最优 SIMD 扩展(从 x86 上的 AVX-512、AVX2 到 ARM 上的 NEON、SVE/SVE2,以及 RISC-V Vector)。
在 NumPy 2.3 中,Highway 的覆盖重点在于实数类型的四则运算、基本数学比较以及基础数值排序(整合 x86-simd-sort 核心理念)。而在 2.4 中,性能团队将 Highway 扩展到了此前被视为瓶颈的高阶运算场景:
- 超越函数与三角函数的向量化深度支持:如
np.sin、np.cos、np.exp等通用函数(ufunc),在 2.3 中对部分架构仍退回到标量数学库循环,而 2.4 则通过 Highway 实现了全架构向量逼近计算。 - 复数(Complex64 / Complex128)算子向量化:复数乘法与共轭运算在科学计算与信号处理中极具代表性,2.4 为其实装了专用的交替实虚部向量寄存器调度,减少内存解包与重排开销。
- 跨架构全功能快速排序:2.3 的向量排序高度依赖特定 x86 指令,2.4 则借助 Highway 彻底抽象了跨平台向量快速排序(Radix/Quicksort),使 ARM64(如 Apple Silicon 和 AWS Graviton)上的大型数组排序吞吐显著攀升。
三、提升点二:Free-threaded CPython(无 GIL)下的并行扩展性强化
Python 3.13 引入了基于 PEP 703 的自由线程模式(Free-threaded CPython,即去除全局解释器锁 GIL 的实验性构建)。NumPy 在 2.1 启动了初步兼容,并在 2.3 实现了可以在 python3.13t 下运行的目标。然而,“能够在无 GIL 下运行”与“能够高效并发扩展”存在本质区别。
在 NumPy 2.3 中,由于历史遗留的内部缓冲机制与共享内存分配器,多线程高频调用数组操作时,经常会陷入底层互斥锁(Mutex)的争用,导致随着核心数增加(如 8 核到 32 核),性能增长迅速见顶甚至倒退。
NumPy 2.4 在多线程并发上的核心突破:
- 内存分配器细粒度与线程本地化:减少内部临时缓冲区的全局锁竞争,为每个计算工作线程引入细粒度的空间复用逻辑。
- ufunc 内核多线程无锁执行:通用函数在释放 GIL 并行切分数据块时,全面移除多余的同步点,避免多核心之间的 CPU 缓存伪共享(False Sharing)。
- 高并发只读数组访问优化:优化了只读视图切片的引用计数机制与结构体共享机制,使得高并发并行推理与特征计算吞吐更具线性扩展比。
四、提升点三:StringDType 原生变长字符串的向量化加速
传统 NumPy 处理字符串的方式一直为人诟病:要么使用占用固定字节、尾部填充空格的 np.bytes_ / np.str_,浪费巨量内存;要么退化为 object 类型的指针数组,完全丢失连续内存和向量化优势。
NumPy 2.0 开始引入基于 NEP 52 的原生 StringDType(变长 UTF-8 连续字符串),在 2.3 中该特性趋于稳定。而在 2.4 中,重点放在了对字符串数组算子的向量化改造:
- SIMD 辅助的前缀比对与字符查找:对于常见的字符串相等性比对(
==)和排序,2.4 引入了 SIMD 短字符串向量查找,先通过向量掩码过滤大部分不匹配项,大幅降低逐字符分支跳转。 - 内存布局紧凑化:优化了变长数据的存储块头部(Header),提升 L1/L2 缓存行命中率(Cache Locality)。
- 原生字符串 ufunc:如字符串长度计算、截断、大小写转换等常用操作,逐步由单元素循环升级为连续内存批处理内核。
五、提升点四:分发快速通道(Fast-path Dispatch)与小数组微开销削减
NumPy 的强大在于通用性,但在处理小规模数组(例如物理仿真中由几万个 3x3 矩阵构成的迭代循环,或强化学习中的单步状态计算)时,函数分发与参数检查的固定开销往往远远超过实际的计算时间。
在 NumPy 2.3 中,每次调用 ufunc 都要经历相对繁复的类型推断(Promotion)、内存连续性检查与类型转换转换器循环。2.4 针对高频的常规场景构建了快速路径分发(Fast-path Dispatcher):
- 连续内存快速跃迁:对于一维/二维的 C 连续(C-Contiguous)标准数据类型数组,跳过冗长的多维步长计算链路,直达最内层运算指针。
- 优化 C-API 调用边界:精简 Python 参数解析与结果对象打包的内部结构体构建,使微小操作的函数调用延迟下降。
六、工程对比:两种典型场景下的性能特征差异
为了准确说明 2.3 与 2.4 性能差异的工程影响,我们可以在相同的硬件基准条件下,分析两种最具代表性的负载模式:
场景 A:大规模浮点数学变换(计算密集型)
典型任务:包含 np.sin(arr) + np.exp(arr) 的千万级 1D 数组变换。
NumPy 2.3 状态:受限于部分架构下的标量超越函数实现,主要瓶颈在 CPU 指令执行周期。
NumPy 2.4 表现:完全激活 Highway 跨平台向量加速,运算密集部分直接映射到矢量寄存器流水线,计算延迟显著收窄。
场景 B:多线程无 GIL 管道(并发扩展型)
典型任务:在 Python 3.13t 下启动 16 个线程同时处理独立的数据分片。
NumPy 2.3 状态:虽然能运行,但各线程频繁申请临时数组时出现内存锁竞争,多核加速比呈次线性饱和。
NumPy 2.4 表现:线程本地内存池与无锁分配生效,16 线程扩展效率平稳维持在高位,真正释放无 GIL 架构潜力。
七、如何验证与排查?官方基准与实操建议
在面试中,给出严谨的“验证手段”是体现工业界实战能力的关键一环。任何性能断言都应当能被标准化工具所复现和追踪。
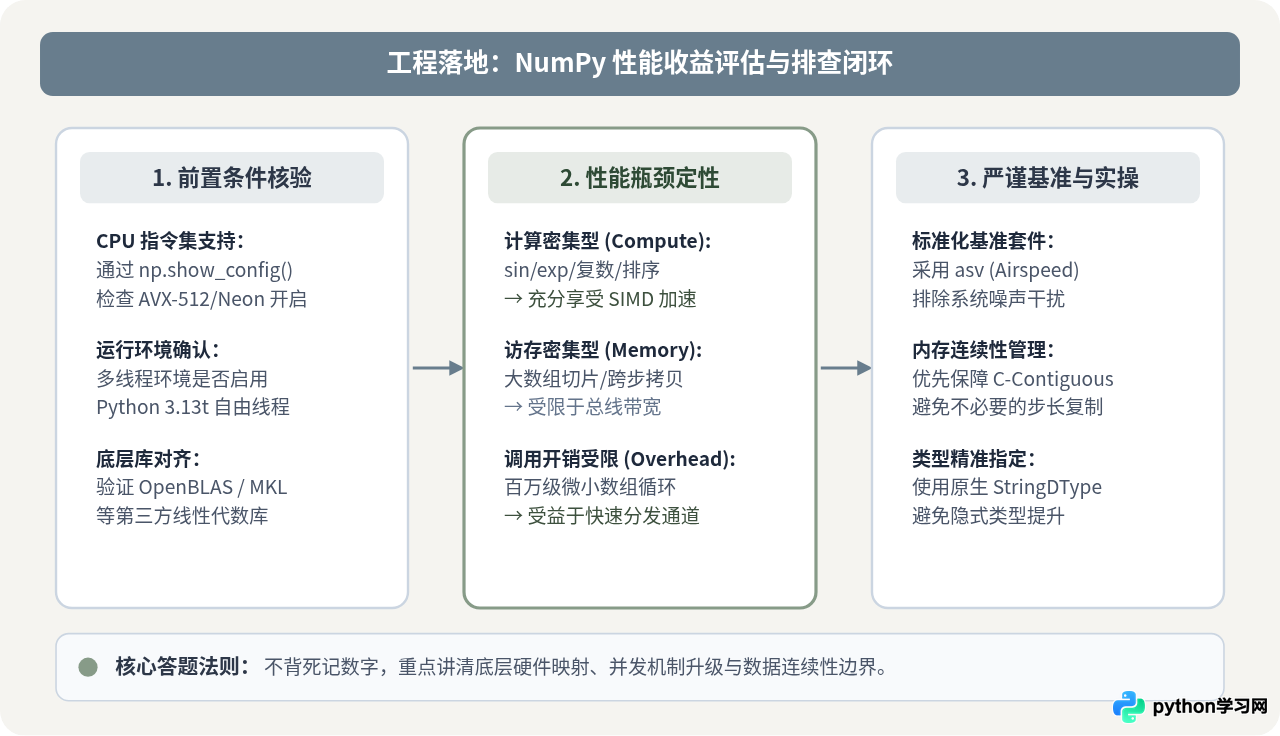
1. 查看当前编译与硬件指令加速配置
排查性能问题的第一步,始终是确认当前安装的 NumPy 轮子(Wheel)是否正确编译并启用了目标平台的 SIMD 模块:
import numpy as np

# 打印完整的构建配置与 CPU 指令集分发支持
print(np.show_config())

# 检查当前启用的 SIMD 特性(例如 AVX512_SKX, NEON 等)
print("NumPy Version:", np.__version__)
print("SIMD CPU Features:", np.lib.introspect.opt_func_info() if hasattr(np.lib, 'introspect') else "Check via show_config")
2. 使用 Airspeed Velocity (asv) 追踪基准
NumPy 官方核心团队绝不依赖随意的单次 time.time() 评测,而是通过官方基准套件 asv(Airspeed Velocity)在固定的裸金属服务器上做每日持续集成(CI)性能回归测试。候选人可以提及:
# 官方标准性能追踪命令示例(针对具体 ufunc 基准分支)
asv run -b bench_ufunc.Sin --quick
asv compare v2.3.0 v2.4.0
这种答题视角能立刻向面试官证明你熟悉大型开源基础设施的质量保障流程,而不是人云亦云。
八、常见认知误区与避坑指南
在理解 NumPy 性能时,最容易出现的几个思维误区需要特别注意:
- 误区一:升级 2.4 后所有代码都会自动翻倍变快。
事实:性能收益严格取决于任务性质。如果操作属于内存带宽受限型(Memory-bound)(例如超大数组的步长提取或简单元素复制),瓶颈在主板内存通道(DRAM Bandwidth),再先进的 SIMD 指令集也无法提升物理传输上限。 - 误区二:无视数据连续性(Contiguity)。
事实:无论是 Highway 还是底层分发快速路径,都对内存连续性有严格要求。如果数组经过多次跨步切片(如arr[::2, ::3])变成了非连续步长,NumPy 依然需要进行内存复制或进入步长跨度循环,SIMD 向量化率将大幅下降。 - 误区三:混淆 BLAS 矩阵乘法与 NumPy 内置算子。
事实:np.dot或@矩阵乘法的性能主要由底层链接的 OpenBLAS、Intel MKL 或 Apple Accelerate 决定;而 NumPy 2.4 优化的核心在于由 NumPy 自身维护的 ufunc、排序、数据类型转换与字符串计算内核。
九、总结回答模板
如果需要用 2 分钟在面试中给出一个条理清晰、层次分明的总结,可以参考以下表达结构:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















