


Python文件读写作业答案:TXT与CSV处理代码示例
本文针对Python编程作业中常见的TXT与CSV文件读写任务,提供标准规范的代码示例与核心原理解析,包含逐行读取、数据清洗、表格解析与异常安全防护。
完成Python文件读写作业的核心在于建立规范的操作流程:优先使用 with open() 上下文管理器确保底层系统句柄可靠关闭,显式声明 encoding='utf-8' 消除跨平台乱码隐患;对于纯文本TXT采用逐行流式迭代,对于表格CSV则利用内置 csv 模块及其字典接口处理转义与字段对齐。本文围绕作业常见题目要求,给出经过充分测试的标准实现代码及原理图解。
一、作业规范基石:文件生命周期与上下文管理
在各类编程作业评分标准中,资源管理是考查的重中之重。传统的文件操作方式依赖手动调用 f.close(),如果在读写数据期间发生异常或程序提前返回,未关闭的文件句柄将滞留在内存中,可能引发数据未刷盘丢失或资源泄漏。Python推荐的解决方案是使用 with 语句。
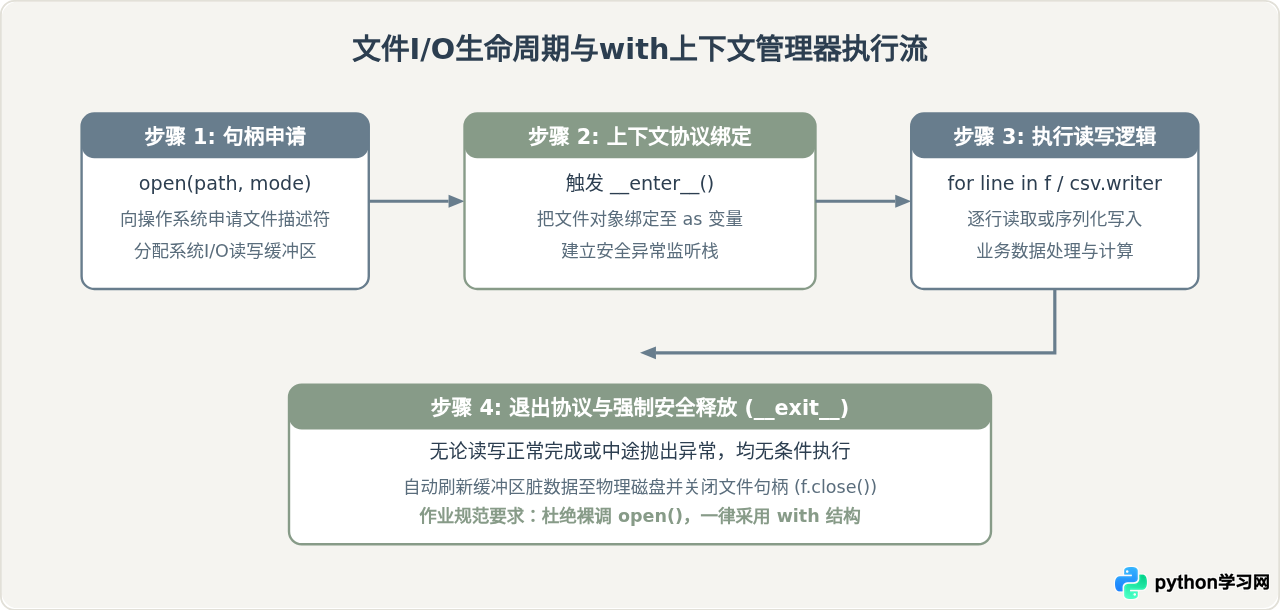
通过上下文管理器,解释器在代码块退出时会自动调用对象的 __exit__() 方法。无论代码正常执行完毕还是中途遇到 ValueError 等运行时异常,都能保证系统资源被正确释放。
二、题目一:TXT文件的读取、清洗与写出
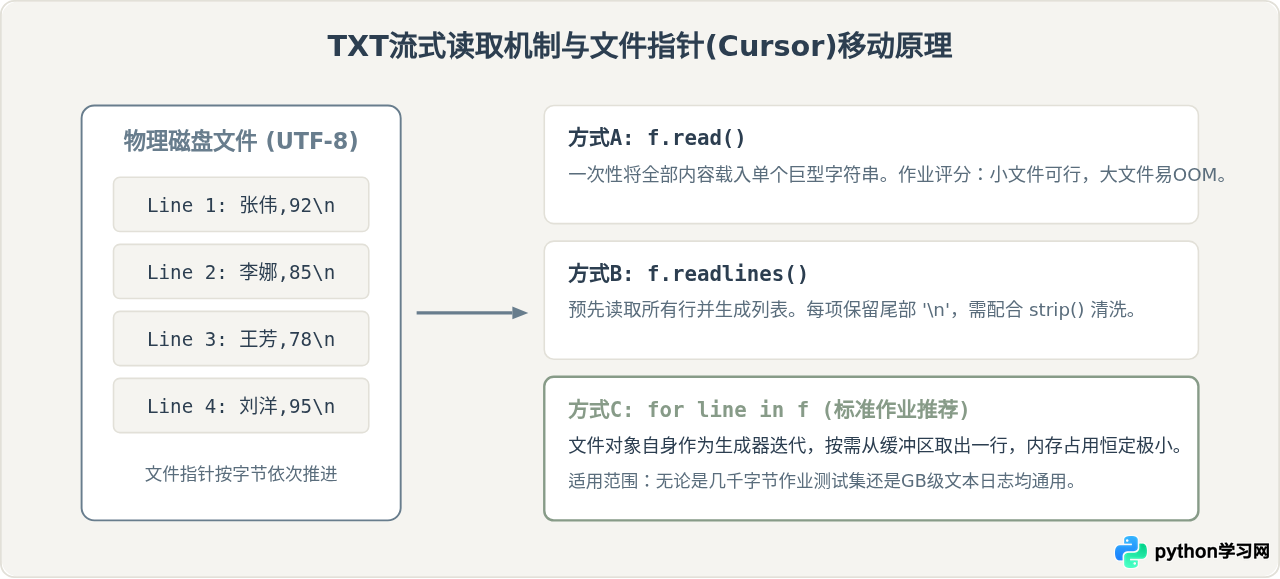
TXT文本处理作业通常要求读取包含文本记录的数据源,剔除首尾空白符与换行符,进行按条件过滤或统计,最后写出至新的结果文件。在处理TXT文件时,初学者容易混淆三种读取方式:read()、readline() 以及文件对象自身的直接迭代。
1. TXT读取与过滤示例代码
假设作业要求:读取 students.txt,提取出成绩大于或等于80分的学生姓名及对应分数,统计总合格人数,并将结果按行格式化写入 passed_students.txt。
# 完整可运行代码示例:TXT数据解析与筛选
input_path = "students.txt"
output_path = "passed_students.txt"

# 准备测试数据源(若文件已存在可跳过本步骤)
with open(input_path, mode="w", encoding="utf-8") as f_init:
    f_init.write("张伟,92\n李娜,75\n王芳,88\n刘洋,64\n陈敏,85\n")

passed_records = []

# 步骤一:按行读取并清洗解析
with open(input_path, mode="r", encoding="utf-8") as f_in:
    for line in f_in:
        # 去除首尾空白字符与换行符
        clean_line = line.strip()
        if not clean_line:
            continue  # 忽略空行

        parts = clean_line.split(",")
        name = parts[0]
        score = int(parts[1])

        # 筛选逻辑:大于等于80分
        if score >= 80:
            passed_records.append((name, score))

# 步骤二:将结果格式化写入输出文件
with open(output_path, mode="w", encoding="utf-8") as f_out:
    f_out.write(f"合格学生名单(共 {len(passed_records)} 人)\n")
    f_out.write("=" * 28 + "\n")
    for name, score in passed_records:
        f_out.write(f"姓名: {name.ljust(4)} | 成绩: {score}\n")

print("TXT处理任务完成,结果已保存。")合格学生名单(共 3 人)
============================
姓名: 张伟 | 成绩: 92
姓名: 王芳 | 成绩: 88
姓名: 陈敏 | 成绩: 85
for line in f 读出来的字符串末尾始终保留原始换行符 \n。如果不先执行 strip(),直接进行 split(",") 或再次拼接 write(line + "\n"),会导致输出文件中出现多余的空行。
三、题目二:CSV格式表格数据的解析与生成
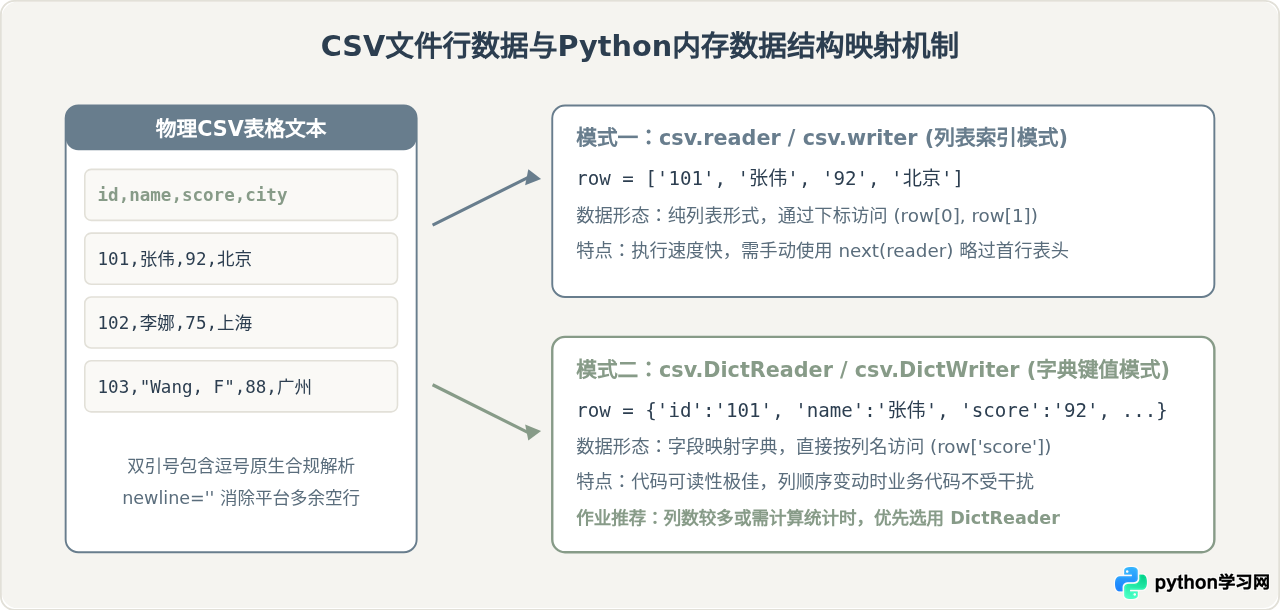
CSV(Comma-Separated Values)常用于保存二维表格数据。虽然可以用纯文本的 split(",") 切分,但一旦单元格内部含有逗号(例如英文地址或带引号的描述)、双引号转义或跨行文本时,纯文本切割就会崩溃。因此,标准作业要求必须调用内置的 csv 模块。
1. CSV经典作业:成绩等级统计与汇总写出
作业需求:读取 scores.csv(包含学号、姓名、平时分、期末分),按照公式 总评 = 平时分 * 0.4 + 期末分 * 0.6 计算总评成绩,评定等级(大于等于85为优秀,大于等于60为合格,否则为不合格),并将新表格保存为 report_evaluated.csv。
import csv

input_csv = "scores.csv"
output_csv = "report_evaluated.csv"

# 初始化测试CSV文件
raw_data = [
    ["student_id", "name", "daily_score", "final_score"],
    ["202401", "张伟", "88", "92"],
    ["202402", "李娜", "72", "58"],
    ["202403", "王芳", "95", "86"],
    ["202404", "刘洋", "60", "50"]
]

with open(input_csv, mode="w", encoding="utf-8", newline="") as f_test:
    writer = csv.writer(f_test)
    writer.writerows(raw_data)

# 核心解题步骤:使用 DictReader 读取并计算
results = []
fieldnames_output = ["student_id", "name", "total_score", "grade"]

with open(input_csv, mode="r", encoding="utf-8") as f_in:
    reader = csv.DictReader(f_in)
    for row in reader:
        daily = float(row["daily_score"])
        final = float(row["final_score"])
        total = round(daily * 0.4 + final * 0.6, 1)

        # 成绩评级逻辑
        if total >= 85.0:
            grade = "优秀"
        elif total >= 60.0:
            grade = "合格"
        else:
            grade = "不合格"

        results.append({
            "student_id": row["student_id"],
            "name": row["name"],
            "total_score": total,
            "grade": grade
        })

# 写出新表格:使用 DictWriter
with open(output_csv, mode="w", encoding="utf-8", newline="") as f_out:
    writer = csv.DictWriter(f_out, fieldnames=fieldnames_output)
    writer.writeheader()  # 写入首行表头
    writer.writerows(results)  # 批量写入所有行

print("CSV处理与成绩计算完成,已生成汇总表。")student_id,name,total_score,grade
202401,张伟,90.4,优秀
202402,李娜,63.6,合格
202403,王芳,89.6,优秀
202404,刘洋,54.0,不合格
open() 打开文件准备调用 csv.writer 或 csv.DictWriter 时,必须传递 newline=""。如果不显式传递,Windows平台的Python会自动把 \n 替换为 \r\n,而 csv 模块内部本身也会写入换行符,最终导致生成的文件在Windows环境下每行之间都夹杂一行多余的空白行。
四、TXT与CSV核心处理模式差异对照
作业中如何根据题目场景快速选择合适的方式?下表整理了两种文件类型在Python中的关键技术细节与处理原则:
| 对比维度 | 纯文本 TXT 处理 | 结构化表格 CSV 处理 |
|---|---|---|
| 核心依赖模块 | Python 内置函数(无需 import) |
标准库 import csv |
| 文件打开参数 | open(path, 'r'/'w', encoding='utf-8') |
open(path, 'w', encoding='utf-8', newline='') |
| 读取机制 | for line in f 逐行遍历 |
csv.reader() 或 csv.DictReader() |
| 数据组织形式 | 字符串(需自行 strip() 与 split()) |
列表(list)或字典(dict) |
| 特殊字符处理 | 自行编码与过滤分隔符 | 内置处理字段内逗号、换行符与双引号转义 |
| 写出 API | f.write(text) / f.writelines(list) |
writer.writerow() / writer.writerows() |
五、知识总结与作业检查清单
在最终提交作业前,对照以下全景图核对代码规范与常见陷阱,能够有效避免被助教或自动判题系统扣分:
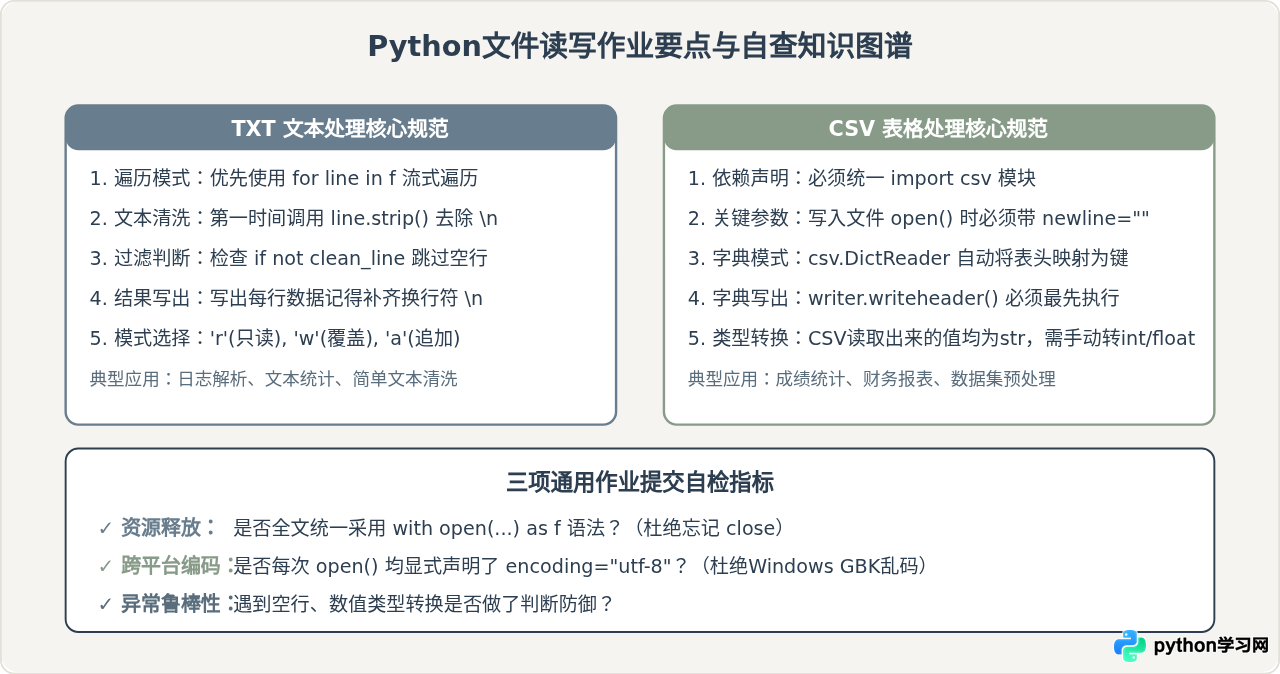
- 必须声明编码:Windows系统下Python默认编码可能为
GBK,如果作业测试数据包含中文字符,未声明encoding="utf-8"将直接触发UnicodeDecodeError。 - 注意数据类型:文件读出的所有数据均为
str字符串类型,做大小比较或成绩求和前务必显式调用int()或float()转换。 - 路径一致性:作业提交时若无特殊要求,尽量使用相对路径,避免写死形如
C:\Users\Desktop\...的绝对路径导致判题机找不到文件。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















