


python必背源代码列表去重三种方法代码
全面讲解Python列表去重的三种必背核心方法源代码:set()集合转换法、dict.fromkeys()保序法以及循环配合辅助集合法。详细分析运行效率、保序机制、底层原理及选型场景。
方法一:基于 set() 集合转换法(极速无序去重)
集合(Set)是 Python 内置的无序哈希表结构,其元素具有天然的唯一性。将列表转换成集合时,Python 底层会自动利用元素的哈希值进行判重,相同的元素只保留一份;随后再使用 list() 将集合转回列表,即可完成去重。
完整源代码实现
# 示例 1:使用 set() 快速去重
original_numbers = [3, 1, 2, 3, 1, 5, 2, 4]

# 核心代码:转为 set 去重后再转回 list
deduped_numbers = list(set(original_numbers))

print("原列表:", original_numbers)
print("去重后:", deduped_numbers)去重后: [1, 2, 3, 4, 5]
从输出可以看出,不仅重复的数值 3、1、2 被顺利去除,而且输出列表的排列顺序与初始顺序不同。由于集合内部完全按照哈希槽(Hash Bucket)的分布排列,原始索引位置被彻底打乱。
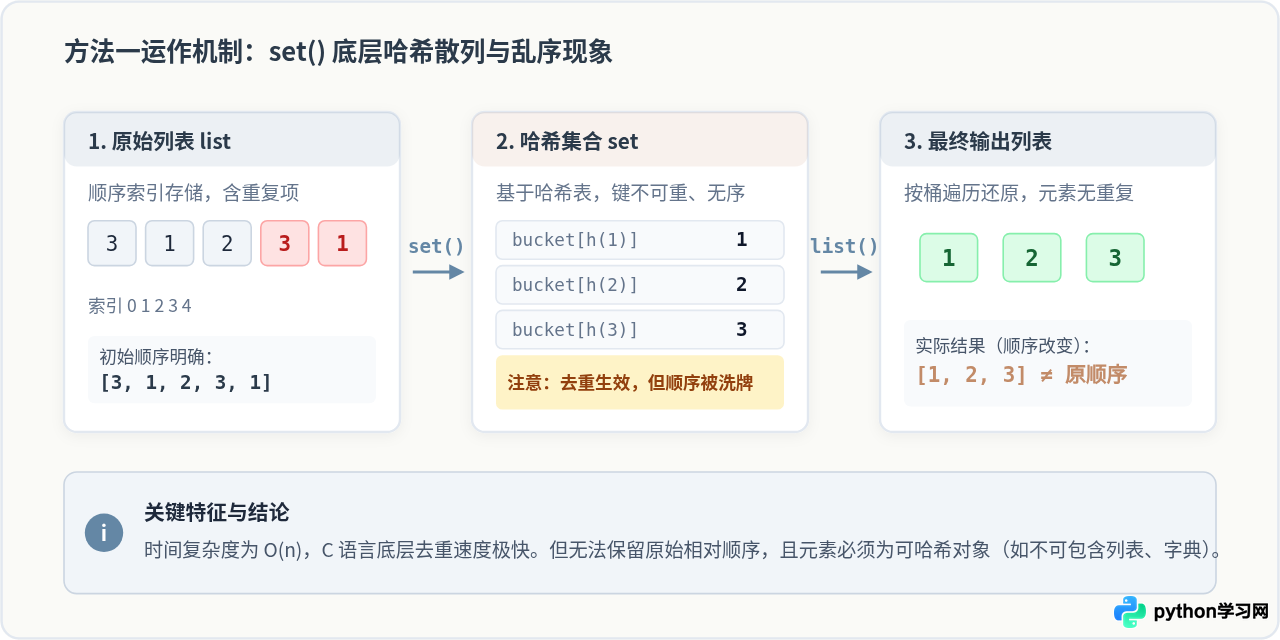
- 顺序丢失:不能用于需要维持时间先后、排名先后或原始出现次序的业务场景。
- 可哈希要求:列表内的所有元素必须是不可变对象(Hashable)。若列表中含有子列表(
list)或字典(dict),运行set()时会直接抛出TypeError: unhashable type: 'list'异常。
方法二:基于 dict.fromkeys() 字典键去重(高效标准保序)
在需要保留元素首次出现顺序的实际开发中,dict.fromkeys() 是目前 Python 社区最推荐的单行标准解法。字典的键同样依赖哈希机制实现去重,但从 Python 3.7 开始(官方规范,CPython 3.6 实现),标准字典具备了严格保持插入顺序(Insertion-ordered)的语言级保证。
完整源代码实现
# 示例 2:使用 dict.fromkeys() 实现保序去重
fruits = ["apple", "banana", "apple", "orange", "banana", "grape"]

# 核心代码:利用字典键去重且保持插入顺序
deduped_fruits = list(dict.fromkeys(fruits))

print("原列表:", fruits)
print("保序去重后:", deduped_fruits)保序去重后: ['apple', 'banana', 'orange', 'grape']
dict.fromkeys(iterable) 方法会依次扫描传入的可迭代对象,以序列中的元素作为字典的键。首次遇到的元素被写入字典末尾;随后再次遇到同名键时,仅做值更新或直接跳过,不会移动已排好的键顺序。最后调用 list() 提取字典所有键,得到的列表次序与原始列表中首次出现的顺序分毫不差。
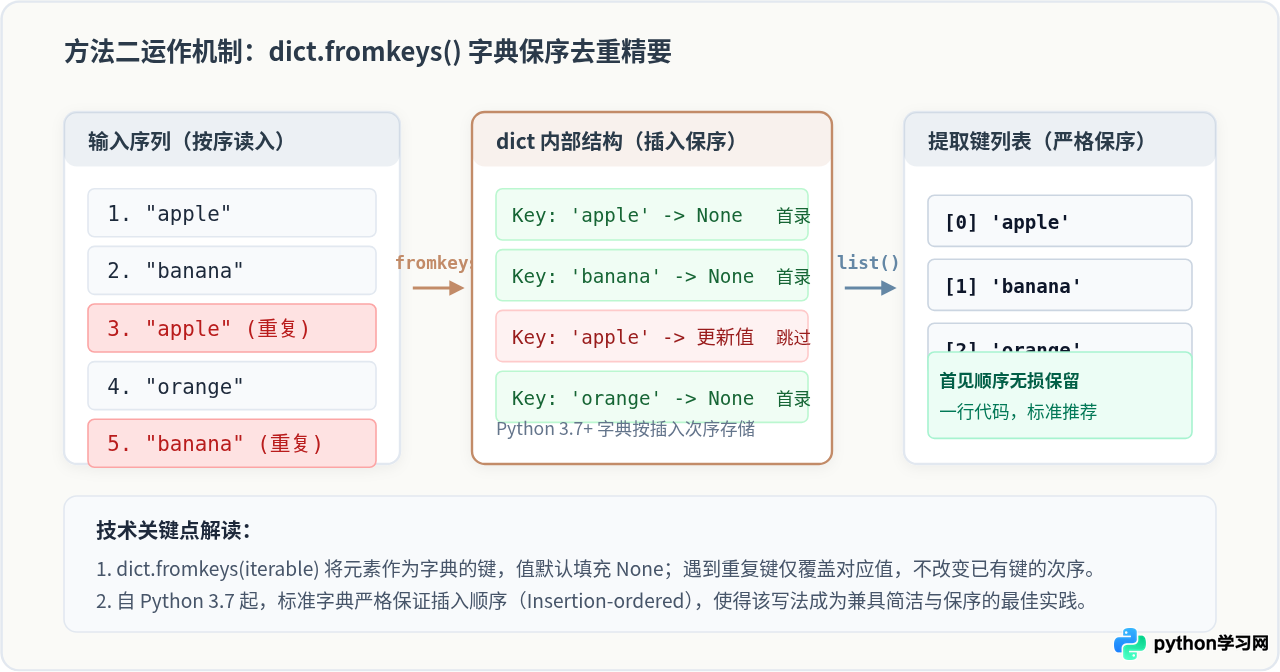
这一方法在底层全部由 C 语言循环执行,避免了在 Python 解释器层面执行频繁的 Python 字节码,因此它的执行速度仅略次于纯 set(),远优于手工编写的常规循环。
方法三:循环遍历结合辅助集合法(通用保序与定制逻辑)
当业务逻辑不仅是简单去重,还需要在去重过程中执行过滤、记录统计信息或处理复杂对象时,手写遍历配合辅助 seen 集合是最清晰、扩展性最强的实现方式。
完整源代码实现
# 示例 3:双轨制循环遍历去重函数
def deduplicate_keep_order(items):
    seen = set()       # 用于 O(1) 瞬时哈希查重
    result = []        # 用于存放保序去重结果
    for item in items:
        if item not in seen:
            seen.add(item)
            result.append(item)
    return result

# 执行测试
user_ids = [102, 105, 102, 108, 105, 101, 108]
unique_ids = deduplicate_keep_order(user_ids)

print("原始ID列表:", user_ids)
print("保序处理结果:", unique_ids)保序处理结果: [102, 105, 108, 101]
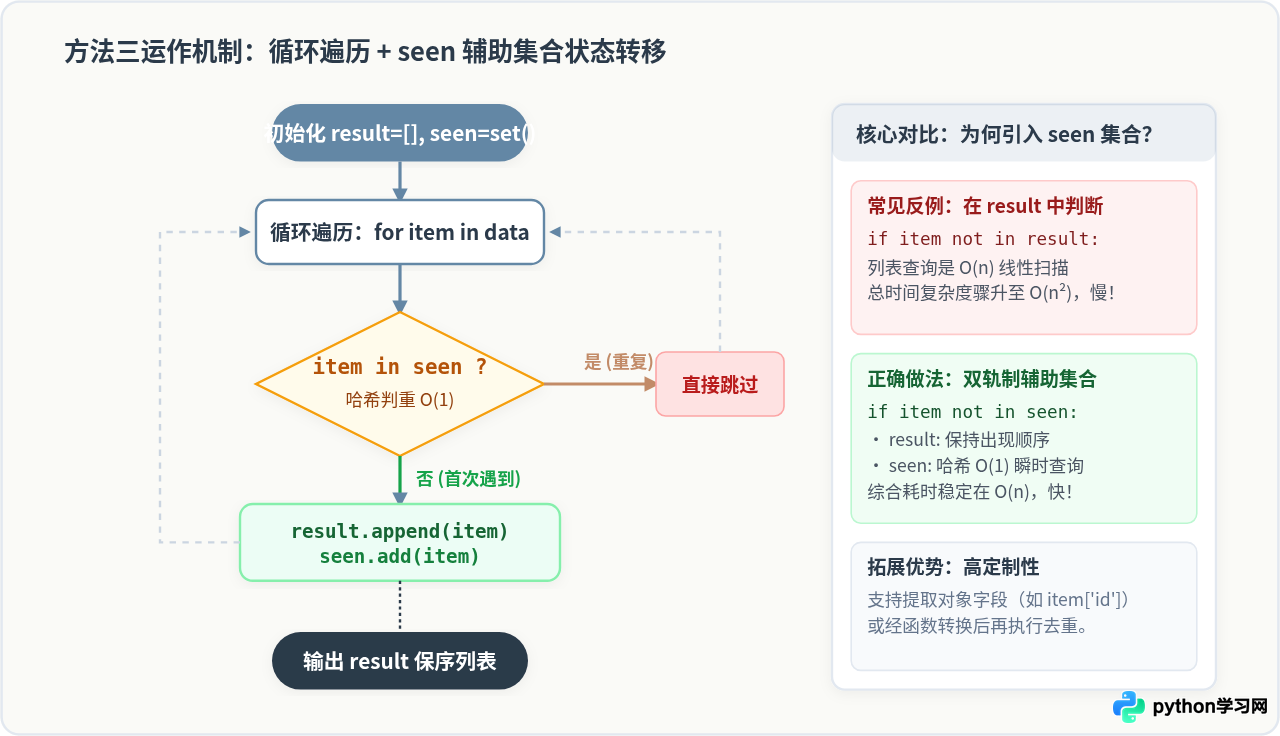
常见初学者误区剖析:为什么绝不能用 item not in result?
许多初学者在手写去重时,常常习惯省略 seen 集合,直接写成:
# 错误反例:千万避免在大数据量下这样写
result = []
for item in items:
    if item not in result:  # 此处在 list 中查找,耗时为 O(k) 线性遍历!
        result.append(item)
在 list 中执行 in 查找,Python 必须从头到尾逐个比对元素,每次比对都是 \(O(k)\) 的时间开销。当原始列表包含 10 万条数据时,总运算步数高达数十亿次,程序将产生极其明显的卡顿甚至假死。而使用 seen = set() 辅助集合后,item not in seen 是基于哈希计算的 \(O(1)\) 常数级查找,整体时间复杂度始终稳定在 \(O(n)\),运行在数毫秒内即可完成。
代码进阶:按对象属性或指定键去重
辅助集合法的最大优势在于可扩展性。例如针对包含字典或对象的列表,按照某一唯一字段(如 id)去重:
students = [
    {"id": 1, "name": "Alice"},
    {"id": 2, "name": "Bob"},
    {"id": 1, "name": "Alice Duplicate"},
    {"id": 3, "name": "Charlie"}
]

seen_ids = set()
unique_students = []

for s in students:
    if s["id"] not in seen_ids:
        seen_ids.add(s["id"])
        unique_students.append(s)

print("按学号去重后人数:", len(unique_students))
print("首条记录保留:", unique_students[0])首条记录保留: {'id': 1, 'name': 'Alice'}
三种方法横向综合对比与技术选型
面对具体业务,应根据性能要求、是否保序以及代码维护成本进行权衡。
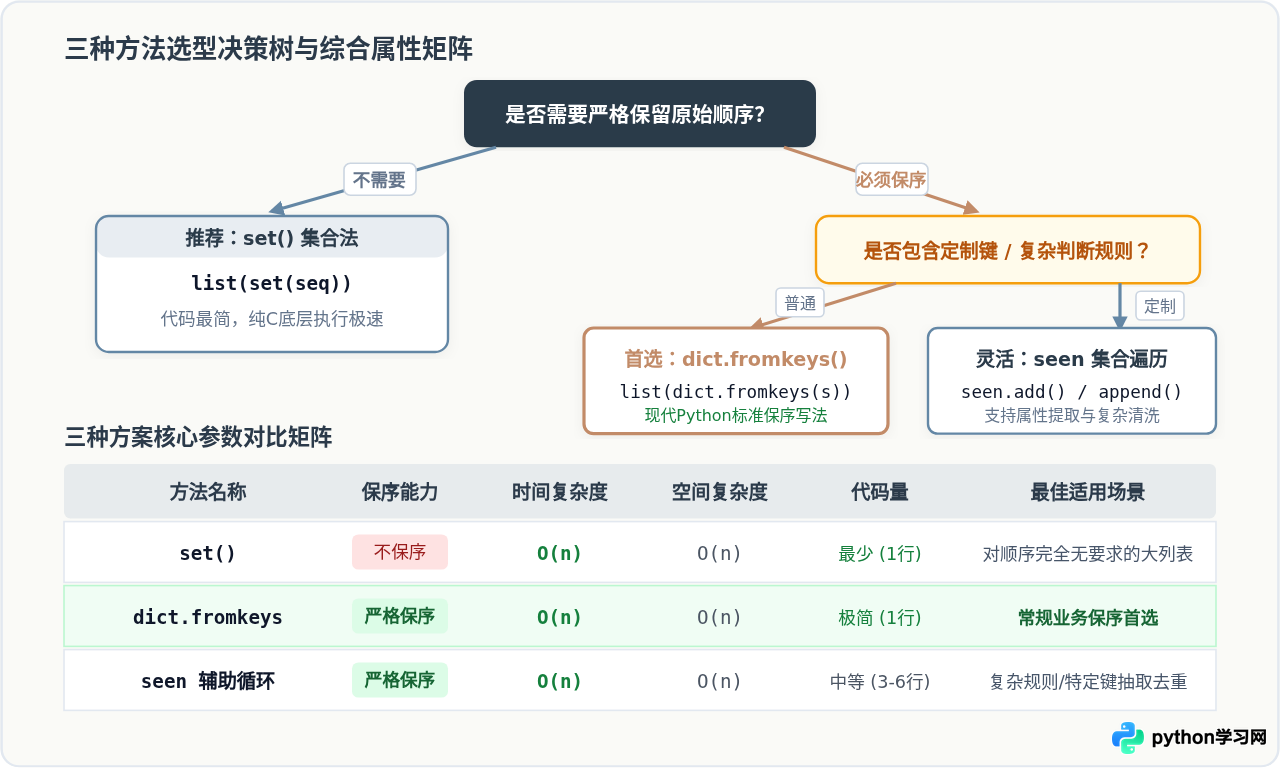
| 去重方法 | 核心代码 | 是否保序 | 时间复杂度 | 空间复杂度 | 适用环境与场景 |
|---|---|---|---|---|---|
| set() 集合法 | list(set(seq)) |
否(乱序) | O(n) | O(n) | 无所谓顺序的数学集合计算、极大规模简单数据统计 |
| dict.fromkeys() 法 | list(dict.fromkeys(seq)) |
严格保序 | O(n) | O(n) | Python 3.7+ 现代工程中最推荐的通用保序去重 |
| seen 辅助遍历法 | seen.add() + append() |
严格保序 | O(n) | O(n) | 复杂对象清洗、按特定属性去重、带有副作用的业务逻辑 |
总结与选型口诀
在日常开发与技术面试中,记住以下三句话即可熟练应对所有列表去重场景:
- 只要速度不顾顺序:直接调用
list(set(seq)),代码最短、底层纯 C 执行; - 日常开发首选保序:直接编写
list(dict.fromkeys(seq)),简洁标准、性能卓越; - 复杂对象与自定义键:构建
seen = set()辅助循环,保证 \(O(n)\) 性能的同时支持任意自定义提取规则。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















