


python必背源代码读写CSV文件csv代码
深入详解Python内置csv模块读写CSV文件的核心必背源代码。包含csv.reader、csv.writer列表模式,csv.DictReader、csv.DictWriter字典模式,以及跨平台换行newline与Excel中文乱码底层机制解析。
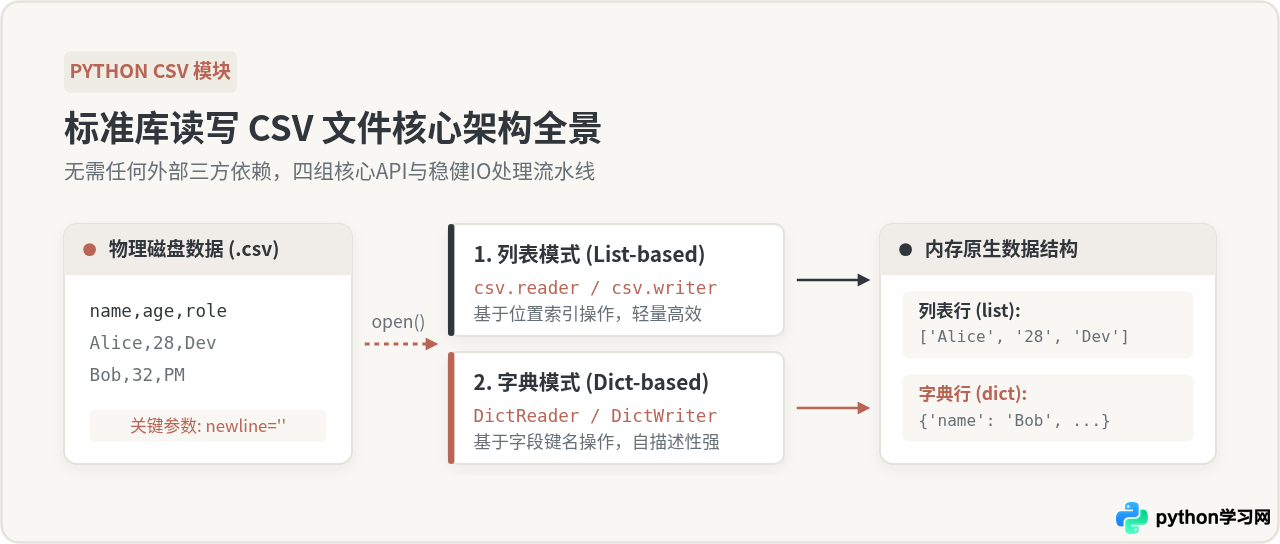
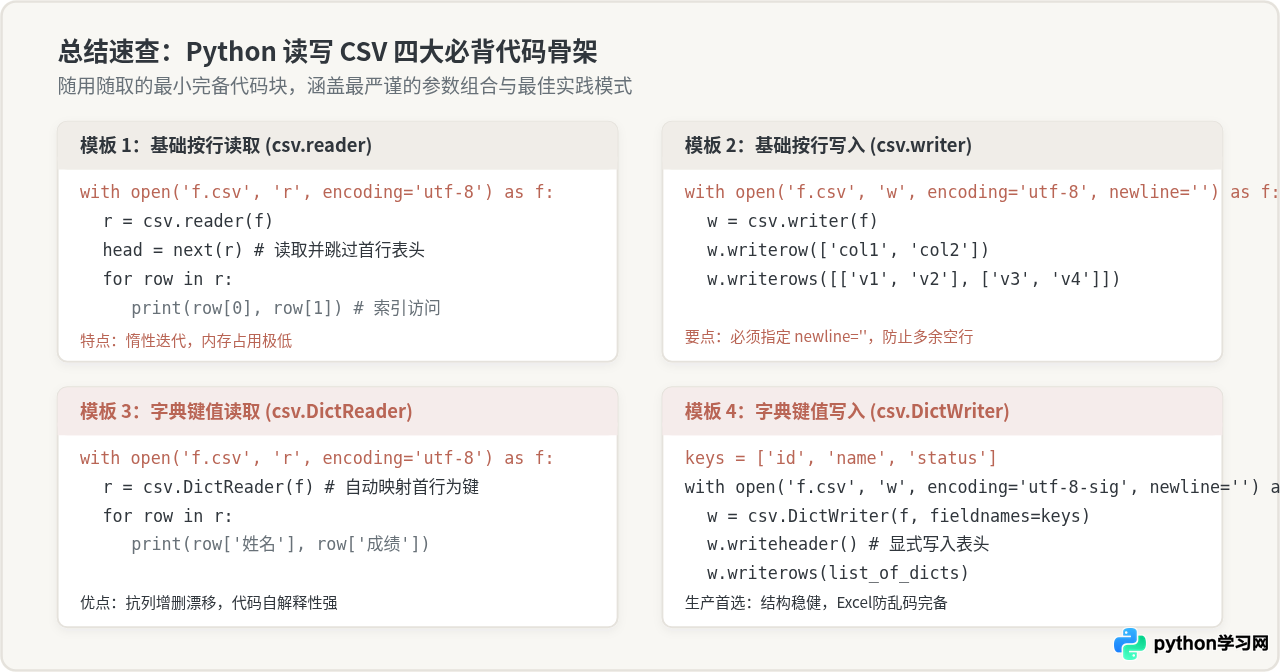
csv 模块。读者只需牢记四套核心代码骨架即可覆盖大部分开发需求:按列表行读取的 csv.reader、按列表行写入的 csv.writer,以及通过表头键名操作的 csv.DictReader 与 csv.DictWriter。在文件打开阶段配合 open() 函数的 newline='' 与编码参数(如 utf-8 或针对Excel环境的 utf-8-sig),能够彻底杜绝跨平台额外空行与中文乱码两大核心隐患。
一、基于列表的基础读写代码(csv.reader 与 csv.writer)
列表读写模式将CSV中的每一行映射为一个纯字符串列表(list[str])。该模式运行速度快、内存开销极小,适合列结构固定、列数较少或不需要依赖表头语义的场景。
1. 必背读取代码:逐行读取并跳过表头
使用 csv.reader() 包装打开的文件对象。该对象本身是一个迭代器,直接使用 next() 可以读取并消费第一行表头,随后通过 for 循环按行迭代数据:
import csv

# 1. 必背读取源代码(列表模式)
file_path = 'data.csv'

with open(file_path, mode='r', encoding='utf-8') as f:
    reader = csv.reader(f)

    # 获取表头(如果第一行是列名)
    header = next(reader)
    print("表头字段:", header)

    # 逐行读取数据行,row 为字符串列表
    for row in reader:
        # 示例输出:['101', '张三', '技术部', '95.5']
        user_id = row[0]
        user_name = row[1]
        print(f"工号: {user_id}, 姓名: {user_name}")
csv.reader 是惰性求值的生成器,它不会一次性把整个文件载入内存,即使读取数吉字节(GB)的日志文件也能保持恒定的内存占用(O(1) 空间复杂度)。切忌在没有必要时编写 lines = list(reader),这会强行将所有行实例化为内存列表,失去生成器的内存优势。
2. 必背写入代码:单行写入与多行批量写入
写入CSV时,使用 csv.writer() 包装写模式打开的文件。写入单行使用 writerow(),写入包含多个列表的二维结构使用 writerows():
import csv

# 2. 必背写入源代码(列表模式)
header = ['id', 'name', 'department', 'score']
rows = [
    ['101', '张三', '技术部', '95.5'],
    ['102', '李四', '运营部', '88.0'],
    ['103', '王五', '设计部', '92.3']
]

# 注意:写入时必须显式设置 newline=''
with open('output_list.csv', mode='w', encoding='utf-8', newline='') as f:
    writer = csv.writer(f)

    # 写入单行表头
    writer.writerow(header)

    # 批量写入所有数据行
    writer.writerows(rows)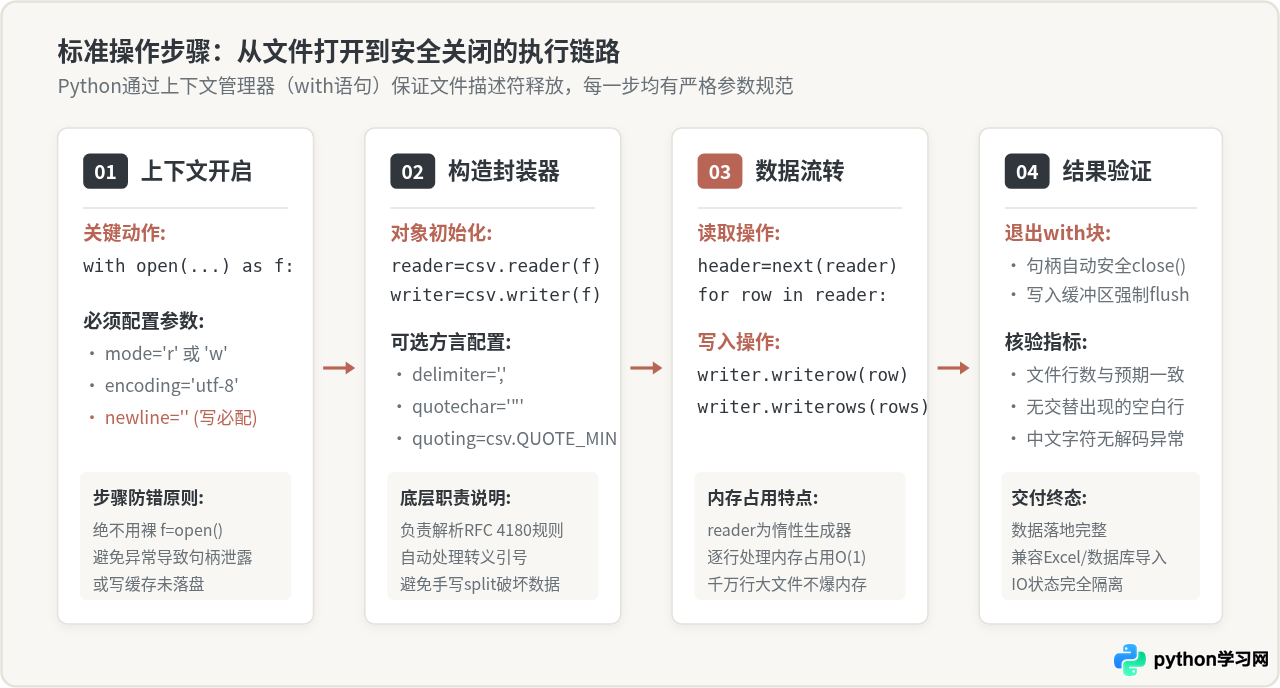
二、基于字典的结构化读写代码(DictReader 与 DictWriter)
在实际业务脚本中,CSV文件的列数往往很多,或者上游数据源可能会调整列的物理排布顺序。如果继续依赖下标 row[0]、row[1] 访问,一旦增删列就会导致全局逻辑错乱。此时应当使用字典模式。
1. 必背字典读取:csv.DictReader
DictReader 会默认将文件首行解析为字典的键(Keys),随后的每一行都映射为一个标准字典。读取者直接使用字段名提取数据,代码具备自解释性:
import csv

# 3. 必背字典读取源代码
with open('data.csv', mode='r', encoding='utf-8') as f:
    dict_reader = csv.DictReader(f)

    # 查看自动解析到的列名列表
    print("检测到字段列:", dict_reader.fieldnames)

    for row in dict_reader:
        # row 是一个字典,例如 {'id': '101', 'name': '张三', 'score': '95.5'}
        name = row['name']
        score = float(row['score'])
        print(f"学员: {name}, 成绩: {score}")
2. 必背字典写入:csv.DictWriter
使用 DictWriter 写入时,必须在初始化时明确传入 fieldnames 参数来约束列名和列序,并且要在写入数据前显式调用 writeheader() 写入首行表头:
import csv

# 4. 必背字典写入源代码
fieldnames = ['user_id', 'user_name', 'department']

data_records = [
    {'user_id': 'U1001', 'user_name': '赵六', 'department': '财务部'},
    {'user_id': 'U1002', 'user_name': '钱七', 'department': '市场部'},
    {'user_id': 'U1003', 'user_name': '孙八', 'department': '运维部'}
]

with open('output_dict.csv', mode='w', encoding='utf-8', newline='') as f:
    writer = csv.DictWriter(f, fieldnames=fieldnames)

    # 必须显式执行此行以输出首行表头
    writer.writeheader()

    # 批量写入字典列表
    writer.writerows(data_records)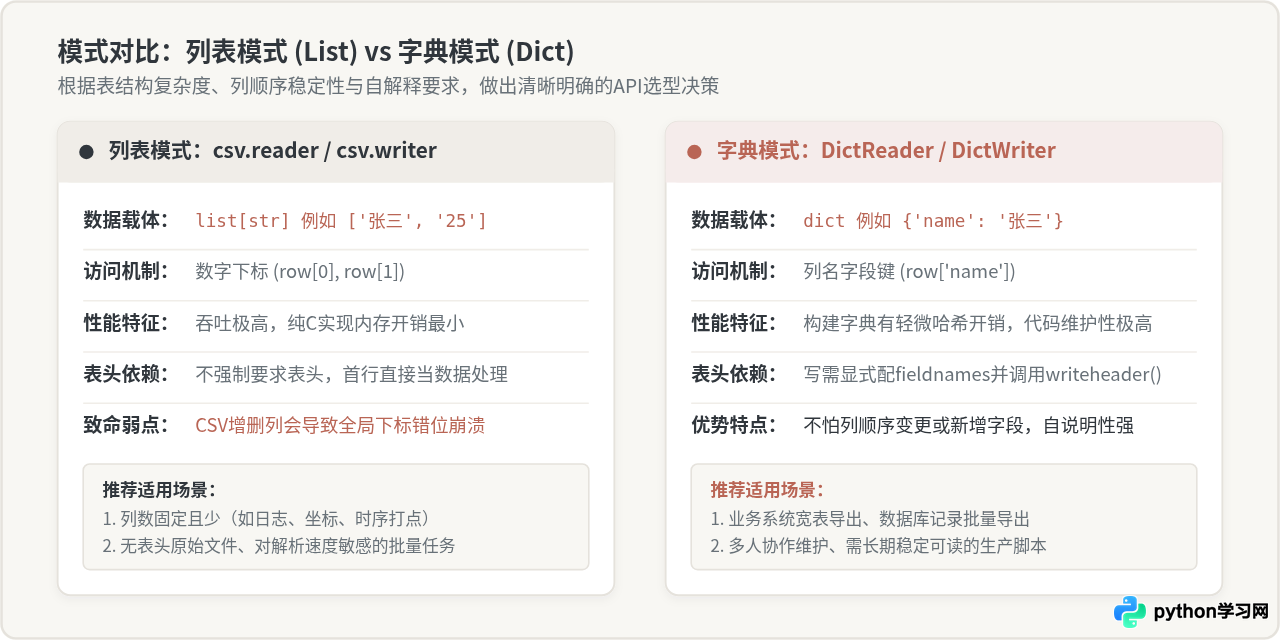
三、必背防坑机制:换行符与字符编码深度解析
许多开发者遇到过生成的CSV在打开后“每隔一行就多出一个空白行”,或者将文件分发给非技术同事使用微软Excel打开时“所有中文字符全变成问号或火星文”。这两个问题并非逻辑代码出错,而是因为没有理解底层字符协议。
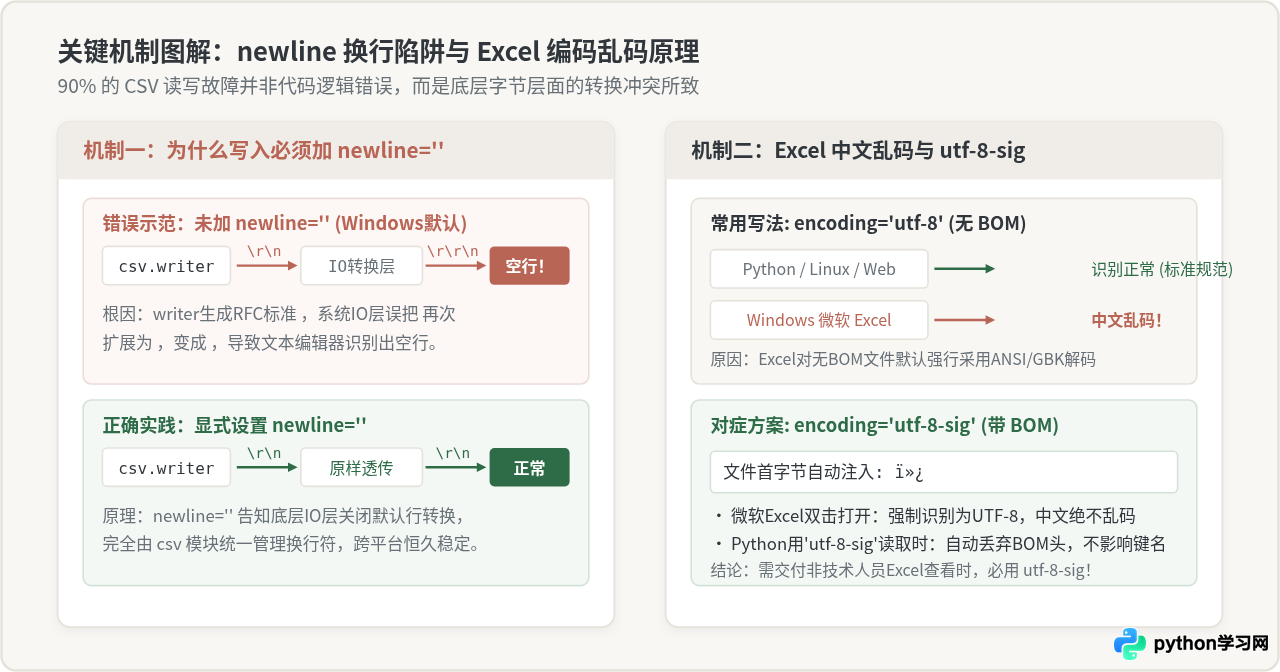
1. 为什么写入时必须设置 newline=''
按照国际通用标准 RFC 4180,CSV文件的换行规范是回车换行符
。Python的 csv.writer 在内部组装好每一行后,会自动在其末尾附带
。
而在操作系统层面,Python的内置 open() 函数在默认情况下启用了通用换行符模式。在Windows平台下,底层C运行时库会自动把写入流中的每个
转换成
。
如果写入时不加 newline='',就会发生叠加转换:csv.writer 输出了
,底层的 open() 发现里面有一个
,便再次把它替换为
,最终落盘在文件里的变成了
。许多编辑器和解析器解析到连续的 与
时,就会将其当成两行,从而产生多余的空白空行。加上 newline='' 之后,底层文本流便不再篡改换行符,由 csv 模块完全管控。
2. 为什么给Excel查看时推荐 encoding='utf-8-sig'
标准的 utf-8 文件是不带 BOM(字节顺序标记,Byte Order Mark)的纯文本。然而,Windows平台下的微软Excel在直接双击打开 .csv 文件时,出于历史兼容性考虑,默认会使用操作系统的本地ANSI代码页(例如简体中文Windows下的 GBK / CP936)进行解码。此时,UTF-8编码的中文字节就会被误认为GBK编码,从而呈现为完全不可读的乱码。
如果你的CSV文件需要交付给人用Excel直接双击查看,应当在 open() 中将编码指定为 encoding='utf-8-sig'。该编码会在文件最开头写入三个字节的签名 。Excel读取到该签名后,便会强制切换至UTF-8模式渲染,中文显示完美无瑕。
四、特殊场景进阶与避坑法则
1. 严禁用 str.split(',') 代替 csv.reader
CSV绝非简单的“逗号拼接文本”。当某个单元格本身包含逗号(例如英文句子 "Beijing, China")或者包含双引号、回车换行符时,RFC 4180规范要求必须使用双引号将该字段完整包裹起来,并且内部的双引号使用双重双引号 "" 进行转义。
如果使用简单的 line.split(',') 切割字符串,遇到这类内容时列数会瞬间分裂错位,导致下游数据全面污染。内置 csv 模块已在底层的C加速扩展中严格实现了标准解析,能够透明处理所有嵌套逗号与转义引号。
2. 处理制表符 TSV 或分号分隔文件
如果遇到以制表符( )或分号(;)分隔的文件,无需寻找其他库,直接传入 delimiter 关键字参数即可:
import csv

# 读取制表符分隔的 TSV 文件
with open('data.tsv', 'r', encoding='utf-8') as f:
    reader = csv.reader(f, delimiter='\t')
    for row in reader:
        print(row)
3. 所有读出的值默认均为字符串
csv 模块本身不负责推断字段类型。无论是数字 100、浮点数 3.14 还是布尔值 True,读取出来的一律是 Python 的 str 类型。涉及数值计算、排序或比较前,必须在代码中进行显式转换,例如 int(row['age'])。
五、核心模板选型速查表
| 处理目标 | 核心工具类 | 标准打开参数 | 数据格式 | 核心优势与适用场景 |
|---|---|---|---|---|
| 简单读取 | csv.reader |
mode='r', encoding='utf-8' |
list[str] |
极致轻量,适合日志扫描、无表头文本或行索引固定的数据 |
| 简单写入 | csv.writer |
mode='w', encoding='utf-8', newline='' |
list[str] |
直接写入列表,速度极快;必须加 newline='' 防空行 |
| 结构化读取 | csv.DictReader |
mode='r', encoding='utf-8' |
dict |
首行自动映射为键,抗增删列干扰,业务脚本高可读性首选 |
| 结构化写入 | csv.DictWriter |
mode='w', encoding='utf-8-sig', newline='' |
dict |
需显式指定 fieldnames 并调用 writeheader();防乱码与空行 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















