


Python UTF-8转GBK报错UnicodeEncodeError怎么解决
详细讲解在Python中将UTF-8字符串或文本转为GBK编码时出现UnicodeEncodeError报错的根本原因、排查方法与多种实用解决方案。
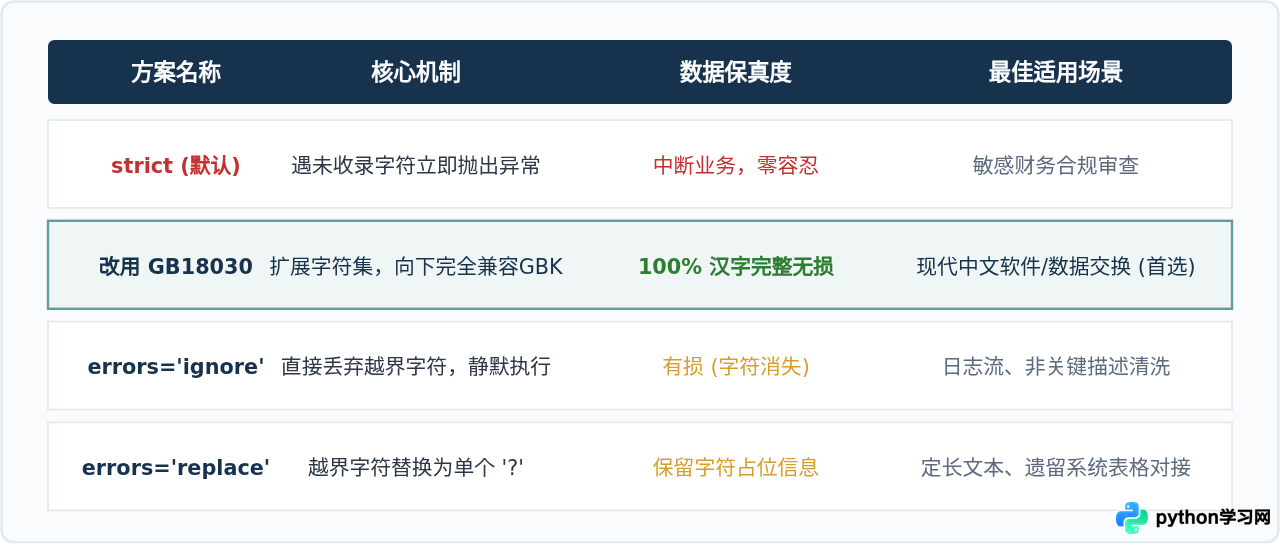
UnicodeEncodeError: 'gbk' codec can't encode character... 的核心原因,是被转换的文本中存在GBK编码表未收录的字符(如生僻汉字、Emoji表情、特殊项目符号或其它语言字符)。最彻底且通用的解决路径是将目标编码无缝升级为字符集更全的 GB18030;如果因老旧系统限制必须严格输出GBK,则可以通过配置 errors='ignore'(忽略越界字符)或 errors='replace'(替换为问号占位)完成转换。
一、报错表现与核心机制剖析
在处理数据导出、与老旧Windows系统接口对接或生成中文CSV文件时,很多开发者会编写类似以下的代码:
# 示例代码:常见的转码操作
text = "用户档案:张三 • 包含特殊标点及生僻汉字 𠮷"
gbk_bytes = text.encode('gbk')
执行后终端抛出如下异常:
UnicodeEncodeError: 'gbk' codec can't encode character '\u2022' in position 9: illegal multibyte sequence
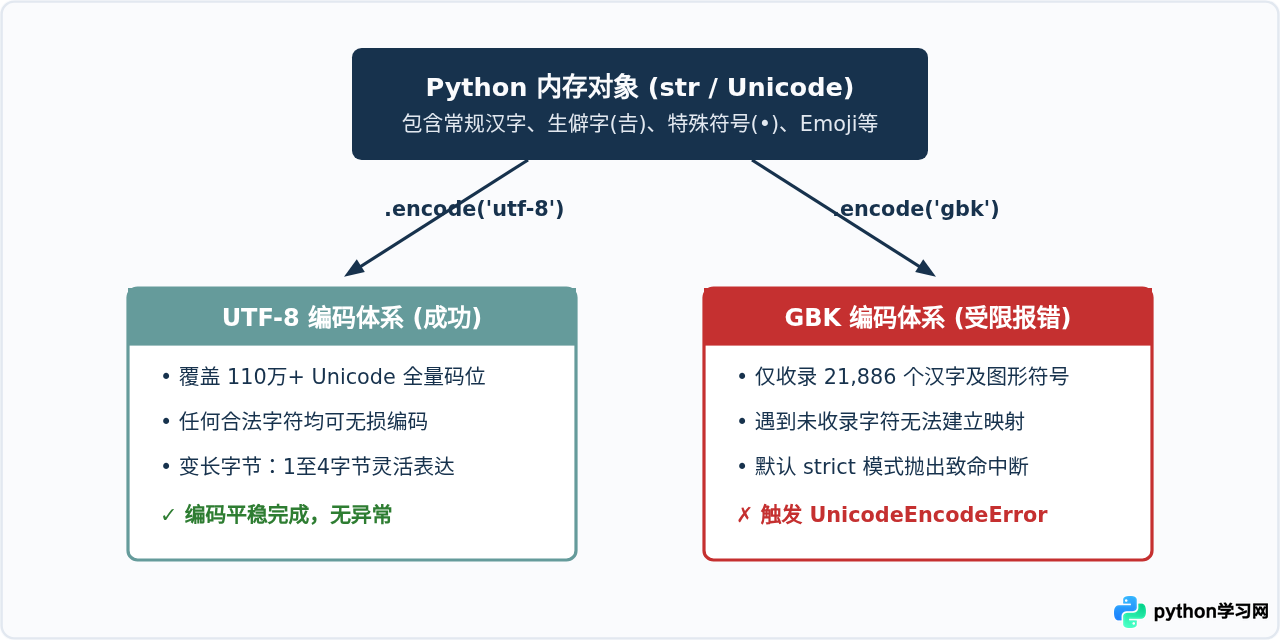
要理解这个错误,必须弄清Python 3的字符串模型。在Python内部,所有 str 对象都是纯粹的Unicode字符序列。所谓的“UTF-8转GBK”,在代码逻辑层面本质上是两步:先将UTF-8字节流解码(decode)为Unicode内存对象,再将该Unicode对象编码(encode)为GBK字节序列。
UTF-8是一种能够容纳全量Unicode字符集的可变长编码方式,而GBK仅收录了21886个汉字与图形符号。当文本中出现诸如点号 •(U+2022)、生僻字“𠮷”(U+20BB7)或各类Emoji表情时,GBK的编码映射表中根本不存在对应的码位定义。由于 encode() 默认采用严格模式(errors='strict'),Python检测到无法映射的字符便会立刻中断并抛出 UnicodeEncodeError。
二、四步排查并定位触发报错的具体字符
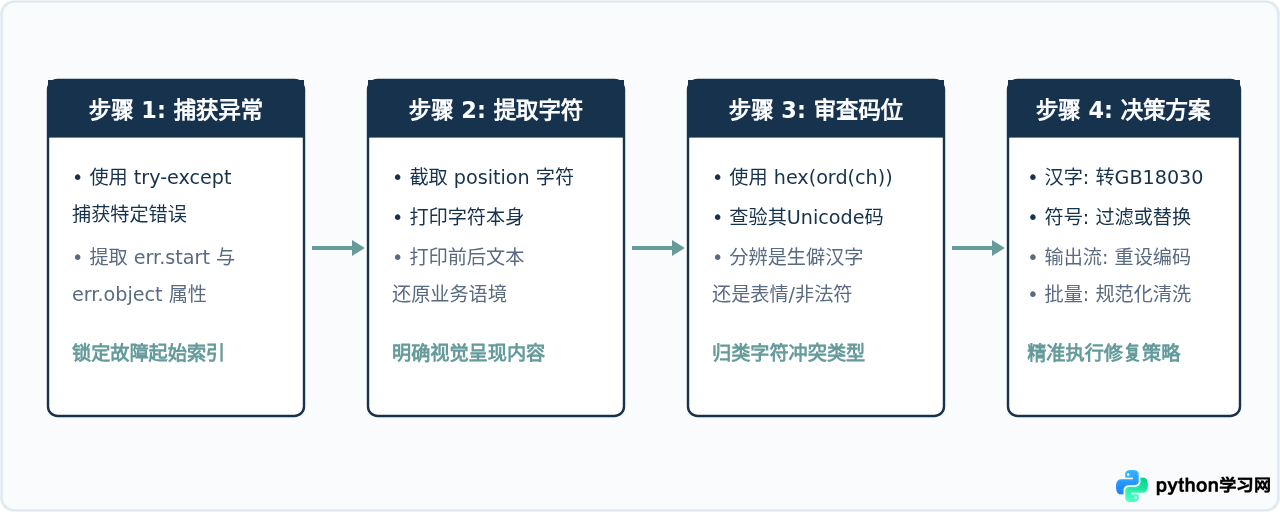
当遇到转码报错时,盲目修改全局配置往往掩盖真实数据问题。建议按以下四个步骤进行精确定位:
排查辅助脚本示例如下,可以直接运行测试数据:
# diagnostic.py - 排查非法字符
text = "客户姓名: 䶮先生 • 业务标识: VIP"

try:
    text.encode('gbk')
    print("当前文本可以完整转换为GBK")
except UnicodeEncodeError as e:
    err_char = text[e.start:e.end]
    print(f"检测到无法编码的字符: '{err_char}'")
    print(f"字符起始位置: {e.start}, 结束位置: {e.end}")
    print(f"Unicode码位: U+{ord(err_char):04X}")
    print(f"上下文片段: ...{text[max(0, e.start-5):e.end+5]}...")
三、主流解决方案与代码实现
方案一:首选升级为 GB18030(无损兼容汉字)
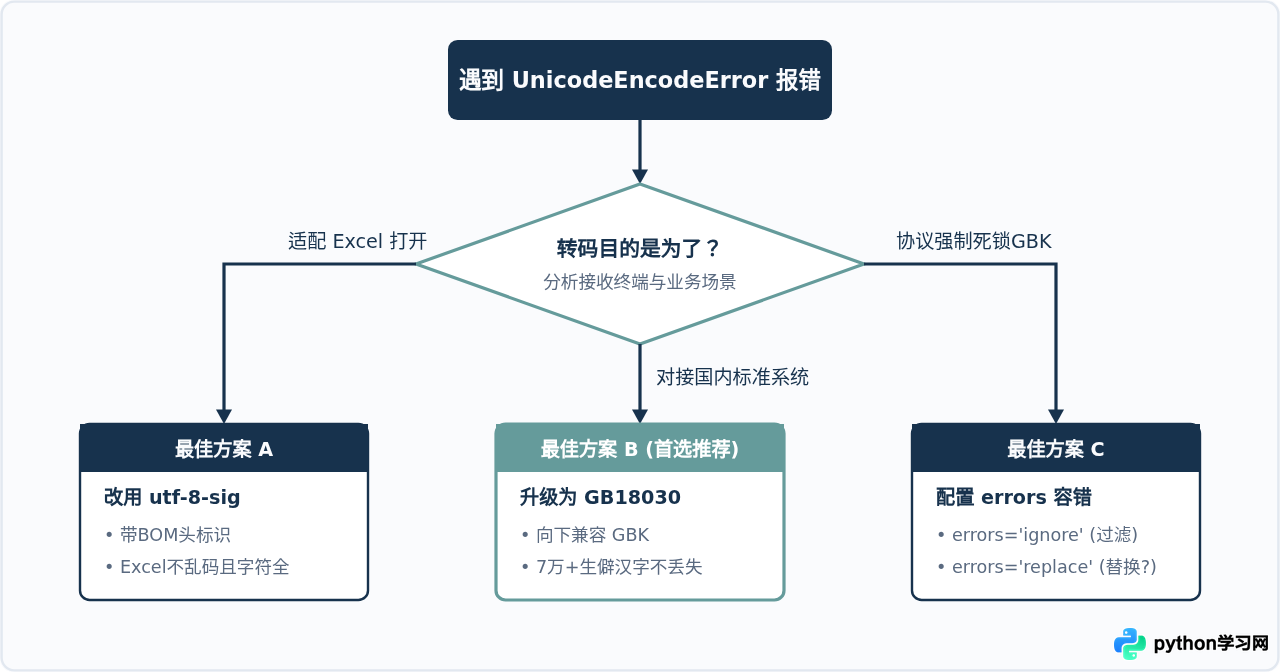
如果你的目标环境是中文Windows操作系统、银企直联系统或政企软件,通常要求的其实是“兼容中文Windows默认内码”。中国国家标准 GB 18030 完全向下兼容 GBK 和 GB2312,同时收录了包含清华简、生僻人名地名在内的7万多个汉字。
将代码中的 'gbk' 直接替换为 'gb18030',所有在GBK中报越界的生僻字均可顺利编码,且生成的字节流完全可被支持GBK的系统正常解析。
# 推荐做法:使用 GB18030 代替 GBK
text = "生僻字测试:䶮、𠮷、赟"
gb18030_bytes = text.encode('gb18030')
print("转换成功,字节长度:", len(gb18030_bytes))
方案二:配置 errors 容错策略(过滤或替换)
在部分必须严格限制输出为GBK字节集(例如某些嵌入式设备或旧款通信协议明确规定编码长度或仅认GBK码表)的场景下,可以传递 errors 参数来决定如何处置无法识别的字符:
text = "订单备注: 正常货物 • 附赠小礼品 [🎁]"

# 1. 忽略无法编码的字符 (直接丢弃)
res_ignore = text.encode('gbk', errors='ignore').decode('gbk')
print("ignore结果:", res_ignore)
# 输出: 订单备注: 正常货物  附赠小礼品 []

# 2. 替换为占位符 (转为 '?' 字符)
res_replace = text.encode('gbk', errors='replace').decode('gbk')
print("replace结果:", res_replace)
# 输出: 订单备注: 正常货物 ? 附赠小礼品 [?]

# 3. 转义为反斜杠形式 (适合日志审查)
res_slash = text.encode('gbk', errors='backslashreplace').decode('latin1')
print("backslashreplace结果:", res_slash)
# 输出包含 \\u2022 与 \\U0001f381
方案三:文件读写与标准输出流的处理
除了内存字符串编码外,很多开发者在向文件写出内容或在控制台打印时触发该错误。这是因为Python内部隐式调用了环境编码。
open() 中显式声明 encoding 与 errors,避免依赖操作系统的默认内码。
# 正确的文件导出范例
content = "包含生僻字【䶮】和项目符号 • 的报表数据"

# 写法 A:使用 GB18030 安全写入
with open("report_safe.txt", "w", encoding="gb18030") as f:
    f.write(content)

# 写法 B:若第三方软件强依赖 GBK,配置容错
with open("report_legacy.txt", "w", encoding="gbk", errors="ignore") as f:
    f.write(content)
在 Windows 控制台(CMD / PowerShell)执行脚本输出时,如果系统代码页为 936(GBK),print() 遇到特殊字符也会触发此报错。解决方案是在脚本开头重新配置标准输出流:
import sys

# 重新配置标准输出流,遇到无法打印的字符时自动替换为问号,防止进程崩溃
if sys.stdout.encoding.lower() in ('gbk', 'cp936'):
    sys.stdout.reconfigure(errors='replace')
方案四:Pandas 数据导出 CSV 避免 Excel 中文乱码
很多同学转GBK是为了让导出的CSV用Windows下的Microsoft Excel打开时不乱码。但GBK会丢失特殊字符。其实更好的做法是导出为带BOM的UTF-8(即 utf-8-sig),这样Excel既能正确按Unicode解析全部中文和Emoji,又不会报错或乱码:
import pandas as pd

df = pd.DataFrame({
    '姓名': ['张三', '䶮先生'],
    '备注': ['正常', 'VIP • 特别说明']
})

# 推荐:使用 utf-8-sig,Excel 完美打开且保留全部生僻字和符号
df.to_csv("export_excel_perfect.csv", index=False, encoding="utf-8-sig")

# 若对方系统确实只要 GBK/GB18030:
df.to_csv("export_gb18030.csv", index=False, encoding="gb18030", errors="replace")
四、排障决策路径与总结
解决 UnicodeEncodeError 不需要碰运气猜测配置。结合具体业务需求,按照以下决策树即可选择最恰当的解决方案:
五、常见问题解答与注意事项
- Q1:为什么不建议使用
sys.setdefaultencoding('gbk')?
在 Python 3 中,sys.setdefaultencoding早已被移除。Python 3 严格区分文本(str)与二进制(bytes),全局修改默认编码会破坏 Python 内部模块及第三方库对 ASCII/UTF-8 的依赖,引发不可预估的次生崩溃。应当针对具体的 I/O 点显式指定编码。 - Q2:使用
GB18030生成的文件,使用GBK读取会报错吗?
如果内容中只包含常规 GBK 范围内的字符,GBK 读取完全兼容正常;如果文件中包含了生僻字(超出 GBK 码表),读取方必须同样使用GB18030解码,否则读取方会触发UnicodeDecodeError。因此在跨系统协同中,建议接收方也规范声明使用GB18030。 - Q3:网页抓取数据转存时报错怎么处理?
网络爬虫抓取的网页往往包含形形色色的特殊字符、表情符和非中文字符,如果目标存储库是 GBK,强烈建议在数据持久化前执行清洗函数,移除\U00010000以上的四字节字符,或者显式指定errors='ignore'。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















