


Python能做什么:Web开发、数据分析与自动化场景介绍
系统介绍Python在现代工程实践中的核心应用领域,拆解Web开发、数据分析与自动化处理的技术选型、完整工作流及适用边界。
Python 是一门通用型高级编程语言。它凭借清晰直观的语法设计和庞大成熟的第三方生态,在当今软件工程中主要承担三大核心任务:构建现代 Web 后端与 API 服务、执行多维度数据分析与科学计算,以及实现跨系统与桌面环境的自动化脚本协同。本文将系统拆解这三大典型应用场景的具体运作机制、常用技术方案与适用边界。
一、Web开发领域:从微服务API到全功能业务系统
在网络应用构建中,Python 主要用于后端服务开发。它负责处理客户端发送的 HTTP/WebSocket 请求、执行业务逻辑运算、与数据库交互并返回格式化数据(如 JSON)或渲染后的 HTML 页面。Python 本身并不直接处理浏览器端的 DOM 操作,但在服务端接口与控制层展现出极高的开发效率。
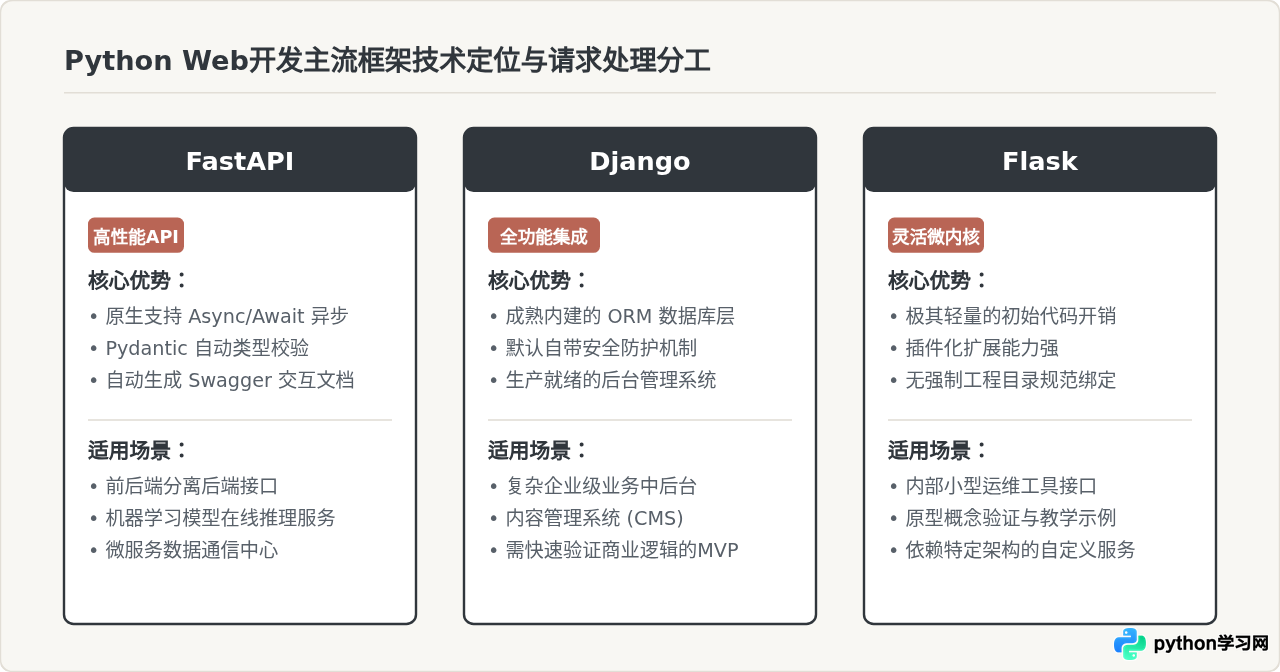
目前 Python Web 生态根据架构复杂度和性能侧重点,形成了三个梯队分明的主流技术路线:
- FastAPI:基于现代 Python 类型提示(Type Hints)与
asyncio异步并发设计的 API 框架。原生集成 Pydantic 数据验证与 OpenAPI(Swagger)自动文档生成,适合高并发、纯接口型微服务与前后端分离系统。 - Django:提供“全包式”(Batteries-Included)解决方案的企业级全栈框架。内置强大的 ORM 实体关系映射、身份认证机制、防 CSRF 注入保护及即插即用的后台管理系统(Admin),适合中大型单体架构或需快速上线完备管理体系的平台。
- Flask:遵循微内核(Micro-framework)哲学的极简框架。核心仅包含路由分发与上下文处理,开发者可以自由搭配 SQLAlchemy、Alembic 等三方库组装架构,适合轻量级原型、小型工具接口与高度定制化项目。
以下为一个典型的 FastAPI 接口定义示例。通过类型注解即可完成输入验证与自动化格式序列化:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

app = FastAPI(title="用户状态查询服务")

class QueryPayload(BaseModel):
    user_id: int
    include_details: bool = False

@app.post("/api/v1/user-status")
def get_user_status(payload: QueryPayload):
    if payload.user_id <= 0:
        raise HTTPException(status_code=400, detail="非法用户ID")

    # 模拟数据检索逻辑
    return {
        "status": "success",
        "data": {
            "user_id": payload.user_id,
            "active": True,
            "role": "editor" if payload.include_details else "standard"
        }
    }
当通过 Uvicorn 运行该服务时,开发者无需编写任何额外前端页面,访问 /docs 路由即可直接获得标准交互式调试界面,这显著降低了团队联调沟通成本。
二、数据分析与科学计算:构建标准化数据处理流水线
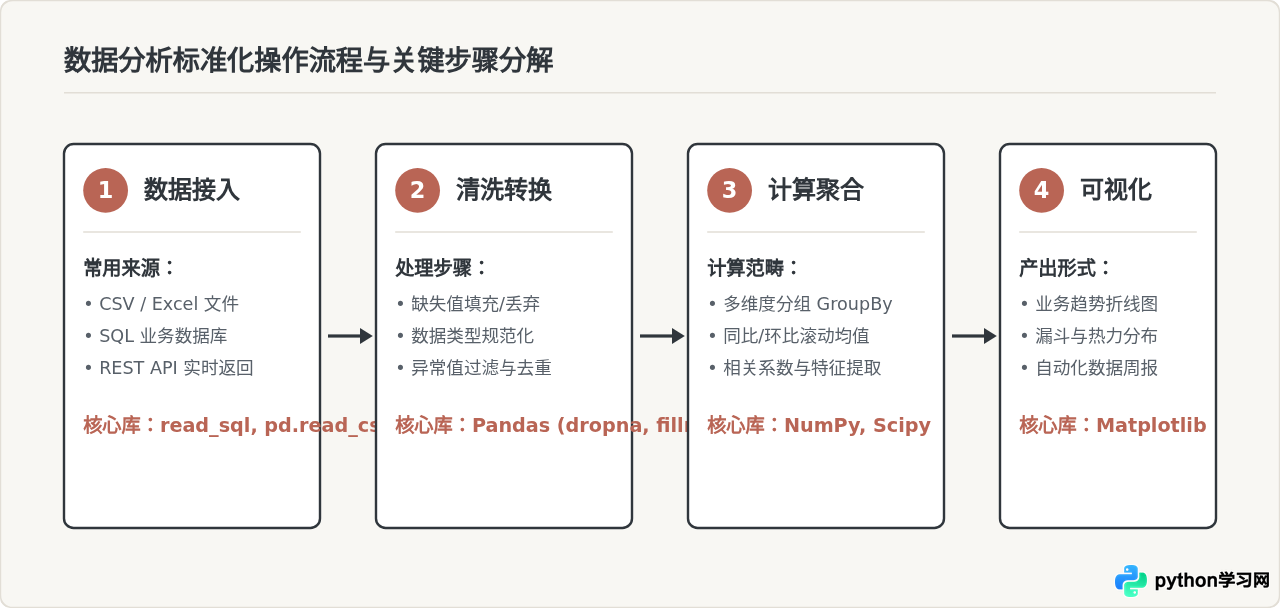
在数据科学与商业智能领域,Python 构成了整个行业事实上的基石。它通过结合底层的 C/Fortran 加速计算库与上层直观的 API,允许分析师和工程师高效完成从异构数据摄取、数据清洗转换、统计建模到可视化交付的完整闭环。
现代数据工程流水线通常由以下核心工具库分段支撑:
- NumPy:提供高性能的 N 维数组对象(
ndarray)及广播运算机制,将高频矩阵计算下沉到底层 C 语言执行,消除了纯 Python 循环的性能开销。 - Pandas:提供以表格为核心的数据结构
DataFrame与Series。支持对缺失值处理、多键合并(Merge/Join)、分组聚合(GroupBy)及时间序列分析的高级操作。 - Matplotlib & Seaborn:提供静态与统计图表渲染能力;结合 Plotly 或 Altair 可进一步导出交互式图表。
- Scikit-learn:提供经典机器学习算法集成,涵盖分类、回归、聚类与主成分降维(PCA)等工业界常用模型。
以下为一个使用 Pandas 清洗销售流水并汇总各部门业绩的典型操作示例:
import pandas as pd

# 读取原始数据集
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005],
    "dept": ["华东区", "华北区", "华东区", None, "华南区"],
    "amount": [1280.5, 450.0, None, 890.0, 3200.0],
    "is_returned": [False, False, False, True, False]
}

df = pd.DataFrame(raw_data)

# 1. 过滤退货数据并清洗缺失部门与金额
cleaned_df = df[~df["is_returned"]].dropna(subset=["dept", "amount"]).copy()

# 2. 按部门聚合总销售额与平均客单价
report = cleaned_df.groupby("dept")["amount"].agg(
    total_sales="sum",
    avg_ticket="mean"
).reset_index()

# 打印示例输出
print(report)
# 输出结果:
#     dept  total_sales  avg_ticket
# 0  华东区       1280.5      1280.5
# 1  华北区        450.0       450.0
# 2  华南区       3200.0      3200.0
相较于传统手动在 Excel 中执行 VLOOKUP 或透视表,Python 脚本将整个分析逻辑写成确定性代码,只要输入源更新,重新运行即可在毫秒级内完成数百兆数据的一键刷新,杜绝了人为手工操作失误。
三、自动化场景:消除重复劳动的高效“数字胶水”
自动化通常是许多技术团队与日常业务人员接触 Python 的第一站。Python 语法直观,操作操作系统原生接口、网络协议以及第三方软件库时阻力极小,因此常被称为“胶水语言”。它可以快速将孤立的软件模块串联成无需人工值守的流水线。
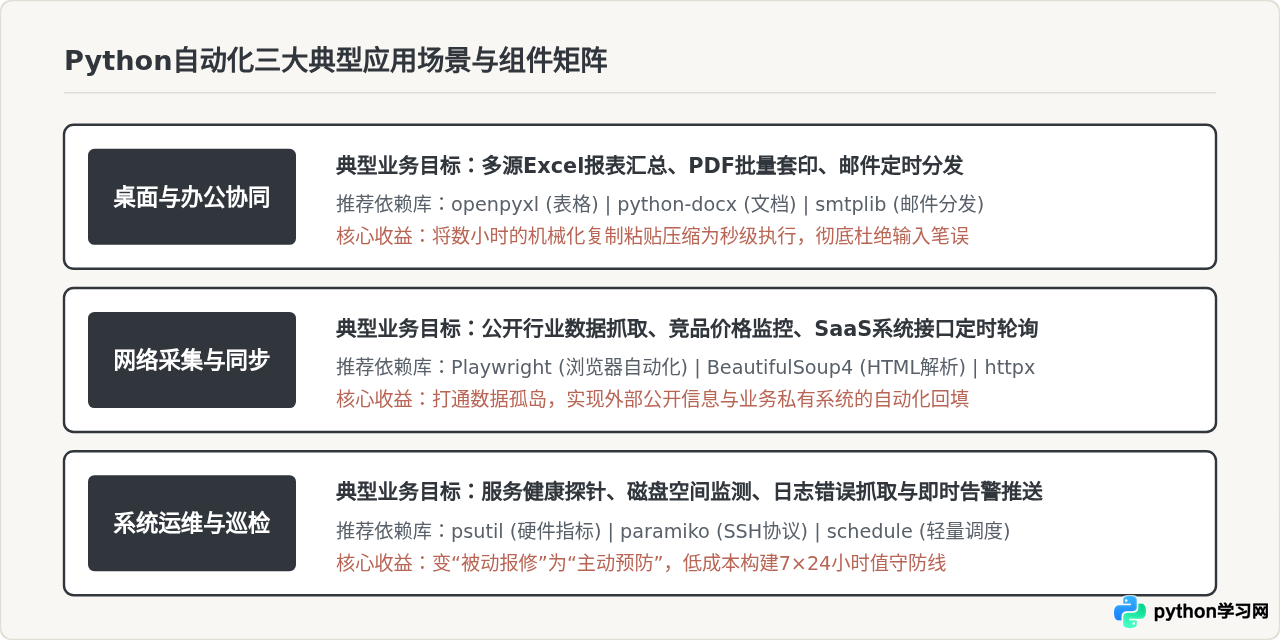
在实际落地中,自动化主要分布在以下三类核心场景:
- 办公文档与文件批处理:通过
openpyxl读写 Excel 表格、使用python-docx批量填充合同模板、利用PyPDF2合并与切分扫描件,以及通过os/pathlib模块对成千上万个目录文件进行自动化分类与正则重命名。 - 网络采集与系统数据同步:使用
requests或httpx定时抓取第三方开放 API 数据;对于需要渲染 JavaScript 的复杂动态页面,则可调用Playwright或Selenium进行无头浏览器(Headless Browser)拟真交互与结构化信息提取。 - 运维巡检与服务器调度:编写自动化巡检脚本定期检查远程服务器的磁盘占用、CPU 负载、SSL 证书到期时间,并通过
smtplib或企业微信/钉钉 Webhook 实时发送告警卡片。
例如,以下脚本演示了如何使用标准库自动化检测目标服务器的 HTTP 响应状态,并在出现异常时构造报警信息:
import urllib.request
import urllib.error

def check_endpoint_health(url: str, timeout_seconds: int = 5) -> dict:
    """对目标服务节点执行探测,返回健康状态报告"""
    try:
        req = urllib.request.Request(url, headers={"User-Agent": "HealthChecker/1.0"})
        with urllib.request.urlopen(req, timeout=timeout_seconds) as response:
            status = response.getcode()
            return {"url": url, "healthy": (200 <= status < 400), "status_code": status}
    except urllib.error.HTTPError as e:
        return {"url": url, "healthy": False, "status_code": e.code}
    except Exception as e:
        return {"url": url, "healthy": False, "error_msg": str(e)}

# 执行巡检示例
probe_result = check_endpoint_health("https://api.example.com/health")
if not probe_result["healthy"]:
    print(f"触发告警通知:服务异常,详情: {probe_result}")
四、能力边界与理性选型:Python 不适合做什么
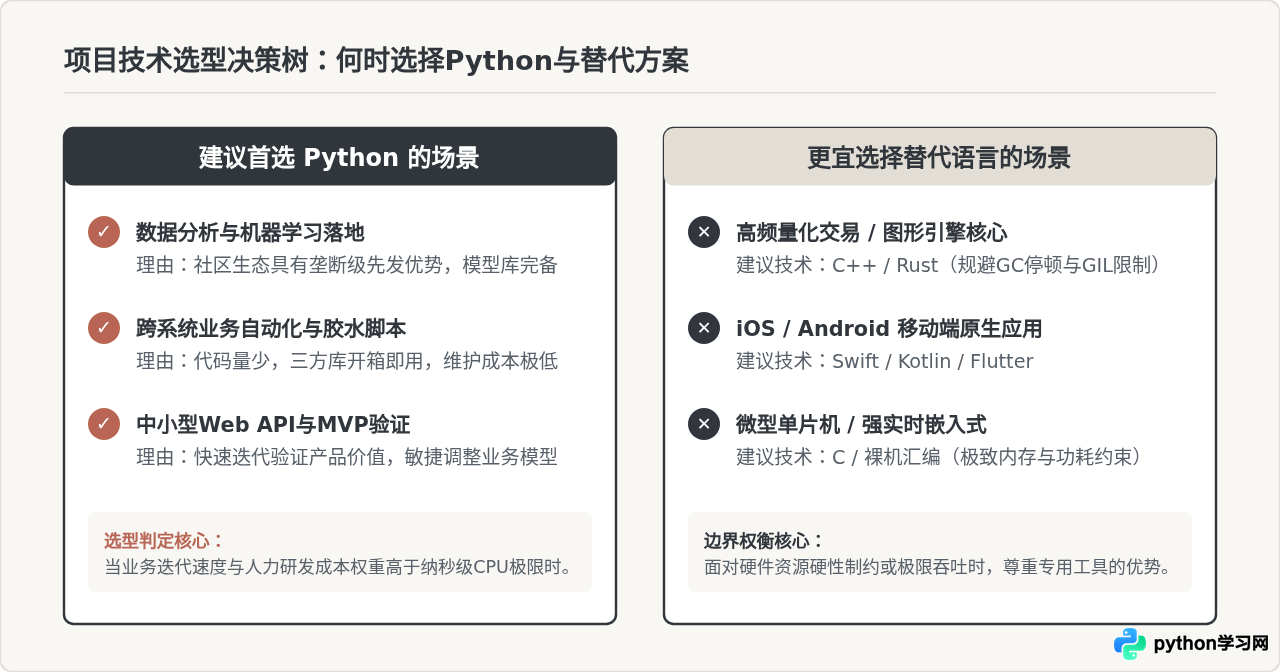
在充分肯定 Python 优势的同时,必须客观认识到这门语言在特定工程场景下的局限性。技术选型不仅要看“能做什么”,更要评估“由它来做是否划算”。
关键认知边界:Python 是一门动态类型的解释型语言,优先追求的是开发人员的生产效率(Developer Productivity),而非极限的硬件执行效率(Execution Efficiency)。
遇到以下工程诉求时,通常不推荐将 Python 作为核心实现工具:
- 高频交易与纳秒级低延迟场景:Python 的全局解释器锁(GIL,CPython 实现)以及垃圾回收(GC)机制会引入不可控的微秒级停顿。此类场景应首选 C++、Rust 或高性能 Java。
- 手机原生应用(iOS / Android)开发:尽管有 Kivy、BeeWare 等社区方案,但在系统生态集成、UI 流畅度、能耗控制和安装包体积方面,与原生的 Swift、Kotlin 以及跨平台框架 Flutter 相比差距明显。
- 强约束的嵌入式与单片机开发:除了带有充足内存的特定开发板(如运行 MicroPython 的 ESP32)用于原型实验,真正的低功耗单片机或航空/工控微控制器受制于数十 KB 的 ROM/RAM 容量,必须使用 C 或汇编编写。
总结
Python 能在软件开发与数据领域保持持久的生命力,核心在于它在“代码表达力”与“工程实用性”之间找到了极佳的平衡点。在 Web 开发中,它借助 FastAPI 和 Django 赋能敏捷的服务端构建;在数据科学中,它通过 Pandas 和 NumPy 成为分析流水线的事实标准;在日常工程运维中,它充当低成本联通不同系统的自动化桥梁。理解它的优势场景与客观边界,是根据具体业务目标做出理性技术决策的关键所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















