



在写统计 SQL 时,很多人第一次遇到 AVG(SUM(x)) 报错,都会先怀疑是不是括号、分组或数据类型出了问题。实际上,这类写法在 SQL 标准里就不成立;真正要解决的问题,不是“怎么把它写过”,而是先分清你到底要的是哪一层聚合结果,再选对派生表、CTE 或窗口函数的写法。
为什么聚合函数不能直接嵌套
AVG(SUM(x)) 一定报错,并不是某个数据库厂商的特殊限制,而是 SQL 标准层面的硬性规则。解析器在语法分析阶段就会拒绝这种写法,因此无论数据内容如何、括号怎么调整,都不会通过。
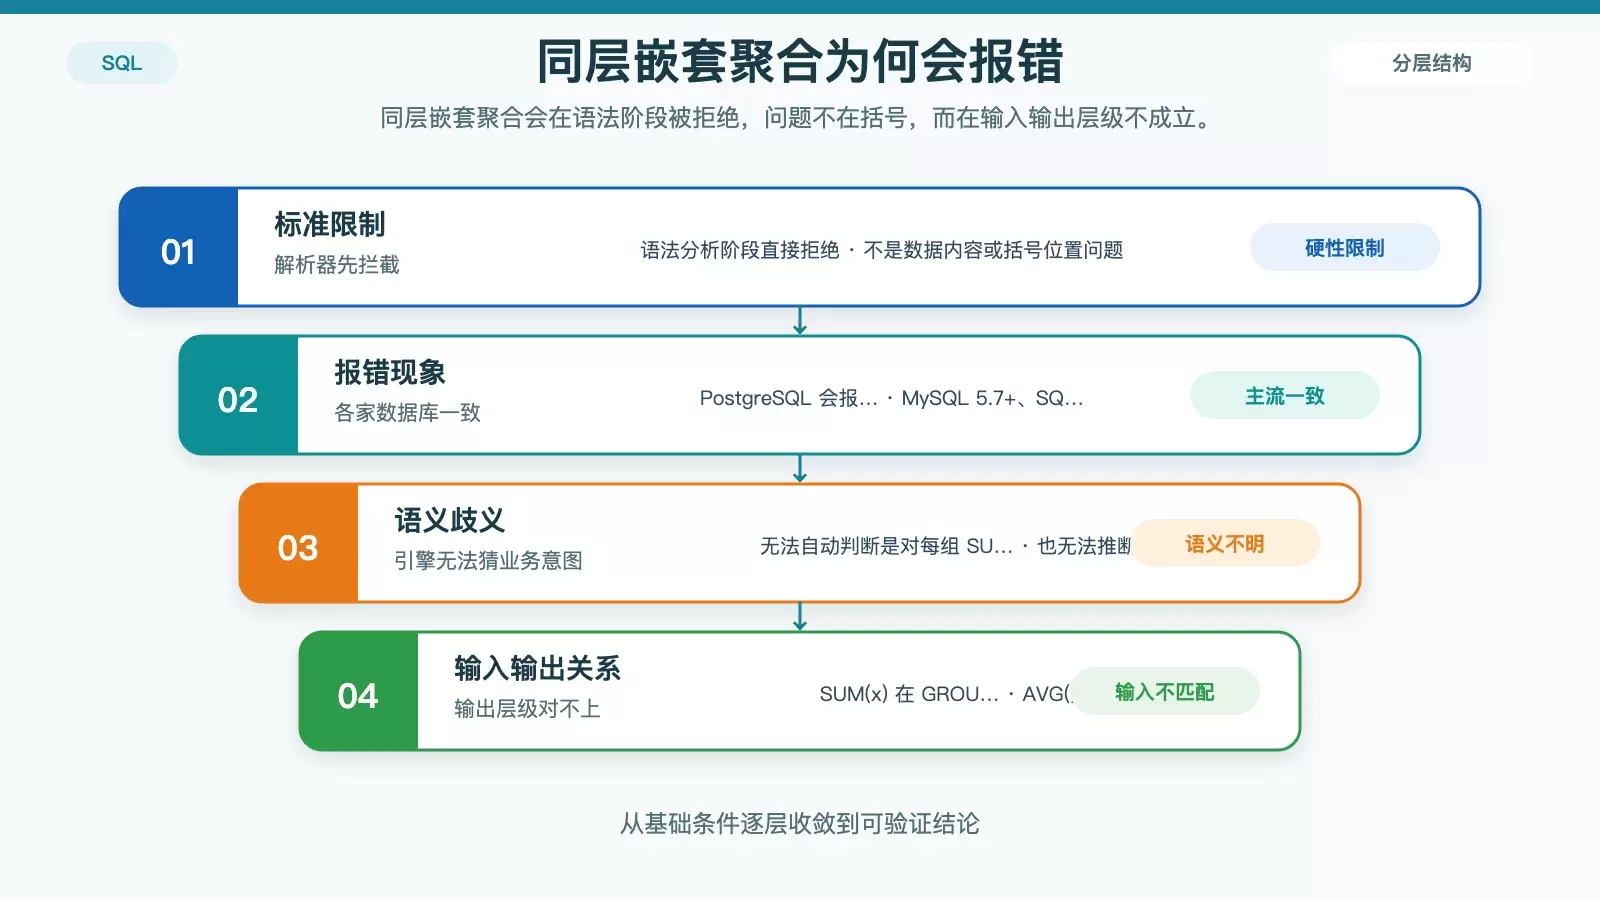
主流数据库都会给出类似错误,例如 PostgreSQL、MySQL 5.7+、SQL Server、Oracle 常见的报错包括:
aggregate function calls cannot be nested
Invalid use of aggregate function
报错发生在语法分析阶段
关键点在于:同一 SELECT 层级里,聚合函数不能直接把另一个聚合函数当参数。也就是说,即使你已经写了 GROUP BY,也不能在这一层继续写 AVG(SUM(x))。
根本问题是语义并不明确
从语义上看,数据库无法自动判断你到底想表达哪一种计算:
- 先按组求
SUM(x),再对这些“每组总和”求平均; - 还是先汇总全表,再按另一套规则求平均。
再往下看,SUM(x) 在 GROUP BY 之后输出的是标量结果,通常是“每组一个值”;而 AVG() 需要的输入是一组值。在同一个层级里,这个“一组”并没有被单独构造成新的结果集,所以引擎没有合法的输入来源。
几个常见误解
COUNT(DISTINCT col)看起来像嵌套,其实不是;它是单个聚合函数的语法糖。AVG(SUM(x)) OVER()依然非法,窗口函数不会放宽嵌套聚合的限制。- 加上
GROUP BY也无效,只要仍处于同一个SELECT层级,限制就还在。
两层聚合该怎么写:优先用子查询或派生表
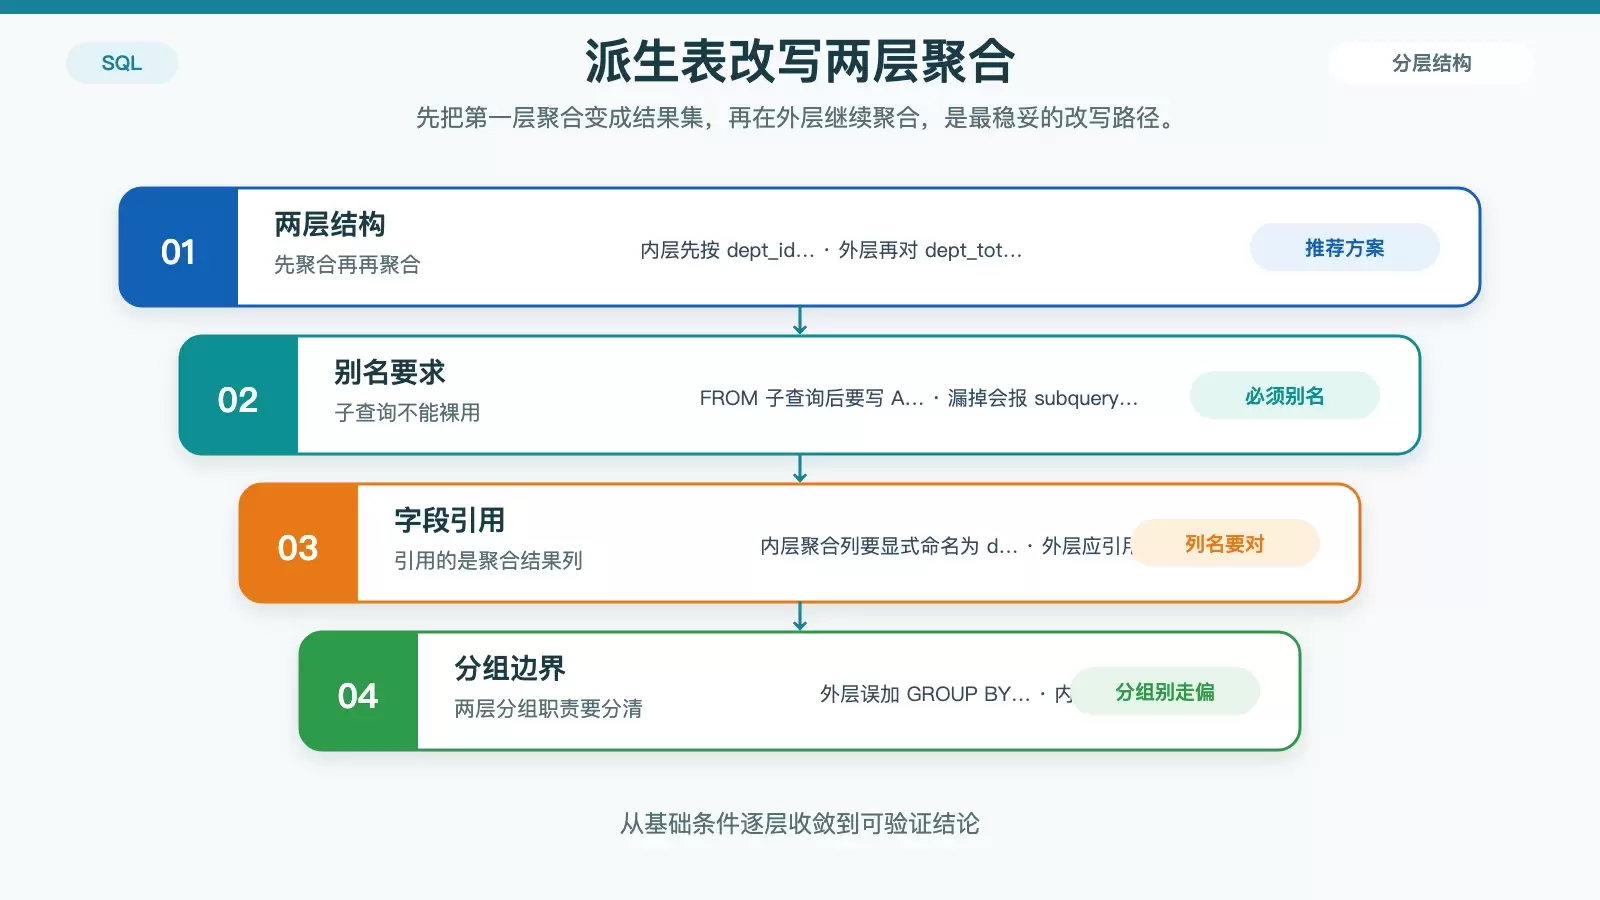
如果你的目标确实是“先按组求和,再对这些组结果求平均”,最通用的做法是先把第一层聚合写进子查询或派生表,再在外层做第二次聚合。
SELECT AVG(t.dept_total)
FROM (
  SELECT dept_id, SUM(sales) AS dept_total
  FROM orders
  GROUP BY dept_id
) AS t;
这段 SQL 的关键不是“多包了一层”,而是明确地把第一层聚合结果变成了一个新的结果集。外层 AVG() 面对的输入,才真正是一列可聚合的数据。
派生表最容易踩的 4 个坑
- 子查询必须带别名,例如
AS t;漏掉时会报subquery in FROM must have an alias。 - 内层
SELECT要显式输出并命名聚合列,例如SUM(sales) AS dept_total;外层引用的必须是t.dept_total,不能写成t.sales。 - 如果外层再加
GROUP BY,查询语义就变了,往往不再是“对聚合结果再聚合”。 - 内层
GROUP BY缺失或漏列时,轻则统计口径偏差,重则直接报错。
CTE 和窗口函数,边界分别在哪里
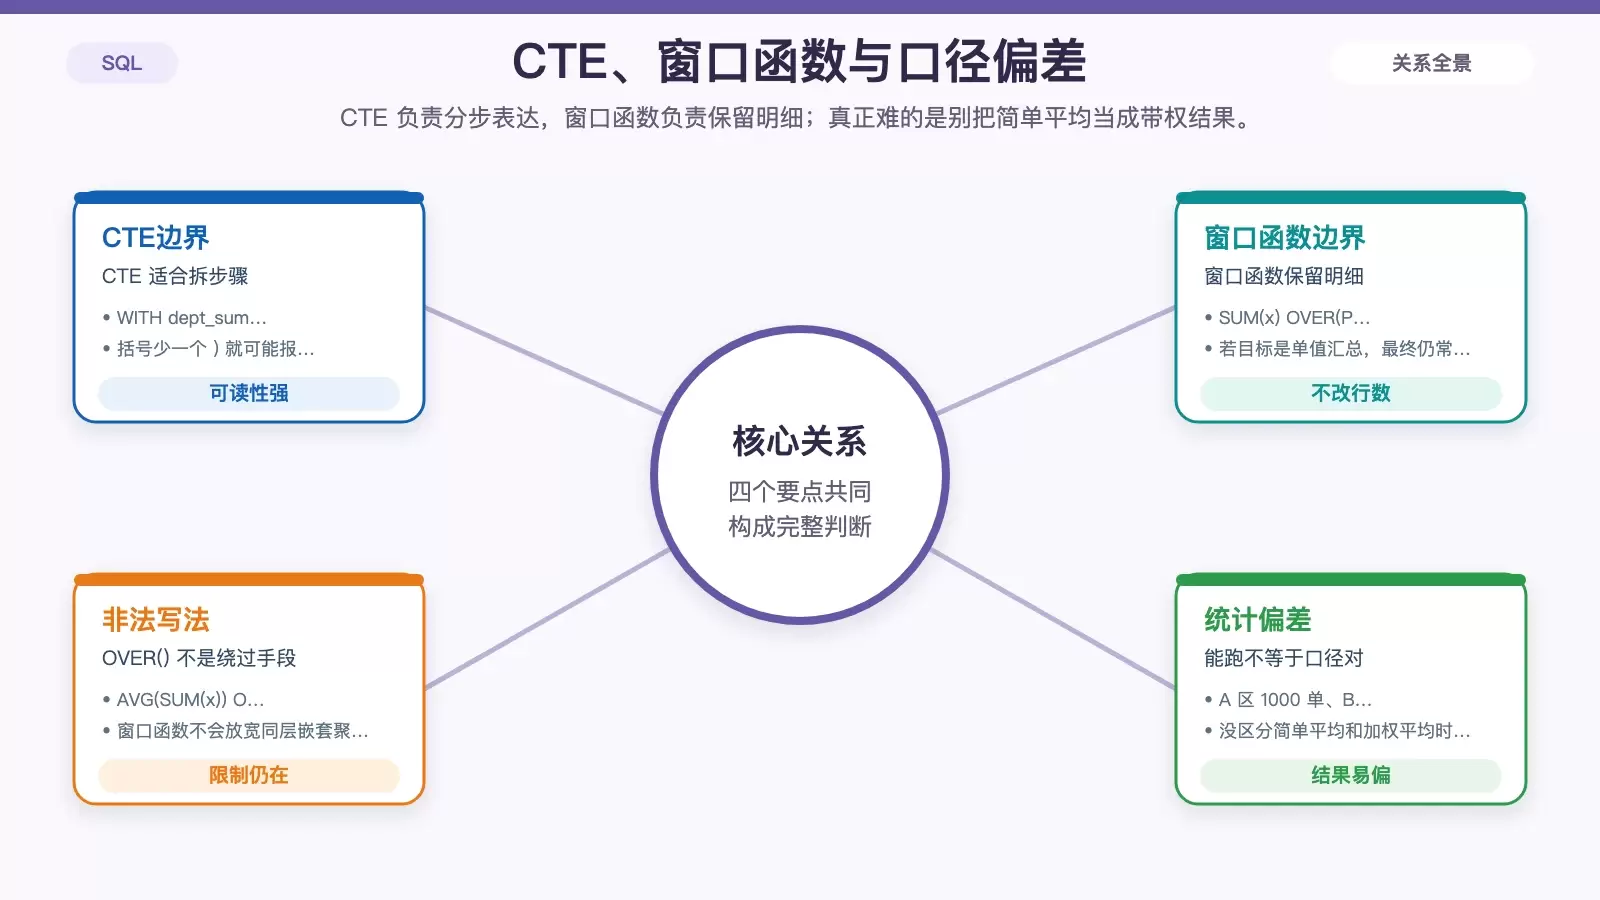
当查询变长、第一层聚合逻辑较复杂时,CTE 通常比内联子查询更容易读;而窗口函数适合在保留明细行的同时追加统计列。但它们解决的问题并不完全相同,也不能互相替代。
CTE 更适合表达分步计算
WITH dept_summary AS (
  SELECT dept_id, SUM(sales) AS dept_total
  FROM orders
  GROUP BY dept_id
)
SELECT AVG(dept_total)
FROM dept_summary;
这类写法的优势是层次清晰,但也有两点很常见的错误:
WITH dept_summary AS (SELECT ... GROUP BY dept_id)的括号必须严格闭合,少一个)就可能报syntax error, expect RPAREN。- CTE 名称不要与真实表重名,否则在 PostgreSQL 中可能优先被解析为基表,带来歧义。
窗口函数能保留明细,但不能绕过限制
窗口函数常被误认为可以“顺手”解决嵌套聚合问题,但它不能突破同层聚合限制。像下面这种写法依然不合法:
AVG(SUM(x)) OVER()
正确思路是先得到窗口汇总列,再在新的层级继续处理。例如先写:
SUM(x) OVER(PARTITION BY dept_id)
然后根据目标,决定是否再包一层子查询或 CTE 做下一步统计。
还要注意一点:窗口函数只是在原结果上追加列,并不会减少行数。如果你的目标是得到单值汇总,例如“所有部门总和的均值”,最终通常仍要借助子查询或 CTE。
`AVG(AVG(x))` 为什么看似能跑,结果却可能不可信
相比直接报错的 AVG(SUM(x)),更隐蔽的问题是另一类“能运行但口径错了”的 SQL。很多人会用 AVG(avg_per_group) 替代自己真正需要的 AVG(sum_per_group),语法没问题,但业务含义已经变了。
简单平均和加权平均不是一回事
假设两个区域的订单量差异很大:
- A 区有 1000 单
- B 区有 10 单
如果你计算“区域均值的均值”,A 和 B 会被等权对待;但如果你的业务问题关心总量贡献,这种算法会掩盖真实分布。很多时候,真正需要的是基于总量或样本量的加权口径,而不是简单平均。
真正该检查的是分组粒度和业务口径
这类问题最麻烦的地方在于:数据库不会报错,结果还看起来很像“合理答案”。因此在改写两层聚合时,至少要先确认两件事:
- 你做的是简单平均,还是带权重的平均;
- 分组粒度是否和业务口径一致,例如按部门、区域、订单还是用户来聚合。
很多统计偏差,并不是 SQL 写不出来,而是第一层和第二层聚合对应的业务对象根本不同。
写两层聚合前,先问清楚这 3 个问题
遇到聚合嵌套需求时,可以先按下面的顺序判断:
- 第一层聚合的结果,是否应该先单独变成一个结果集;
- 最终是要保留明细行,还是只要单值汇总;
- 第二层聚合到底是在做再汇总,还是在改写统计口径。
如果目标是“对第一层聚合结果再聚合”,通常优先选择派生表或 CTE。窗口函数适合补充明细视角,但不负责突破 SQL 标准对嵌套聚合的限制。















